本文属于《学生入门》系列 · 难度:学生入门 · 篇幅:约 2600 字课程
能用自己的话解释考试不能提前看答案,并完成一个可核查的小练习。
1. 学习目标与术语
本课程为独立编写的AI学习资料,不是官方教材。
学习目标
能用自己的话解释考试不能提前看答案,并完成一个可核查的小练习。
术语解释
样本:一条用于学习或评估的记录;模型:按一定规则计算输出的系统。本课专用术语在正文首次出现时单独解释。
2. 生活中的例子
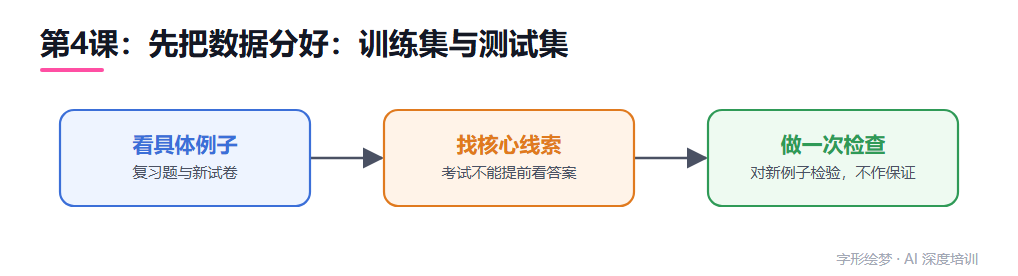
想象你为了准备数学考试,先做了一套老师发的复习题。做完后,你对照答案,发现自己在计算分数时容易出错,于是你专门练习了这部分。这时,复习题就像“训练集”,它帮你发现弱点并调整学习策略。 接下来,期末考试发下来了,这是一套你从未见过的新试卷。你根据之前练习的经验去答题。这套新试卷就是“测试集”。它的作用是检验你的真实水平,看看你学到的方法在没见过的题目上是否还管用。 这里有一个假设示例:假设你做了10道复习题,错了2道,正确率80%。但这不代表你在100道新试卷上一定对80道。因为新试卷可能包含你没练过的题型。如果复习题里全是加法,而新试卷全是几何,你的80%正确率就失效了。 请注意,这个例子只是假设,不代表任何真实学生的成绩。关键点在于:复习题(训练集)是用来“学”的,新试卷(测试集)是用来“考”的。你不能在考试时翻书看答案,也不能在测试前偷偷把测试题混进复习题里反复做,否则你就无法知道自己在真正的新问题上表现如何。这就是为什么我们要把数据分开:一部分用来学,一部分用来公正地检验。
3. 一步步理解核心方法
想象你准备数学考试。为了真正学会解题,你先用老师发的“复习题”(训练集)反复练习。这些题你见过,知道答案,目的是掌握方法。 考试当天,你拿到一套全新的“试卷”(测试集)。这套题你从没见过,答案也未知。你的成绩完全取决于你之前掌握的方法是否有效,而不是你背了多少原题。 在机器学习中,逻辑完全一样。我们把数据分成两部分:
- 训练集:像复习题,模型用它来“学习”规律。
- 测试集:像新试卷,模型用它来“考试”,检验它是否真的学会了,而不是死记硬背。
如下图所示,数据被清晰地分成两堆,互不重叠。 为什么必须分开?因为如果让模型在“新试卷”上也反复练习,直到它做对为止,那它就不是在“学习”,而是在“背答案”。这样测出来的高分是假的,换个新题它可能就错了。 举个小数值例子(假设示例): 假设你有10道数学题。
- 你拿8道当复习题(训练集),自己算,对答案,改错。
- 你留2道当新试卷(测试集),先不看答案,独立做完。
- 最后看这2道新题的对错率,才是你真实水平的估计。
如果你把10道题全拿来练,直到全对,那你的“100%正确率”毫无意义,因为你只是在记忆,不是在学习方法。 关键点:
- 训练集用于“学习”,允许看答案。
- 测试集用于“评估”,必须保持“新鲜”,不能提前看答案或反复调整模型直到测试集得分高。
- 两者必须互斥,不能混用。
这不是比喻,而是基本规则。就像考试不能翻书,模型评估也不能用测试集来“训练”。否则,你得到的分数反映的是“记忆能力”,而不是“学习能力”。 记住:测试集是“一次性”的公正裁判。一旦它被用来调整模型,它就失去了公正性,不能再代表真实表现。
4. 用假设示例动手理解
假设示例:小明复习数学。他做了100道复习题,错了5道,得分95分。这是“训练集”,用来调整学习方法。接着,他做了一套从未见过的新试卷,共50题,错了2道,得分96分。这是“测试集”,用来检查方法是否真的有效。 注意:这里所有数字都是假设示例,仅用于演示概念,不代表真实考试结果。单位统一为“题数”和“分数”,避免混淆。 关键点:测试集必须独立、未见过。如果小明在复习时偷偷看了新试卷的答案,再据此“优化”答题策略,那么新试卷就不再是公平的新数据。这就像考试前偷看答案,成绩不能反映真实水平。 为什么重要?机器学习模型也一样:如果在训练过程中反复查看测试集并据此调整参数,模型会“记住”测试题,而不是学会通用规律。这叫“数据泄漏”,会导致评估结果虚高,无法预测它在真正新数据上的表现。 类比适用范围:复习题和新试卷的类比适合理解“训练”与“评估”的分离原则。不成立处:真实机器学习任务中,数据分布可能变化,且模型复杂度远高于学生解题策略;此外,学生可以主动反思错误,而模型只能依据算法更新参数。 记住:测试集是“新试卷”,必须保持“未见”状态,才能公正评估模型泛化能力。
5. 常见误区与适用边界
把数据分成训练集和测试集,就像考试不能提前看答案。这个类比很直观,但要注意:它只是帮助理解的比喻,不是严格的数学定义。在真实场景中,数据划分是为了模拟模型面对“没见过”的新情况时的表现,而不是简单地把题目藏起来。 一个常见误区是:如果我在测试集上反复调整模型,直到分数很高,就以为模型真的学得好。其实这就像你偷偷看了答案再改作业,分数高不代表你真会做题。这种做法叫“测试集泄漏”,会让评估结果虚高,无法反映模型对新数据的真实能力。 另一个误区是:因为一次划分后模型表现不错,就认为它在所有情况下都可靠。但数据划分只是随机抽样,不同划分方式可能带来不同结果。就像同一套复习题,换个顺序你可能做对更多,但这不意味着你掌握了全部知识。 所以,记住两点:第一,类比帮你入门,但不能替代严谨定义;第二,单次实验结果不能推出无条件保证。要更可靠地评估模型,需要多次划分、多次实验,看结果是否稳定。这才是科学评估的基础。
6. 小练习与参考答案
小练习
能否一边看测试答案一边选最好的模型?
参考答案
不能;这样会泄漏测试信息,无法公正评估新数据表现。
请说明答案的适用边界,不把模型输出当作事实保证。
参考文献
- Google for Developers. Machine Learning Crash Course. https://developers.google.com/machine-learning/crash-course 来源
Paragoger衍生者AI训练营。发布者:稻草人,转载请注明出处:https://www.shxcj.com/archives/10415