本文属于《AI 深度培训》系列 · 难度:专家 · 篇幅:约 7000 字
混合专家模型(MoE)通过稀疏激活打破参数规模与计算量的线性绑定,实现“参数多、计算少”的条件计算。本文深入剖析其核心机制:从门控路由的数学形式,到负载均衡损失的稳定性设计,再到专家并行中的通信优化。我们将梳理从 Switch 到 DeepSeekMoE 的架构演进,解析路由坍塌成因及工程落地陷阱,助你理解 MoE 如何在大模型中高效扩展表达能力并突破算力瓶颈。
1. 导读:参数多、计算少
在大模型训练与推理中,我们常面临一个核心矛盾:模型容量(参数数量)决定了其拟合复杂分布的能力,而计算成本(FLOPs)决定了训练速度与推理延迟。传统的稠密(Dense)Transformer 架构中,每个输入 token 都会流经所有参数。这意味着,若将参数量扩大 K 倍,前向传播的计算量也将线性增长 K 倍。对于万亿参数规模的模型,这种线性关系使得计算资源成为不可逾越的瓶颈。 混合专家模型(Mixture-of-Experts, MoE)提供了一种“条件计算”(Conditional Computation)的解决方案。其核心直觉是:让模型拥有巨大的参数库,但每个 token 只激活其中的一小部分。通过引入可学习的门控机制(Gating),模型能够根据输入内容的语义,动态选择最相关的专家子网络进行处理。这种稀疏激活机制打破了参数规模与计算量之间的线性绑定,使得我们在不显著增加推理延迟的前提下,极大地扩展了模型的表达能力。 这一思想并非凭空出现,而是源于对稀疏门控机制的早期探索(Shazeer et al., 2017)。然而,早期的 MoE 实现存在路由不稳定、专家负载不均等问题,导致训练难以收敛。随着 GShard 等工作在自动分片与条件计算上的改进(Lepikhin et al., 2020),以及 Switch Transformer 通过简化路由结构(top-1 选择)和引入负载均衡损失实现了万亿参数模型的稳定训练(Fedus et al., 2021),MoE 架构逐渐走向成熟。近年来,Mixtral 等模型进一步验证了 MoE 在推理效率与性能平衡上的优势(Jiang et al., 2024)。 理解 MoE 不仅仅是掌握一种网络结构,更是理解现代大模型如何突破算力限制的关键。本文旨在深入剖析 MoE 的核心机制,帮助读者掌握以下要点:
- 路由机制:门控网络如何决策 token 流向,以及 top-k 选择策略的数学形式。
- 稳定性问题:路由坍塌(Routing Collapse)的成因,以及负载均衡损失(Load Balancing Loss)的设计原理。
- 系统实现:专家并行(Expert Parallelism)中的通信模式,以及 all-to-all 操作在分布式训练中的作用。
- 设计演进:从 Switch 的极简 top-1 到 Mixtral 的 top-2,再到 DeepSeekMoE 的细粒度专家划分与共享专家策略(Dai et al., 2024)。
通过本文,你将不仅了解 MoE “是什么”,更将理解其“为什么有效”以及“如何在工程落地中避免常见陷阱”。我们将从最基础的门控逻辑出发,逐步推导至复杂的并行计算与负载均衡策略,为后续深入阅读相关文献与代码实现奠定坚实基础。
2. 门控与 top-k 路由
在混合专家(MoE)架构中,核心机制在于如何根据输入动态选择计算路径。传统稠密模型中,所有参数参与每一次前向传播,计算量与参数量呈线性正比。MoE 通过引入“条件计算”打破了这一限制:仅激活部分专家网络,从而在保持模型容量巨大的同时,显著降低单次推理的 FLOPs 需求。 路由过程始于门控网络(Gating Network)。对于输入向量 x,门控层首先计算所有专家的原始打分。设专家总数为 N,门控权重矩阵为 W_g,则原始得分向量 z 定义为:
z = W_g · x
随后,通过 softmax 函数将得分归一化为概率分布 g(x):
g(x) = softmax(z)
此时,g(x) 是一个长度为 N 的向量,其中每个元素 g_i 表示输入 x 路由到第 i 个专家的概率。然而,若直接对所有专家进行加权求和,计算量将退化为稠密模型。因此,MoE 采用 top-k 稀疏策略:仅保留概率最高的 k 个专家,并将其余专家的门控值置零。 在得到 top-k 专家集合 S 后,需要对这些被选中的专家进行重新归一化,以确保输出权重之和为 1,保持概率分布的合法性。归一化后的门控值 g'_i 计算如下:
g'_i = fracg_iΣ_j ∈ S g_j, i ∈ S
最终,MoE 层的输出 y 是这 k 个专家输出的加权和:
y = Σ_i ∈ S g'_i · E_i(x)
其中 E_i(x) 表示第 i 个专家网络对输入 x 的变换结果。如下图所示,该机制直观展示了输入如何被分流至特定的专家子网络。
def moe_layer(x, experts, gate_weights, top_k=2):
    # x: [batch, seq_len, d_model]
    # gate_weights: [d_model, num_experts]
    # 1. 计算原始门控分数
    logits = x @ gate_weights  # [batch, seq_len, num_experts]
    # 2. 获取 top-k 索引及对应的概率
    # 注意:实际工程中通常先取 top-k 再 softmax,或 softmax 后取 top-k
    # 这里演示 softmax 后取 top-k 并重新归一化
    probs = softmax(logits, dim=-1)
    top_k_probs, top_k_indices = torch.topk(probs, k=top_k, dim=-1)
    # 3. 重新归一化 top-k 概率
    sum_top_k = top_k_probs.sum(dim=-1, keepdim=True)
    normalized_probs = top_k_probs / sum_top_k
    # 4. 执行专家计算并加权求和
    # 实际实现中,为了效率,通常使用 all-to-all 通信将 token 分发到对应专家
    # 此处为逻辑伪代码,展示数学本质
    output = torch.zeros_like(x)
    for i in range(top_k):
        expert_idx = top_k_indices[..., i]
        # 假设 experts 是一个函数列表或张量,实际需根据 expert_idx 路由
        expert_out = experts[expert_idx](x)
        output += normalized_probs[..., i:i+1] * expert_out
    return output
这种设计使得模型能够根据输入内容的语义特征,动态调用最相关的子网络。例如,处理代码片段时可能激活擅长逻辑推理的专家,而处理文学文本时则激活擅长语言流畅度的专家。这种稀疏激活机制是 MoE 实现“参数多、计算少”的关键所在。
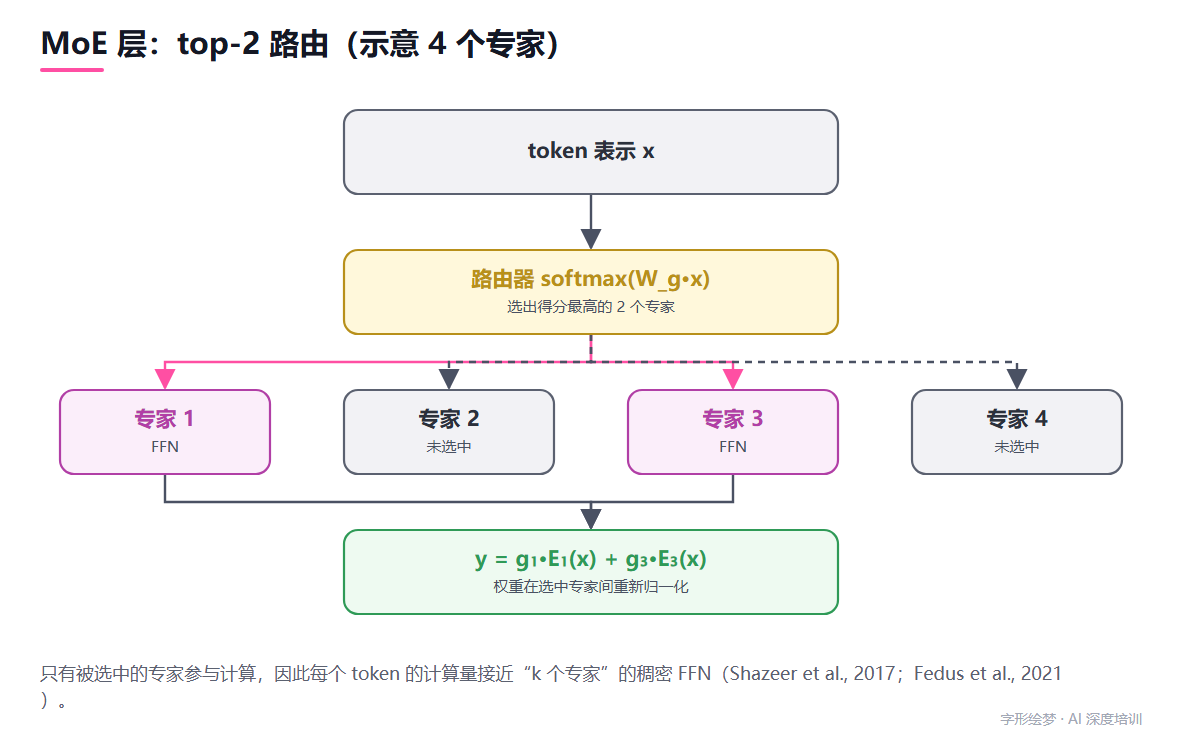
只有被选中的专家参与计算,因此每个 token 的计算量接近“k 个专家”的稠密 FFN(Shazeer et al., 2017;Fedus et al., 2021)。
3. 负载均衡与容量
在 MoE 架构中,路由机制的核心挑战在于避免“路由坍塌”(Routing Collapse)。若门控网络对某些专家赋予过高的概率,而忽略其他专家,会导致部分专家参数长期未被更新,形成“死专家”,从而降低模型的有效容量与泛化能力。这种现象在训练初期尤为常见,因为随机初始化的门控权重容易使少数专家获得较高的初始路由概率,进而形成正反馈循环。 为解决此问题,Switch Transformer 引入了辅助负载均衡损失(Fedus et al., 2021)。该损失项旨在惩罚专家负载的不均衡分布。设 N 为当前批次中的 token 总数,E 为专家数量,f_i 为被路由到第 i 个专家的 token 比例,P_i 为门控网络输出中第 i 个专家的平均概率。Switch 提出的辅助损失公式为:
L_aux = α · N · Σ_i=1^E f_i · P_i
其中 α 为超参数,用于调节辅助损失相对于主任务损失(如交叉熵损失)的权重。该损失函数的直觉在于:当某个专家 i 被频繁选中(f_i 大)且门控网络对其赋予高概率(P_i 大)时,乘积 f_i · P_i 较大,从而产生较大的惩罚项。理想情况下,若所有专家被均匀路由,则 f_i = 1/E 且 P_i ≈ 1/E,此时损失项最小。通过最小化 L_aux,模型被鼓励将 token 均匀地分配给所有专家,从而确保每个专家都能获得足够的梯度更新。 然而,在实际工程部署中,仅依靠辅助损失并不足以完全解决负载不均问题,特别是在推理阶段或高并发场景下。由于每个 GPU 或计算节点只能处理有限数量的 token,若某专家接收的 token 数量超过其处理能力,就会发生“溢出”(Overflow)。为此,系统通常引入“容量因子”(Capacity Factor, CF)。容量因子定义了每个专家可处理的最大 token 数量相对于平均负载的比例。例如,若 CF=2,则每个专家最多可处理平均负载两倍的 token。 当路由到某专家的 token 数量超过其容量上限时,系统需执行溢出处理策略。常见的策略包括:
- 丢弃策略:直接丢弃超出容量的 token,可能导致信息丢失。
- 重路由策略:将溢出的 token 重新路由到其他负载较轻的专家。
- 排队策略:将溢出的 token 放入队列,等待下一批次处理,增加延迟。
在 Switch Transformer 中,通常采用简单的丢弃或重路由机制,并结合辅助损失在训练阶段优化路由分布。值得注意的是,容量因子与辅助损失共同作用:训练时的辅助损失优化路由概率分布,而推理时的容量因子限制实际计算资源的使用。两者需协同调优,以在模型性能与计算效率之间取得平衡。
常见误区:认为辅助损失越大越好。实际上,过大的
α会过度约束路由分布,导致模型难以学习专家的特异性功能,反而降低最终性能。通常α需根据任务复杂度和模型规模进行精细调整。
# 伪代码:Switch 负载均衡损失计算
import torch
def switch_load_balance_loss(gates, num_experts, alpha=1e-2):
    # gates: (batch_size, num_experts) 门控概率
    # 计算每个专家的 token 比例 f_i
    f_i = gates.sum(dim=0) / gates.shape[0]  # (num_experts,)
    # 计算每个专家的平均概率 P_i
    P_i = gates.mean(dim=0)  # (num_experts,)
    # 计算辅助损失
    loss = alpha * gates.shape[0] * (f_i * P_i).sum()
return loss该损失项通常与主任务损失相加,形成总损失:L_total = L_task + L_aux。通过反向传播,梯度会同时优化任务参数和门控权重,从而在保持任务性能的同时促进负载均衡。
4. 专家并行与通信
在分布式训练 MoE 模型时,专家并行(Expert Parallelism, EP) 是核心策略。其基本思想是将不同专家分配到不同的 GPU 上,以解决单卡显存无法容纳所有专家参数的问题。然而,EP 引入了高昂的通信开销,主要源于 all-to-all 通信原语。
All-to-All 通信机制
MoE 层的数据流分为两个阶段:分发(Dispatch)和汇聚(Combine)。
- 分发阶段:每个 GPU 持有当前批次的一部分 token。根据路由结果,这些 token 需要被发送到持有对应专家的 GPU。例如,GPU 0 上的 token 可能被路由到 GPU 1、2、3 上的专家。这要求 GPU 0 向 GPU 1、2、3 发送数据,同时 GPU 0 也从其他 GPU 接收发往自己专家的数据。这种“每个节点向所有其他节点发送不同数据,并接收来自所有其他节点的数据”的模式,正是 all-to-all 通信。
- 计算阶段:各 GPU 本地执行专家前向传播。
- 汇聚阶段:计算完成后,结果需要返回到原始 token 所在的 GPU。这再次触发一次 all-to-all 通信。
因此,每经过一个 MoE 层,至少需要两次 all-to-all 通信。在大规模集群中,all-to-all 的延迟和带宽消耗往往成为瓶颈,尤其是在网络互联带宽低于计算带宽的场景下(Lepikhin et al., 2020)。
与数据并行和张量并行的组合
在实际系统中,EP 很少单独使用,而是与其他并行策略组合:
- EP + 数据并行(DP):这是最常见的组合。每个 DP 组内的 GPU 持有不同的专家子集。DP 组之间通过 all-reduce 同步梯度,而 EP 组内部通过 all-to-all 交换激活值。这种组合允许模型在保持高吞吐的同时,扩展专家数量。
- EP + 张量并行(TP):TP 通常用于切分单个专家内部的大矩阵(如 FFN 的权重矩阵)。如果一个专家过大,单卡放不下,可以将其权重切分到多张卡上。此时,EP 负责将 token 路由到正确的“专家组”,而 TP 负责在该组内并行计算。这种细粒度切分可以进一步降低显存压力,但会增加组内通信频率。
工程权衡与优化
- 通信掩盖:由于 all-to-all 是同步操作,难以完全掩盖。优化器通常采用流水线并行,将通信与计算重叠,例如在计算当前层专家时,预取下一层的路由结果或发送当前层的结果。
- 拓扑感知:在 NVLink 域内,all-to-all 效率较高;跨节点(InfiniBand/RoCE)则受限于带宽。因此,EP 的并行度通常受限于节点内 GPU 数量,跨节点扩展主要依赖 DP。
- 负载均衡对通信的影响:如果路由严重不均(如某些专家过载),会导致部分 GPU 等待时间增加,进而延长 all-to-all 的同步时间。因此,负载均衡损失不仅影响训练稳定性,也直接影响推理和训练的通信效率(Fedus et al., 2021)。
常见误区:认为 EP 可以无限扩展。实际上,随着 EP 度增加,all-to-all 的通信量呈平方级增长(相对于参与通信的 GPU 数),且延迟敏感度极高。通常建议 EP 度不超过节点内 GPU 数,跨节点扩展优先使用 DP。
5. 代表模型与设计演进
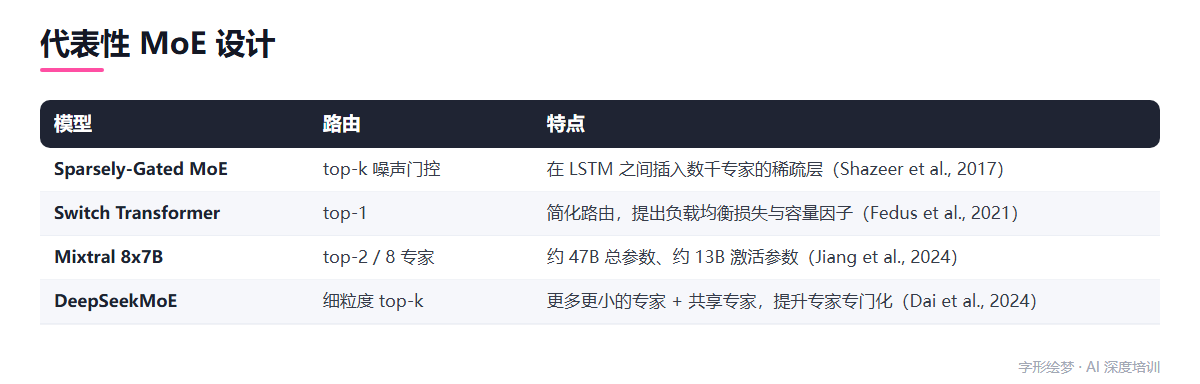
MoE 架构的演进核心在于如何平衡专家专业化程度、计算效率与系统稳定性。早期的稀疏门控混合专家层(Shazeer et al., 2017)奠定了条件计算的基础,但工程落地中,路由机制的简化与并行策略的优化成为关键突破口。 Switch Transformer(Fedus et al., 2021)是这一阶段的重要里程碑。它摒弃了复杂的 top-k 路由,转而采用 top-1 策略,即每个 token 仅被路由到单个专家。这种激进的设计简化了负载均衡逻辑,使得辅助损失函数 α · N · Σ_i f_i · P_i 能够更有效地防止路由坍塌。在 top-1 模式下,f_i 代表分到专家 i 的 token 比例,P_i 为路由到该专家的平均概率。Switch 证明了在万亿参数规模下,简单的稀疏性结合高效的自动分片(Automatic Sharding)是实现可扩展性的关键。其核心优势在于通信开销的降低:相比 top-k,top-1 减少了 all-to-all 通信的数据量,使得专家并行(Expert Parallelism)与数据并行的组合更加高效。 随着模型规模进一步扩大,Mixtral 8x7B(Jiang et al., 2024)引入了不同的设计哲学。它回归到 top-2 路由,每层包含 8 个专家,每个 token 选择 2 个。这种设计在保持稀疏性的同时,通过增加激活专家数量提升了模型容量。值得注意的是,Mixtral 8x7B 虽然总参数量巨大,但每个 token 仅访问约 47B 参数中的约 13B 激活参数。这种“大参数量、小激活量”的特性使其在推理效率上具有显著优势,尤其适合在有限硬件资源下部署高性能模型。Mixtral 的成功表明,top-2 路由在表达能力与计算成本之间取得了更好的平衡,且无需复杂的负载均衡损失也能保持较好的训练稳定性。 DeepSeekMoE(Dai et al., 2024)则进一步探索了专家专业化的极限。它提出了“细粒度专家”(Fine-grained Experts)与“共享专家”(Shared Experts)相结合的架构。细粒度专家将传统的大专家拆分为多个小专家,每个小专家只负责特定的子任务或特征子空间,从而提高了专家的专业化程度和稀疏性效率。共享专家则处理所有 token 都需要的基础特征,避免了信息在路由过程中的丢失。这种设计不仅提升了模型在复杂任务上的表现,还通过细粒度路由降低了单个专家的负载压力,进一步缓解了路由坍塌问题。DeepSeekMoE 的实践表明,通过结构创新而非单纯增加专家数量,可以更高效地利用参数规模,实现更优的专家专业化效果。 如下图所示,这三种设计代表了 MoE 演进的不同阶段:Switch 侧重系统效率与简单性,Mixtral 侧重推理效率与容量平衡,DeepSeekMoE 侧重专业化程度与结构创新。工程师在选择时需根据硬件约束、训练稳定性需求及目标任务特性进行权衡。
6. 小结与思考题
MoE 的核心价值在于解耦参数量与计算量:通过稀疏激活,模型在保持巨大容量(如 Mixtral 8x7B 的 47B 总参数)的同时,仅激活少量参数(约 13B)进行推理(Jiang et al., 2024)。其数学本质是条件计算:输出由门控网络 g(x) 选择 top-k 个专家,经重新归一化后加权求和 Σ g_i · E_i(x) 得到。 工程落地的关键挑战在于负载均衡与通信开销。若路由坍塌,部分专家闲置而部分过载,导致训练不稳定。Switch Transformer 引入辅助损失 α · N · Σ_i f_i · P_i 来惩罚分布不均,其中 f_i 为实际分配比例,P_i 为路由概率(Fedus et al., 2021)。此外,专家并行(Expert Parallelism)需通过 all-to-all 通信分发与汇聚 token,其带宽消耗常成为集群瓶颈,需与数据并行、张量并行精细组合以优化吞吐。 设计演进上,从 Shazeer et al. (2017) 的原始 MoE 层,到 GShard (Lepikhin et al., 2020) 的自动分片,再到 Switch (Fedus et al., 2021) 的 top-1 简化,以及 DeepSeekMoE (Dai et al., 2024) 引入细粒度专家与共享专家机制,核心思路始终是提升专家利用率并降低通信成本。
思考题
- 问题:在 Switch Transformer 中,若将 top-1 路由改为 top-2,且保持专家总数不变,这对负载均衡损失的梯度信号强度及训练稳定性会产生何种影响? 提示:考虑 top-k 选择对路由概率
P_i分布平滑度的影响,以及辅助损失中f_i与P_i乘积项在 k 值变化时的方差特性。 - 问题:假设集群中 GPU 间 all-to-all 通信带宽为
B,每个专家处理 token 的计算时间为T_comp。当专家数量E增加时,在什么条件下,专家并行的通信开销会超过计算开销,从而成为性能瓶颈? 提示:建立通信量(与 token 数和专家数相关)与计算量(与激活参数和 batch size 相关)的比值模型,分析E对 all-to-all 延迟的非线性影响。 - 问题:DeepSeekMoE 引入共享专家(Shared Expert)处理所有 token,而路由专家处理部分 token。相比纯路由 MoE,这种设计在推理延迟和显存占用上如何权衡? 提示:分析共享专家带来的恒定计算开销与路由专家带来的可变计算开销,结合 KV Cache 大小与专家激活频率,推导单位 token 的平均显存带宽需求。
参考文献
- Shazeer et al., 2017. Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer. arXiv:1701.06538 arxiv.org/abs/1701.06538
- Lepikhin et al., 2020. GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding. arXiv:2006.16668 arxiv.org/abs/2006.16668
- Fedus, Zoph, Shazeer, 2021. Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity. arXiv:2101.03961 arxiv.org/abs/2101.03961
- Jiang et al., 2024. Mixtral of Experts. arXiv:2401.04088 arxiv.org/abs/2401.04088
- Dai et al., 2024. DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models. arXiv:2401.06066 arxiv.org/abs/2401.06066
Paragoger衍生者AI训练营。发布者:稻草人,转载请注明出处:https://www.shxcj.com/archives/10403