本文属于《AI 深度培训》系列 · 难度:专家 · 篇幅:约 7000 字
大模型参数记忆存在时效滞后、溯源困难及幻觉风险。RAG 通过引入非参数记忆,将知识外置于文档库,实现动态更新与证据可追溯。本文深入解析 RAG 的数学形式化定义,涵盖从 BM25 稀疏检索、稠密双塔到重排与生成的全链路架构,探讨切分策略、分数融合及 HyDE 等高级范式,助您掌握构建高可靠检索增强系统的底层逻辑与工程权衡。
1. 导读:参数记忆与非参数记忆
大语言模型(LLM)的核心能力源于其参数化的神经网络权重。这种“参数记忆”(Parametric Memory)通过预训练将海量文本知识压缩进数十亿乃至数千亿个浮点数中。然而,这种记忆机制存在三个固有的工程与认知瓶颈:知识时效性滞后、事实溯源困难以及幻觉生成。 1. 知识更新的成本壁垒 参数记忆是静态的。一旦模型完成预训练,其内部知识即被“冻结”。若需更新最新的事实(如 2024 年的新闻、最新 API 文档或企业内部数据),传统路径是进行持续预训练(Continual Pre-training)或微调(Fine-tuning)。这不仅计算成本高昂,还面临灾难性遗忘(Catastrophic Forgetting)的风险,即新知识的注入可能破坏原有的通用能力。相比之下,检索增强生成(RAG)将知识外置于向量数据库或文档库中,实现了“非参数记忆”(Non-parametric Memory)的动态更新。只需更新索引,模型即可即时获取最新信息,无需触碰模型权重。 2. 可追溯性与审计需求 当模型生成一段代码或法律建议时,参数记忆无法直接提供“这句话出自哪本书”的证据。在金融、医疗、法律等高合规领域,答案的可解释性至关重要。RAG 架构强制模型在生成时引用检索到的特定文档片段,从而建立了从“生成结果”到“原始证据”的映射链路。这种可追溯性使得系统能够接受审计,并允许人类专家快速验证答案的依据。 3. 降低幻觉的机制约束 幻觉(Hallucination)往往源于模型在缺乏确切知识时进行概率性的“脑补”。RAG 通过提供高相关性的上下文证据,将生成任务从“开放式回忆”转化为“基于证据的摘要与推理”。Lewis et al. (2020) 在提出 RAG 框架时指出,结合检索器与生成器可以显著提升知识密集型任务的表现。通过限制生成器的自由度,使其严格依赖检索到的片段,可以有效抑制无根据的虚构内容。 本文路线 作为专家级教程,本文不局限于 RAG 的应用配置,而是深入其算法内核与系统架构:
- 形式化定义:解析
p(y|x)在检索边缘化下的数学表达,区分 RAG-Sequence 与 RAG-Token 的差异。 - 离线索引:探讨切分策略、嵌入模型选择及元数据过滤对检索质量的影响。
- 检索算法:对比稀疏检索(BM25)与稠密检索(DPR)的原理,解析分数融合策略。
- 重排与生成:深入交叉编码器(Cross-Encoder)与 ColBERT 晚交互机制,分析上下文组装对长序列注意力分配的影响(Liu et al., 2023)。
- 高级范式:介绍 HyDE、Self-RAG 等自适应检索技术,以及评估 RAG 系统的关键指标。
通过本文,读者将掌握构建高性能 RAG 系统的底层逻辑,能够针对具体场景权衡检索精度、延迟与成本,并具备诊断复杂 RAG 故障的能力。
2. 形式化:p(y|x) 的检索边缘化
参数化知识受限于训练数据的静态快照,而检索增强生成(RAG)通过引入非参数记忆,将生成任务建模为条件分布 p(y|x, d) 的边缘化问题,其中 d 为检索文档。这种架构解耦了知识存储与推理能力,使得系统能够动态更新知识库并支持答案溯源,从而显著降低幻觉率。 在形式化定义上,标准 RAG 框架(Lewis et al., 2020)区分了两种边缘化策略。RAG-Sequence 假设生成序列 y 完全依赖于单一检索文档,其概率定义为:
p(y|x) = Σ_d p(d|x) p(y|x, d)
这种模式适用于事实性问答,因为答案通常由单个文档支撑。相比之下,RAG-Token 假设每个生成 token y_i 可以依赖于不同的文档,其概率定义为:
p(y|x) = Π_i Σ_d p(d|x) p(y_i|x, y_<i, d)
RAG-Token 提供了更细粒度的灵活性,允许模型在生成过程中动态切换信息来源,但计算复杂度随生成长度线性增加。 在训练范式上,存在端到端联合训练与冻结检索器两种路径。端到端训练(如 REALM, Guu et al., 2020)将检索器与生成器视为整体优化,通过梯度反传调整嵌入空间,使检索结果更贴合生成需求。然而,这种模式对数据质量和计算资源要求极高。工程实践中更常见的是冻结检索器(如 DPR, Karpukhin et al., 2020),仅微调生成器。此时,检索器被视为固定的特征提取器,生成器学习如何从固定的向量空间中“解读”信息。这种解耦设计降低了训练不稳定风险,且便于替换检索后端(如从稠密检索切换到混合检索),但牺牲了检索与生成之间的深层协同优化能力。
常见误区:认为 RAG-Token 在所有场景下优于 RAG-Sequence。实际上,对于需要全局一致性的长文本生成,RAG-Sequence 往往表现更稳定,因为 RAG-Token 的逐 token 边缘化可能导致上下文连贯性断裂。
| 特性 | RAG-Sequence | RAG-Token |
|---|---|---|
| 依赖假设 | 整个序列依赖单一文档 | 每个 token 可依赖不同文档 |
| 计算成本 | 较低(一次边缘化) | 较高(每 token 一次边缘化) |
| 适用场景 | 事实问答、摘要 | 多跳推理、复杂生成 |
理解这一形式化差异,是后续设计检索策略与重排机制的理论基础。
3. 离线索引:切分、向量化与索引
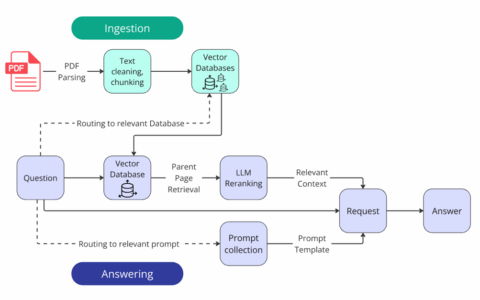
离线索引是 RAG 系统的基石,其质量直接决定了在线检索的上限。如下图所示,离线索引阶段主要包含文档切分、向量化表示构建以及索引结构构建三个核心环节。
切分粒度与重叠策略
原始文档(如 PDF、网页)通常远长于检索单元。切分(Chunking)的目标是将长文本分解为语义连贯的“段落”(Passage)。 直觉:过短的切分会丢失上下文,导致检索到的片段无法独立回答问题;过长的切分会稀释关键信息密度,降低向量表示的区分度。 策略:
- 固定长度 + 重叠:最常用的工程实践。例如,以 512 tokens 为窗口,设置 50-100 tokens 的重叠(Overlap)。重叠确保了边界处的语义完整性,避免关键句子被截断。
- 语义切分:利用段落结构、标题层级或基于嵌入相似度的动态断点。这种方法能更好地保持语义完整性,但计算成本更高,且对格式混乱的文档鲁棒性较差。
- 递归切分:优先按段落、句子、单词层级递归切分,直到满足最大长度限制。这是 LangChain 等框架的默认策略,兼顾了语义边界与长度约束。
常见误区:盲目追求“最小切分”。实际上,对于需要多跳推理或长上下文依赖的问题,稍大的切分窗口(如 1024 tokens)配合高质量的重排器,往往比碎片化的微小切分效果更好。
嵌入模型与归一化
嵌入(Embedding)将文本映射为高维稠密向量。在 RAG 中,通常使用双塔模型(Two-Tower),即查询和文档分别独立编码,以便离线预计算文档向量。 模型选择:
- 通用嵌入模型:如 Sentence-BERT 及其变体,适用于通用领域。
- 领域特定微调:若领域术语密集(如法律、医疗),建议在领域数据上对嵌入模型进行对比学习微调,以增强对专业术语的区分能力。
归一化(Normalization): 在使用余弦相似度(Cosine Similarity)作为检索度量时,必须对嵌入向量进行 L2 归一化。
v_norm = v / ||v||_2
归一化后,余弦相似度等价于点积:
cos(θ) = (u · v) / (||u|| ||v||) = u_norm · v_norm
工程含义:
- 加速计算:归一化后的向量点积可以直接使用高效的矩阵乘法(GEMM)实现,避免了每次计算范数的开销。
- 稳定性:防止因向量模长差异导致的相似度分数漂移,确保不同文档间的分数具有可比性。
注意:并非所有嵌入模型都适合余弦相似度。部分模型(如某些基于对比学习的模型)可能更适配欧氏距离。在使用前,应验证模型训练目标与检索度量的匹配性。
元数据过滤
向量检索是“模糊”的,而业务需求往往需要“精确”的约束。元数据(Metadata)过滤允许在检索前或检索中施加结构化条件。 应用场景:
- 时间范围:仅检索 2023 年后的文档。
- 来源限定:仅检索来自“官方文档”而非“博客”的内容。
- 权限控制:根据用户角色过滤敏感文档。
实现方式:
- 预过滤(Pre-filtering):在向量检索前,通过元数据条件缩小候选集。适用于高选择性(High-Selectivity)的过滤条件,能显著减少向量搜索的计算量。
- 后过滤(Post-filtering):先检索 Top-K 向量,再根据元数据过滤。适用于低选择性条件,但可能导致最终结果不足 K 个,需设置更大的初始 K 值。
- 混合过滤:现代向量数据库(如 Milvus, Pinecone, Weaviate)通常支持在向量索引中集成标量索引,实现高效的混合过滤。
常见误区:忽视元数据的时效性。文档内容可能更新,但元数据(如“最后修改时间”)未及时同步,导致检索到过期信息。建立元数据自动更新机制至关重要。
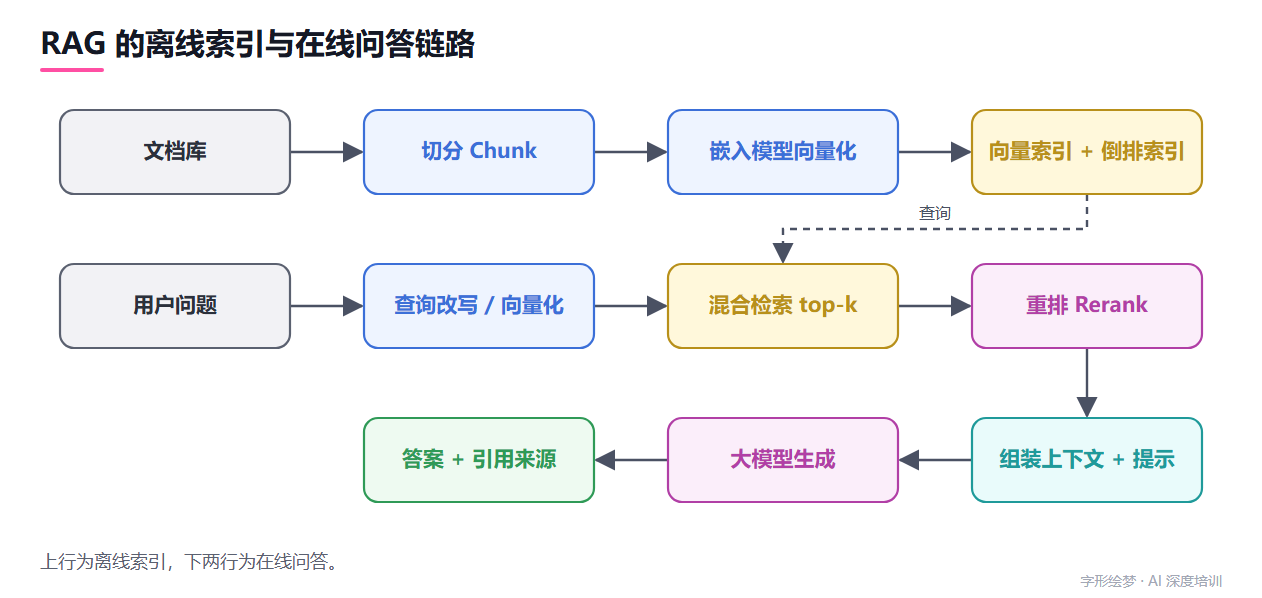
上行为离线索引,下两行为在线问答。
4. 检索:BM25、稠密双塔与混合
检索是 RAG 系统的基石。理想的检索器需在海量文档中快速定位与查询语义最相关的片段。目前主流方案分为稀疏检索(以 BM25 为代表)和稠密检索(以双塔模型为代表),二者各有优劣,工程实践中常采用混合策略。
1. BM25:基于词频的稀疏检索
BM25 是经典的概率相关性框架,其核心思想是:一个词在文档中出现的频率越高,且该词在整个语料库中越稀有,则该文档与查询的相关性越高(Robertson & Zaragoza, 2009)。 对于查询 Q = \q_1, dots, q_n\ 和文档 D,BM25 得分定义为:
score(Q, D) = Σ_i=1^n IDF(q_i) · (f(q_i, D) · (k_1 + 1)) / (f(q_i, D) + k_1 · (1 - b + b · |D| / avgdl))
其中:
f(q_i, D)是词q_i在文档D中的词频;|D|是文档长度,avgdl是语料库平均文档长度;IDF(q_i)通常定义为ln((N - n(q_i) + 0.5) / (n(q_i) + 0.5)),N为文档总数,n(q_i)为包含q_i的文档数;k_1控制词频饱和度,通常取 1.2~2.0,防止高频词主导得分;b控制长度归一化程度,通常取 0.75,值为 0 时忽略长度,值为 1 时完全按长度比例归一化。
工程含义:BM25 计算极快,支持倒排索引,适合精确匹配场景(如代码、专有名词)。但其局限在于无法捕捉语义等价性(如“汽车”与“轿车”)。
2. 稠密双塔与对比学习
稠密检索将查询和文档分别编码为固定维度的向量,通过余弦相似度计算相关性。典型架构为双塔(Two-Tower)模型:
# 伪代码:双塔模型前向传播
def dual_tower_forward(query, doc, tower_query, tower_doc):
    q_emb = tower_query(query)   # shape: [B, d]
    d_emb = tower_doc(doc)       # shape: [B, d]
    # 归一化,使点积等价于余弦相似度
    q_emb = F.normalize(q_emb, dim=-1)
    d_emb = F.normalize(d_emb, dim=-1)
    scores = torch.matmul(q_emb, d_emb.T)  # shape: [B, B]
return scores训练策略:采用对比学习(Contrastive Learning)。给定一个查询,正例是相关文档,负例是其他文档。损失函数通常为 InfoNCE:
L = -log( exp(sim(q, d+) / τ) / Σ_d' ∈ d+ ∪ D- exp(sim(q, d') / τ) )
其中 τ 是温度系数,D- 是负例集合。 难负例(Hard Negatives):随机采样的负例往往太容易区分,对模型提升有限。难负例是指那些语义上接近但实际不相关的文档。实践中,常用 BM25 或上一版本模型检索出的 Top-K 结果中排除正例后的文档作为难负例。Karpukhin et al. (2020) 在 DPR 中验证了难负例对提升检索精度的关键作用。
3. 混合检索与分数融合
单一检索器难以兼顾精确匹配与语义理解。混合检索(Hybrid Retrieval)同时运行 BM25 和稠密检索,然后融合两路结果。 分数融合:由于 BM25 得分和余弦相似度量纲不同,直接加权平均效果不佳。常用方法是 Reciprocal Rank Fusion (RRF),它仅依赖排名而非原始分数:
RRF(D) = Σ_r ∈ BM25, Dense 1 / (k + rank_r(D))
其中 k 是平滑常数(通常取 60),rank_r(D) 是文档 D 在检索器 r 中的排名。RRF 对异常分数鲁棒,且无需调参,已成为工业界标准做法。
常见误区:不要假设稠密检索一定优于 BM25。在包含大量专有名词、代码或数字的语料中,BM25 往往表现更好。混合策略能显著降低召回盲区。
5. 重排与上下文组装
在基础检索阶段,双塔模型(Bi-Encoder)通过独立编码查询和文档实现高效召回,但其交互性较弱,难以捕捉细粒度的语义匹配。为了提升精度,工程实践中通常引入重排(Re-ranking)阶段,利用计算成本更高的交叉编码器(Cross-Encoder)对 Top-K 候选文档进行二次打分。
交叉编码器:深度交互的代价与收益
交叉编码器将查询和文档拼接后输入同一个 Transformer 模型,利用自注意力机制实现词级的深度交互。Nogueira & Cho (2019) 指出,这种结构能显著提升排序效果,但计算复杂度随文档长度线性甚至二次方增长,因此仅适用于少量候选集(如 Top-10 至 Top-50)。
# 交叉编码器打分伪代码
def cross_encoder_score(query, doc, model):
    # 拼接查询与文档,添加特殊标记
    input_ids = tokenize(query + " [SEP] " + doc)
    # 前向传播,取 [CLS] 或特定分类头输出
    logits = model(input_ids)
    return logits[0]  # 相关性分数
ColBERT:晚交互(Late Interaction)的折中方案
为了在精度与效率之间取得平衡,Khattab & Zaharia (2020) 提出了 ColBERT。它采用“晚交互”策略:查询和文档各自独立编码为 Token 级的向量矩阵,而非单一向量。打分时使用 MaxSim 操作:对查询中的每个 Token,找到文档中与之最相似的 Token 向量,计算余弦相似度并求和。
Score(q, d) = Σ_i=1^|q| max_j=1^|d| (q_i · d_j)
这种方式保留了 Token 级的交互能力,同时允许文档向量预先计算并存储,大幅降低了在线推理延迟。如下图所示,ColBERT 在保持接近交叉编码器精度的同时,实现了比双塔模型更优的召回质量,且比全交叉编码器更高效。
上下文组装:顺序与长度的陷阱
检索到的文档并非直接拼接即可。Liu et al. (2023) 的研究表明,大语言模型对长上下文中间位置的信息利用率显著低于首尾位置(“Lost in the Middle”现象)。因此,在组装 Prompt 时,应将最相关的文档置于上下文的首部或尾部,避免关键信息被淹没在中间。此外,需严格控制总 Token 长度,防止超出模型窗口或稀释注意力权重。 工程建议:
- 分层处理:先用 BM25/双塔召回 Top-100,再用 ColBERT/交叉编码器重排至 Top-5。
- 动态截断:根据模型窗口大小,优先保留高分文档,并调整顺序以规避“中间迷失”。
- 元数据过滤:在重排前利用元数据(如时间、来源)过滤无关文档,减少噪声干扰。
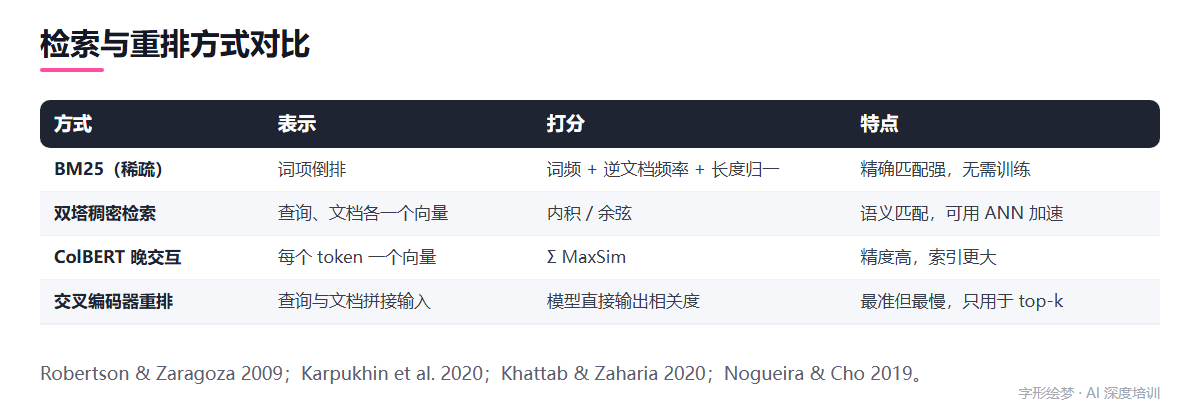
Robertson & Zaragoza 2009;Karpukhin et al. 2020;Khattab & Zaharia 2020;Nogueira & Cho 2019。
6. 查询改写、自适应检索与评估
在标准 RAG 流水线中,检索器往往直接面对原始用户查询。然而,用户查询通常存在指代不明、意图模糊或术语与文档表述不一致的问题。为弥合这一语义鸿沟,查询改写(Query Rewriting) 成为关键前置步骤。其中,HyDE(Hypothetical Document Embeddings) 是一种零样本的高效策略。其核心直觉是:虽然模型难以直接生成标准答案,但生成一篇“看起来像正确答案”的假设性文档(Hypothetical Document)往往更容易。HyDE 利用 LLM 基于查询生成这段假设文本,随后将其向量化,并用该向量在索引中检索真实文档(Gao et al., 2022)。这种方法巧妙地利用了生成模型与检索模型在语义空间中的对齐能力,无需相关性标签即可显著提升稠密检索的召回效果。 然而,并非所有查询都需要检索。过度检索不仅增加延迟,还可能引入噪声干扰生成。自适应检索(Adaptive Retrieval) 旨在让模型自主判断“何时检索”以及“检索什么”。Self-RAG 框架通过引入特殊的反思 Token(Reflection Tokens),实现了这一目标(Asai et al., 2023)。该框架训练 LLM 在生成过程中动态决策:
- 检索决策:判断当前生成步骤是否需要外部知识。
- 相关性批判:评估检索到的文档是否与当前生成内容相关。
- 支持性批判:评估生成的句子是否被检索文档所支持。
- 有用性批判:评估生成的内容是否对回答最终问题有帮助。
这种机制将 RAG 从“固定管道”转变为“自反思智能体”,显著降低了幻觉率,并提升了在复杂推理任务上的表现。 在工程落地中,评估 RAG 系统不能仅依赖端到端的准确率,必须解耦评估检索与生成两个阶段。 1. 检索质量评估 核心指标是召回率(Recall@K),即在返回的前 K 个文档中,包含正确答案或关键信息的比例。对于开放式问答,还需关注上下文精度(Context Precision),即检索文档中有多少比例是真正相关的。若召回率低,应优先优化检索器(如调整 BM25 参数或改进嵌入模型),而非盲目增加上下文长度。 2. 生成质量评估 核心指标是答案忠实度(Faithfulness),即生成答案中的每个声明是否都能从检索到的上下文中找到依据。高忠实度意味着低幻觉。此外,还需评估答案相关性(Answer Relevance),即答案是否直接回应了用户查询。
常见误区:许多团队在检索召回率正常但答案质量差时,错误地归因于 LLM 能力不足,从而花费大量成本微调生成模型。实际上,这往往是因为检索到的文档虽然相关,但关键信息位于文档中间部分,而 LLM 对长上下文中间位置的信息利用较差(Liu et al., 2023)。此时,优化重排策略或调整上下文组装顺序(如将关键段落置于首尾)往往比更换生成模型更有效。
通过结合 HyDE 的语义增强、Self-RAG 的自适应决策以及解耦式的评估体系,RAG 系统才能从简单的“查找-粘贴”进化为具备自我纠错能力的知识增强智能体。
7. 小结与思考题
回顾全文,RAG 的核心在于通过非参数记忆弥补参数记忆的局限,实现知识的可追溯与低幻觉生成。形式化上,我们需区分 RAG-Sequence 与 RAG-Token 两种边缘化方式,前者对文档级概率求和,后者对 token 级概率求和,二者在计算复杂度与精度上存在权衡(Lewis et al., 2020)。 在检索阶段,稀疏检索 BM25 依赖词频与逆文档频率,其核心参数 k1 控制词频饱和,b 控制文档长度归一化;稠密检索则通过双塔模型学习语义嵌入,需特别注意难负例挖掘以提升区分度(Karpukhin et al., 2020)。混合检索常采用倒数排名融合(RRF)等策略,以兼顾精确匹配与语义泛化。 重排阶段,交叉编码器通过联合编码查询与文档实现细粒度交互,精度最高但延迟较大;ColBERT 采用晚交互机制,对每个 token 独立编码后通过 MaxSim 求和,在效率与效果间取得平衡(Khattab & Zaharia, 2020)。上下文组装时,需警惕“迷失在中间”现象,即模型对长上下文中间位置的信息利用较差,建议将关键信息置于开头或结尾(Liu et al., 2023)。 进阶策略如 HyDE 通过生成假设性答案作为查询,解决零样本检索问题;Self-RAG 则引入自我批判机制,按需触发检索并评估生成质量,显著提升事实一致性(Gao et al., 2022; Asai et al., 2023)。 排障清单:
- 检索不准:检查切分粒度是否过粗导致噪声,或嵌入模型与领域不匹配;尝试增加 BM25 权重或引入元数据过滤。
- 生成幻觉:验证召回文档是否包含答案;若召回正确但生成错误,需检查上下文顺序或模型指令遵循能力。
- 延迟过高:评估是否过度使用交叉编码器重排;考虑用 ColBERT 替代,或限制重排候选集大小(如 Top-20)。
- 长上下文失效:避免将关键证据置于中间位置;尝试分段生成或摘要压缩。
思考题:
- RAG-Token 与 RAG-Sequence 的边界条件:在什么任务场景下,RAG-Token 的 token 级边缘化会显著优于 RAG-Sequence?请从概率分布的平滑性与多文档冲突角度分析。(提示:考虑答案分散在多个文档且需融合局部证据的场景。)
- 难负例挖掘的陷阱:在稠密检索训练中,若难负例过于困难(如与查询语义完全相反),会导致嵌入空间坍缩。如何设计动态难负例筛选策略以平衡区分度与稳定性?(提示:参考对比学习中的温度参数与负例温度调度。)
- 自适应检索的触发机制:Self-RAG 依赖模型自我批判决定是否检索,但小模型可能缺乏可靠的元认知能力。如何设计轻量级门控网络,使其在无需额外 LLM 调用的情况下,准确判断查询是否需要外部知识?(提示:考虑查询复杂度、实体密度与模型置信度的联合特征。)
参考文献
- Lewis et al., 2020. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. arXiv:2005.11401 arxiv.org/abs/2005.11401
- Guu et al., 2020. REALM: Retrieval-Augmented Language Model Pre-Training. arXiv:2002.08909 arxiv.org/abs/2002.08909
- Borgeaud et al., 2021. Improving Language Models by Retrieving from Trillions of Tokens. arXiv:2112.04426 arxiv.org/abs/2112.04426
- Karpukhin et al., 2020. Dense Passage Retrieval for Open-Domain Question Answering. arXiv:2004.04906 arxiv.org/abs/2004.04906
- Robertson & Zaragoza, 2009. The Probabilistic Relevance Framework: BM25 and Beyond. Foundations and Trends in Information Retrieval
- Nogueira & Cho, 2019. Passage Re-ranking with BERT. arXiv:1901.04085 arxiv.org/abs/1901.04085
- Khattab & Zaharia, 2020. ColBERT: Efficient and Effective Passage Search via Contextualized Late Interaction over BERT. arXiv:2004.12832 arxiv.org/abs/2004.12832
- Gao et al., 2022. Precise Zero-Shot Dense Retrieval without Relevance Labels (HyDE). arXiv:2212.10496 arxiv.org/abs/2212.10496
- Asai et al., 2023. Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection. arXiv:2310.11511 arxiv.org/abs/2310.11511
- Liu et al., 2023. Lost in the Middle: How Language Models Use Long Contexts. arXiv:2307.03172 arxiv.org/abs/2307.03172
Paragoger衍生者AI训练营。发布者:稻草人,转载请注明出处:https://www.shxcj.com/archives/10422