本文属于《AI 深度培训》系列 · 难度:专家 · 篇幅:约 7000 字
自注意力虽算力密集,却常因中间矩阵频繁读写 HBM 而陷入内存瓶颈。本文解析 FlashAttention 如何利用屋顶线模型识别这一痛点,并通过分块策略将计算留在片上 SRAM。重点推导在线 Softmax 的精确递推公式,对比 v1 与 v2 在并行调度上的差异,揭示如何通过减少 I/O 开销突破带宽限制,实现比近似方法更高效且精确的注意力加速。
1. 导读:算力够、带宽不够
在 Transformer 架构中,自注意力机制是计算核心,但其性能瓶颈往往不在于计算单元(FLOPs)的吞吐能力,而在于内存带宽(Bandwidth)。这一现象可以通过“屋顶线模型”(Roofline Model)直观理解。 1. 屋顶线模型与算术强度 屋顶线模型将硬件性能边界分为两个区域:
- 计算受限区(Compute-bound):当算法的算术强度(Arithmetic Intensity,即每字节内存访问所执行的浮点运算数)高于硬件拐点时,性能受限于 FLOPs。
- 内存受限区(Memory-bound):当算术强度低于拐点时,性能受限于 HBM(高带宽内存)与片上 SRAM(共享内存/寄存器)之间的数据搬运速度。
现代 GPU 的 FLOPs 增长远快于 HBM 带宽增长。对于标准自注意力操作,若序列长度为 n,隐藏维度为 d,其总计算量为 O(n^2d),但中间矩阵 S = QKᵀ 和 P = softmax(S) 的大小均为 n × n。若将这两个 n × n 矩阵显式写入 HBM 再读回,内存访问量达到 O(n^2),导致算术强度极低。因此,标准注意力实现通常处于内存受限区,大量时间浪费在数据搬运而非有效计算上。 2. 为什么 FlashAttention 重要? 传统实现中,注意力计算被拆分为三个独立的 GEMM(通用矩阵乘法)操作:
S = QKᵀP = softmax(S)O = PV
每一步都需要将中间结果 S 或 P 写回 HBM,造成巨大的 I/O 开销。FlashAttention 的核心洞察是:通过分块(Tiling)策略,将中间矩阵保留在片上 SRAM 中,避免其落盘至 HBM(Dao et al., 2022)。这不仅减少了内存访问次数,还使得注意力计算能够更接近计算受限区,从而显著提升吞吐。 3. 本文路线 作为专家级读者,你已熟悉 Transformer 基础。本文将深入以下关键点:
- 在线 Softmax 原理:如何在不存储完整
n × n矩阵的前提下,精确计算 Softmax(而非近似)。 - 分块算法设计:FlashAttention v1 如何通过外层遍历 K/V 块、内层遍历 Q 块来优化 I/O。
- 并行性优化:FlashAttention-2 如何通过重新划分工作负载,提升 GPU warp 利用率(Dao, 2023)。
- 工程实现细节:包括反向传播中的重计算策略,以及实际部署中的显存节省效果。
读完本文,你将理解为何“精确注意力”可以比“近似注意力”更高效,并掌握在硬件层面优化 Transformer 内核的基本方法论。
2. 标准注意力的读写开销
在 Transformer 架构中,自注意力机制的计算核心通常被分解为三个步骤:计算注意力分数矩阵 S = QKᵀ,对 S 进行归一化得到概率矩阵 P = softmax(S),最后计算输出 O = PV。虽然从算术运算强度(Arithmetic Intensity)来看,这些操作涉及大量的浮点乘法与加法,但在现代 GPU 架构中,真正的瓶颈往往不是计算单元(FLOPS),而是高带宽内存(HBM)与片上共享内存(SRAM)之间的数据搬运。 让我们具体审视标准实现中的内存访问模式。假设序列长度为 n,隐藏层维度为 d。首先,计算 S = QKᵀ 需要读取 Q 和 K 矩阵,生成一个形状为 (n, n) 的中间矩阵 S。在标准 CUDA 内核实现中,这个巨大的 S 矩阵通常会被完整地写回 HBM,以便后续步骤读取。接着,执行 softmax 操作时,内核需要从 HBM 读取 S,计算行最大值和指数和,生成归一化后的矩阵 P,并将 P 再次写回 HBM。最后,计算 O = PV 时,需要从 HBM 读取 P 和 V,生成最终输出 O。 这种“计算-写回-读取-再计算”的模式导致了严重的 I/O 开销。关键在于中间矩阵 S 和 P 的大小均为 O(n^2)。随着序列长度 n 的增加,这两个矩阵在 HBM 中占据的显存呈平方级增长。更糟糕的是,每个中间元素在 HBM 和 SRAM 之间至少需要被读写一次。对于长序列模型,HBM 的带宽延迟远高于 SRAM,且 HBM 带宽有限,导致 GPU 的计算核心在等待数据搬运时处于空闲状态,即所谓的“内存绑定”(Memory-Bound)。 根据 Dao et al. (2022) 的分析,标准注意力机制的额外显存占用随序列长度呈平方增长,这与 FlashAttention 所追求的线性增长形成鲜明对比。在屋顶线模型(Roofline Model)的视角下,标准注意力算法的算术强度较低,无法充分利用 GPU 的峰值算力。即使硬件算力足够,由于 HBM 带宽的限制,实际吞吐量远低于理论峰值。 此外,这种实现方式还带来了工程上的复杂性。为了加速 softmax,通常需要多次遍历数据以计算行最大值和归一化因子,这进一步增加了 HBM 的访问次数。例如,一次完整的 softmax 可能需要两次遍历:一次找最大值,一次计算指数和。每次遍历都意味着 O(n^2) 的数据量在 HBM 中流动。 因此,优化注意力机制的核心思路在于避免将中间矩阵 S 和 P 显式地写回 HBM。通过算法重构,使得中间结果仅保留在高速的片上 SRAM 中,直到最终输出 O 计算完毕,从而大幅减少 HBM 的读写次数。这正是 FlashAttention 系列算法解决的关键问题:如何在保持计算精确性的前提下,通过分块处理(Tiling)和在线算法,将注意力机制从内存绑定转变为计算绑定,从而释放 GPU 的全部算力潜力(Dao et al., 2022)。
3. 在线 Softmax:分块也能精确
在标准注意力机制中,Softmax 操作要求对序列维度的所有分数进行全局归一化。若我们将序列长度 n 划分为多个块(Tile),直接对每个块独立执行 Softmax 会导致结果错误,因为分母中的求和项 Σ_j exp(s_ij) 必须覆盖所有 j。为了解决这一问题,FlashAttention 引入了在线 Softmax(Online Softmax) 算法。该算法的核心思想是:在遍历数据块的过程中,动态维护两个状态变量——当前块的最大值 m 和当前的指数和 ℓ,并通过递推公式将新块的信息“合并”到已有状态中,从而在不存储完整 n × n 矩阵的前提下,得到与标准 Softmax 完全一致的精确结果(Dao et al., 2022)。
1. 状态变量定义
对于查询向量 q_i,假设我们已经处理了前 k-1 个键值块,当前维护的状态为:
m_i, k-1:前k-1个块中所有分数s_ij的最大值。ℓ_i, k-1:基于该最大值归一化后的指数和,即ℓ_i, k-1 = Σ_j ∈ prev exp(s_ij - m_i, k-1)。o_i, k-1:基于当前状态计算出的部分输出,即o_i, k-1 = Σ_j ∈ prev exp(s_ij - m_i, k-1) v_j。
2. 合并递推公式
当处理第 k 个块时,我们首先在该块内部计算局部最大值 m_k 和局部指数和 ℓ_k(注意:此处 m_k, ℓ_k 是相对于该块自身的最大值计算的,通常为了数值稳定性,块内也会先减去块内最大值)。 为了将第 k 个块合并到前 k-1 个块的状态中,我们需要更新全局最大值 m_i,k 和全局归一化因子 ℓ_i,k。 步骤一:更新最大值 新的全局最大值取两者中的较大者:
m_i,k = max(m_i, k-1, m_k)
步骤二:更新归一化因子(指数和) 这是在线 Softmax 的关键。我们需要将之前的和 ℓ_i, k-1 和当前的和 ℓ_k 统一到新的基准 m_i,k 下。 根据指数性质 exp(x - a) = exp(x - b) · exp(b - a),我们可以推导:
ℓ_i,k = ℓ_i, k-1 · exp(m_i, k-1 - m_i,k) + ℓ_k · exp(m_k - m_i,k)
步骤三:更新部分输出 同样地,部分输出 o_i, k-1 和 o_k 也需要根据新的基准进行缩放,然后相加:
o_i,k = fraco_i, k-1 · ℓ_i, k-1 · exp(m_i, k-1 - m_i,k) + o_k · ℓ_k · exp(m_k - m_i,k)ℓ_i,k
或者更常见的工程实现方式是先累积未归一化的加权和,最后再除以 ℓ:
o_i,k^unnormalized = o_i, k-1 · exp(m_i, k-1 - m_i,k) + o_k · exp(m_k - m_i,k)
最终输出为 o_i = o_i, K^unnormalized / ℓ_i,K。
3. 正确性推导
我们需要证明,经过所有 K 个块的处理后,最终结果等价于标准 Softmax。 标准 Softmax 定义为:
o_i = fracΣ_j=1^n exp(s_ij) v_jΣ_j=1^n exp(s_ij)
令 M = max_j s_ij 为全局最大值。为了数值稳定性,标准计算通常写作:
o_i = fracΣ_j=1^n exp(s_ij - M) v_jΣ_j=1^n exp(s_ij - M)
在在线 Softmax 中,假设最终的全局最大值收敛为 m_i,K = M(因为最大值具有单调不减性,最终必然等于全局最大值)。 根据递推公式,最终的归一化因子为:
ℓ_i,K = Σ_k=1^K ( Σ_j ∈ block_k exp(s_ij - m_k) ) · exp(m_k - M)
利用指数运算法则 exp(a-b)exp(b-M) = exp(a-M),上式简化为:
ℓ_i,K = Σ_k=1^K Σ_j ∈ block_k exp(s_ij - M) = Σ_j=1^n exp(s_ij - M)
这与标准 Softmax 的分母完全一致。 同理,对于分子(未归一化的加权和):
o_i,K^unnormalized = Σ_k=1^K ( Σ_j ∈ block_k exp(s_ij - m_k) v_j ) · exp(m_k - M)
= Σ_k=1^K Σ_j ∈ block_k exp(s_ij - M) v_j = Σ_j=1^n exp(s_ij - M) v_j
这与标准 Softmax 的分子完全一致。 因此,最终输出 o_i = o_i,K^unnormalized / ℓ_i,K 与标准 Softmax 的结果在数学上是严格等价的。这一性质保证了 FlashAttention 是精确注意力,而非近似算法(Dao et al., 2022)。
4. 工程实现要点
在实际 GPU 内核中,上述递推公式通常被优化为减少非矩阵乘法运算。例如,可以先计算缩放因子 α = exp(m_i, k-1 - m_i,k) 和 β = exp(m_k - m_i,k),然后执行向量缩放和加法。由于 m_i,k 是标量,这些操作可以在寄存器中高效完成,避免了额外的 HBM 读写。
常见误区:有些实现会错误地认为“分块 Softmax”只是近似,或者在合并时忘记对之前的累积值
o_i, k-1和ℓ_i, k-1进行基于新最大值的重新缩放。如果只简单相加而不调整基准,结果将是错误的。正确的做法是始终维护相对于当前最大值的相对值,并在最大值更新时进行指数修正。
4. FlashAttention 的分块算法
在理解在线 Softmax 的数学基础后,我们来看 FlashAttention v1 如何将这一机制转化为具体的硬件执行流。其核心思想是IO 感知(IO-awareness):不再试图将整个 n × n 的注意力矩阵 S 和 P 存储在 HBM 中,而是将序列切分为小块,利用 GPU 片上高速 SRAM 进行局部计算,并通过在线 Softmax 的递推性质保证最终结果的精确性(Dao et al., 2022)。
前向传播:分块遍历策略
FlashAttention v1 采用了一种特定的循环嵌套结构:外层遍历 K/V 块,内层遍历 Q 块。这种顺序看似反直觉(通常我们习惯按 Query 为主序),但它是为了最大化 SRAM 的复用率并减少 HBM 读写次数。 如下图所示,对于每一个固定的 K/V 块,算法会遍历所有的 Q 块。这意味着 K/V 块只需从 HBM 加载一次,即可与所有 Q 块进行交互。
# FlashAttention v1 前向传播伪代码 (简化版)
# 假设序列长度 n 被划分为 Br 个 Q 块和 Bc 个 K/V 块
for j in range(Bc):  # 外层:遍历 K/V 块
    load K_j, V_j into SRAM  # 从 HBM 加载当前 K/V 块
    for i in range(Br):  # 内层:遍历 Q 块
        load Q_i into SRAM  # 从 HBM 加载当前 Q 块
        # 计算局部注意力
        S_ij = Q_i @ K_j.T  # 局部得分矩阵
        P_ij = softmax(S_ij)  # 局部概率矩阵
        O_ij = P_ij @ V_j  # 局部输出
        # 在线更新全局统计量 m_i, l_i, O_i
        m_new = max(m_i, max(S_ij))
        l_new = l_i * exp(m_i - m_new) + sum(exp(S_ij - m_new))
        O_new = (l_i * exp(m_i - m_new) * O_i + exp(S_ij - m_new) @ V_j) / l_new
        m_i, l_i, O_i = m_new, l_new, O_new
    # K_j, V_j 从 SRAM 卸载
# 最终 O_i 即为精确注意力输出
这种策略的关键在于,虽然每个 Q 块会被重复加载 B_c 次,但 K/V 块只被加载 B_r 次。由于 B_r 和 B_c 通常远小于总块数,且 SRAM 带宽远高于 HBM,这种“以空间换时间”的 IO 调度显著降低了内存瓶颈。此外,由于不需要存储完整的 S 和 P 矩阵,显存占用从 O(n^2) 降至 O(n)(Dao et al., 2022)。
反向传播:重计算策略
在反向传播中,我们需要计算梯度 ∂ L / ∂ Q, ∂ L / ∂ K, ∂ L / ∂ V。标准反向传播需要前向传播中存储的 S 和 P 矩阵,但这在长序列下是不可行的。 FlashAttention 采用重计算(Recomputation)策略:
- 前向阶段:仅保存每个 Q 块的全局统计量
m_i, l_i和最终输出O_i。 - 反向阶段:再次遍历 K/V 块和 Q 块。对于每个块对
(i, j),重新计算S_ij = Q_i K_jᵀ和P_ij = softmax(S_ij)(利用已知的m_i, l_i进行在线 Softmax 归一化),然后计算梯度。
虽然重计算增加了计算量(FLOPs 增加约 2-3 倍),但由于这些计算主要在 SRAM 中进行,且避免了 O(n^2) 的 HBM 读写,整体速度依然显著快于标准实现。这种“计算换 IO”的权衡是 FlashAttention 高效的核心所在。
注意:v1 的循环顺序(外层 K/V)在 GPU 并行性上存在局限性,因为不同 Q 块的更新是串行的。这一缺陷在 FlashAttention-2 中得到了改进(Dao, 2023)。
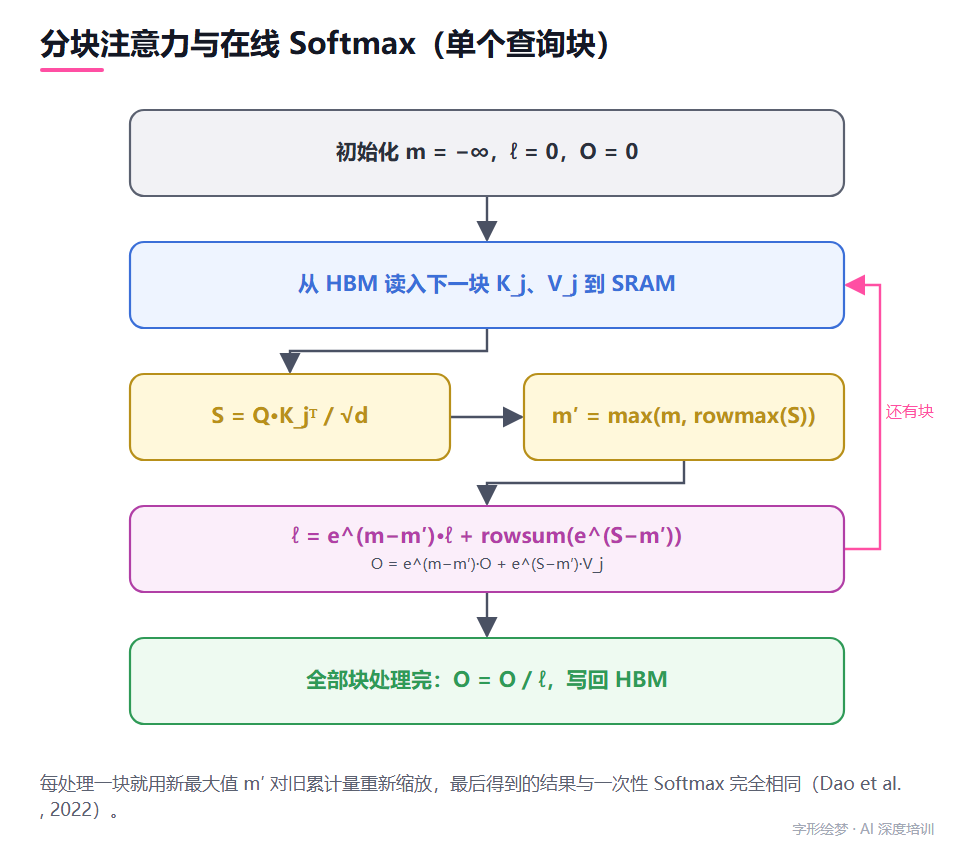
每处理一块就用新最大值 m′ 对旧累计量重新缩放,最后得到的结果与一次性 Softmax 完全相同(Dao et al., 2022)。
5. FlashAttention-2 的改进
FlashAttention v1 虽然解决了显存瓶颈,但在计算效率上仍有优化空间。v2 的核心改进在于重新划分并行维度与减少非矩阵乘法(Non-MatMul)开销,从而更充分地利用 GPU 的 Tensor Core 算力(Dao, 2023)。 1. 减少非矩阵乘运算 在标准注意力中,Softmax 包含指数运算 exp 和除法。这些操作在 GPU 上执行效率远低于矩阵乘法(GEMM)。v1 在计算每个块时,需要频繁更新全局最大值 m 和归一化因子 ℓ,这涉及大量的逐元素操作。 v2 优化了在线 Softmax 的更新逻辑。关键在于延迟归一化:在中间步骤中,不立即对累加器 O 进行除法归一化,而是仅维护未归一化的累加值。只有当块处理结束或需要合并时,才进行必要的缩放。具体而言,v2 将 exp 运算中的减法操作(减去最大值)合并到 GEMM 后的后处理中,减少了独立的逐元素内核启动次数。此外,v2 避免了在每次块迭代中重新计算 softmax 的分母,而是通过维护一个累积的 ℓ 向量,最后统一除以 ℓ。这种策略将原本分散的逐元素运算聚合,减少了内存带宽压力和非 GEMM 指令的比例。 2. 按序列维并行 v1 的并行策略主要基于头(Head)和批处理(Batch)维度。当序列长度 n 很大时,如果 n 不能被块大小整除或块数较少,GPU 的 SM(流多处理器)利用率会下降。 v2 引入了沿序列维度的并行。具体来说,将 Q 序列划分为多个块,每个 GPU 线程块(Thread Block)负责计算 Q 的一个子块与所有 K/V 块的交互。这意味着,即使头数较少,只要序列足够长,就可以启动更多的线程块来并行计算。这种并行方式使得 GPU 能够同时处理更多的 Q 块,显著提高了 Tensor Core 的占用率。在反向传播中,v2 也采用了类似的策略,对 K 和 V 的梯度计算进行序列维度的并行划分,确保前向和反向传播都能充分利用硬件资源。 3. Warp 间分工 GPU 中的 Warp 是调度的基本单位。v1 中,每个 Warp 独立处理部分数据,但 Warp 间缺乏细粒度的协作。v2 优化了 Warp 内的分工与 Warp 间的同步。 在计算 S = QKᵀ 时,v2 将 GEMM 操作分配给 Warp 中的不同线程,利用寄存器文件高效存储中间结果。在 Softmax 计算阶段,v2 采用“Warp 级归约”策略:每个 Warp 先计算局部最大值和和,然后通过共享内存(Shared Memory)进行 Warp 间归约,得到全局最大值 m 和归一化因子 ℓ。这种层次化的归约减少了全局同步的开销。 此外,v2 在内存访问模式上进行了优化,确保 Warp 内的线程访问全局内存时具有更好的局部性,减少 Bank Conflict。通过精细化的 Warp 分工,v2 将非 GEMM 操作(如 Softmax、Masking)的开销降至最低,使得整体吞吐量接近理论峰值。
# 伪代码:v2 中 Warp 级 Softmax 归约示意
# 假设每个 Warp 处理一个 Q 块的一部分
local_max = max(S_warp)  # 每个 Warp 内的局部最大值
local_sum = sum(exp(S_warp - local_max))  # 局部归一化因子
# 通过共享内存进行 Warp 间归约
global_max = max_across_warps(local_max)
global_sum = sum_across_warps(local_sum * exp(local_max - global_max))
# 最终归一化
O_warp = O_unnormalized / global_sum
这种改进使得 FlashAttention-2 在相同硬件上比 v1 快约 2 倍,特别是在长序列场景下,其优势更为明显(Dao, 2023)。
6. 小结与思考题
回顾全文,我们解构了 Transformer 中注意力机制在硬件层面的核心瓶颈:并非算力不足,而是 HBM 带宽限制。标准实现中,S=QKᵀ 与 P=softmax(S) 产生的 n × n 中间矩阵导致显存占用随序列长度平方增长(Vaswani et al., 2017)。FlashAttention 的核心贡献在于引入 IO 感知设计,通过分块计算避免将中间矩阵写回 HBM,从而将额外显存开销降至线性增长(Dao et al., 2022)。 其数学基石是“在线 Softmax”算法。该算法允许在分块处理时精确计算注意力输出,无需存储完整的 n × n 矩阵。关键在于维护两个运行状态:当前块的最大值 m 与归一化因子 ℓ。当合并新块时,递推公式为:
m_new = max(m_old, m_block)
ℓ_new = ℓ_old · exp(m_old - m_new) + ℓ_block · exp(m_block - m_new)
这一机制确保了分块计算的数学等价性,即最终结果与标准 Softmax 完全一致(Dao et al., 2022)。 在工程实现上,FlashAttention-2 进一步优化了并行策略。它减少了非矩阵乘法运算(如指数运算)的占比,并通过按序列维度并行以及 warp 间的精细分工,显著提升了 GPU 利用率(Dao, 2023)。这种设计使得注意力计算在长序列场景下不再受限于显存墙,而是真正逼近算力上限。 思考题:
- 在线 Softmax 的数值稳定性 在递推公式中,若
m_old远大于m_block,ℓ_old的更新项会趋近于 0。请分析在极端动态范围下(如长序列中前几个块包含极大值),这种数值行为是否会导致精度损失?在实际工程中,如何通过重缩放(rescaling)策略缓解这一问题? > 提示:关注exp(m_old - m_new)项在浮点精度下的下溢风险,以及 FlashAttention 源码中如何处理m_i的更新顺序。 - 反向传播的重计算代价 FlashAttention 的前向传播不保存
P矩阵,反向传播时需重新计算P以获取梯度。请推导:在序列长度n极大、批处理大小B较小的场景下,重计算带来的额外 FLOPs 是否可能抵消其节省的 HBM 带宽?在何种硬件配置下(如 H100 vs. A100),这一权衡更倾向于收益还是损失? > 提示:对比 H100 与 A100 的 HBM 带宽与 FP16 算力比值,分析“计算换带宽”策略的临界点。 - 与 PagedAttention 的兼容性 PagedAttention 通过分页管理 KV Cache 以优化推理显存碎片(Kwon et al., 2023)。FlashAttention 要求 Q、K、V 在内存中连续或可高效分块访问。请思考:在解码阶段(decode phase),当 KV Cache 被分散存储在多个非连续页面时,FlashAttention 的分块策略如何适配?是否需要修改块大小或引入额外的地址映射开销? > 提示:分析解码阶段 Q 为单 token 时的特殊性,以及 PagedAttention 中
block_table对内存访问模式的影响。
参考文献
- Dao et al., 2022. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. arXiv:2205.14135 arxiv.org/abs/2205.14135
- Dao, 2023. FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning. arXiv:2307.08691 arxiv.org/abs/2307.08691
- Vaswani et al., 2017. Attention Is All You Need. arXiv:1706.03762 arxiv.org/abs/1706.03762
- Kwon et al., 2023. Efficient Memory Management for Large Language Model Serving with PagedAttention. arXiv:2309.06180 arxiv.org/abs/2309.06180
Paragoger衍生者AI训练营。发布者:稻草人,转载请注明出处:https://www.shxcj.com/archives/10406