本文属于《学生入门》系列 · 难度:学生入门 · 篇幅:约 2600 字课程
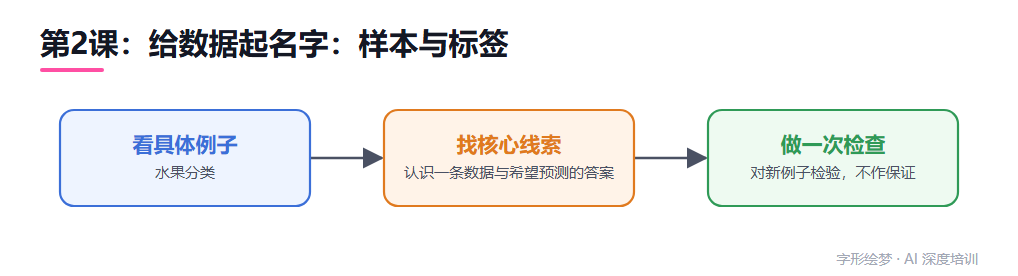
能用自己的话解释认识一条数据与希望预测的答案,并完成一个可核查的小练习。
1. 学习目标与术语
本课程为独立编写的AI学习资料,不是官方教材。
学习目标
能用自己的话解释认识一条数据与希望预测的答案,并完成一个可核查的小练习。
术语解释
样本:一条用于学习或评估的记录;模型:按一定规则计算输出的系统。本课专用术语在正文首次出现时单独解释。
2. 生活中的例子
想象你面前有一筐混合的水果,有红苹果、绿苹果,还有香蕉。你想让机器学会区分它们。这里没有真实人物,也没有涉及收入,我们只看一个假设的简单场景。 假设你手里有三条记录。第一条记录写着:颜色是红色,重量是200克,形状是圆的。你希望机器看到这些特征后,能猜出这是“苹果”。在这个场景里,“颜色、重量、形状”就是数据,也就是我们给机器看的“线索”;而“苹果”就是标签,也就是你希望机器预测出的“答案”。 再看第二条记录:颜色是黄色,重量是150克,形状是长条的。你希望机器猜出这是“香蕉”。第三条记录:颜色是绿色,重量是180克,形状是圆的。你希望机器猜出这是“苹果”。 注意,这里的数字(200克、150克)和颜色都是为了方便理解而设定的假设示例,不代表任何真实水果的标准。在实际生活中,苹果的颜色可能是红的,也可能是绿的,重量也会变化。机器学习的关键不在于记住这三个具体的数字,而在于学会从“颜色、重量、形状”这些特征中,找出判断它是苹果还是香蕉的规律。 这个类比很有用,因为它把抽象的“输入”和“输出”变成了看得见的“线索”和“答案”。但也要明白,这个类比有局限。真实世界的数据比水果复杂得多,可能包含成千上万种特征,而且答案不一定非黑即白。比如,一个水果既像苹果又像梨,机器可能需要给出一个概率,而不是一个确定的名字。 所以,当我们说“给数据起名字”时,其实是在建立一种对应关系:左边是一堆描述事物的特征(样本),右边是你希望得到的结论(标签)。机器学习的任务,就是根据左边的大量例子,学会如何从左边推导出右边。 记住,这个水果分类的例子只是一个入门的比喻。它帮助你在脑海中建立起“特征”和“标签”的基本概念,但不要把它当成机器学习的完整定义。真正的机器学习处理的是更复杂、更模糊的数据,而不仅仅是简单的水果分类。
3. 一步步理解核心方法
想象你面前有一个装满水果的篮子。你想让机器学会分辨苹果和橘子。在数学上,我们把每一个单独的水果看作一个“样本”。比如,你拿起一个水果,测得它的重量是 150 克,颜色偏红。这组具体的测量数据,就是描述这个样本的“特征”。 接下来,我们需要告诉机器这个水果到底是什么。如果它是苹果,我们就给它的标签打上“苹果”二字;如果是橘子,标签就是“橘子”。这个标签,就是我们要预测的答案。在机器学习里,样本是输入,标签是输出。 如下图所示,左侧列出了几个假设的水果样本。注意,这里的所有数字如 150 克或 120 克,都是为了方便理解而设定的假设示例,并非真实测量值。 我们来看第一个假设样本:重量 150 克,颜色红色。它的标签是“苹果”。第二个样本:重量 120 克,颜色橙色。标签是“橘子”。 这里用到一个简单的逻辑:机器通过观察“特征”(重量、颜色)来猜测“标签”(苹果或橘子)。就像你猜谜语,谜面是特征,谜底是标签。 在初中数学里,这有点像解方程。已知 x(特征),求 y(标签)。只不过这里的 x 和 y 不是简单的数字关系,而是多种属性组合。例如,重量 150 克且红色,对应苹果;重量 120 克且橙色,对应橘子。 关键点在于:标签是正确答案,样本是题目。机器学习的目标,就是让机器看多了“题目”和“答案”后,能自己猜出没见过的“题目”的答案。 记住,样本是数据本身,标签是我们要找的答案。这个区分非常基础,但至关重要。后续我们会看到,机器如何从成千上万个这样的“样本-标签”对中找出规律。
4. 用假设示例动手理解
假设示例: 想象你在整理一箱水果,手里有三条记录。为了让你直观理解,我们设定以下假设数据(非真实统计): 记录A:颜色=红,重量=200克,形状=圆。 记录B:颜色=黄,重量=150克,形状=圆。 记录C:颜色=绿,重量=80克,形状=长。 我们的目标是判断它们分别是苹果还是香蕉。这里,“颜色”、“重量”、“形状”是输入特征,也就是我们用来观察的数据;而“苹果”或“香蕉”是标签,也就是我们希望模型预测出的答案。 注意单位一致性:重量统一用“克”。如果混用“斤”和“克”,计算就会出错。比如,若误将200克当作200斤,数值差异巨大,模型会困惑。 现在,让我们动手“猜”一下: 看到记录A,红色、200克、圆形。根据生活常识,这很像苹果。 看到记录B,黄色、150克、圆形。这既可能是苹果,也可能是香蕉,有点模糊。 看到记录C,绿色、80克、长形。这明显更像香蕉。 在这个过程中,我们把“红、200克、圆”这一组数字和文字,打包成一条样本。样本就是“输入”,标签就是“输出”。 关键点:
- 样本:包含所有特征的那一行数据,如记录A。
- 标签:我们想预测的结果,如“苹果”。
- 假设性:以上数字仅为教学演示,真实苹果重量范围更广,颜色也可能不同。
通过这三个假设例子,你看到了:机器不是靠“感觉”,而是靠这些具体的特征组合,去匹配对应的标签。这就是“给数据起名字”的第一步——分清哪部分是“题”,哪部分是“答案”。
5. 常见误区与适用边界
常见误区与适用边界 首先,要分清“类比”和“定义”。我们用水果分类来打比方,是为了帮你理解“样本”(数据)和“标签”(答案)的关系。但这只是比喻,不是严格定义。在真实复杂的AI系统中,数据可能包含成千上万种特征,标签也不一定是简单的“苹果”或“橘子”,可能是连续的数字或复杂的类别。所以,别把生活例子当成万能钥匙,它只适用于帮助初学者建立直观印象,不能替代对抽象概念的精确定义。 其次,警惕“从一个例子推出无条件保证”。如果你看到几个红苹果,就断定“所有红色的水果都是苹果”,这是错误的归纳。机器学习模型也是从大量数据中寻找规律,而不是记住每一个单独的例子。模型可能会犯错,比如把红色的番茄误认为苹果,或者把青苹果漏掉。因此,不能因为模型在几个测试例子上表现好,就保证它在所有未知情况下都绝对正确。模型的性能是有边界的,它依赖于训练数据的代表性和多样性。 最后,明确“认识一条数据与希望预测的答案”这一核心。样本是输入的信息,标签是我们希望模型给出的预测结果。类比帮助我们理解这种“输入-输出”的关系,但不能让我们忽视模型的局限性。AI不是人类大脑,它没有真正的“理解”,只是基于统计规律进行匹配。所以,在使用或学习AI时,既要利用类比降低理解门槛,又要清醒认识到类比的局限性和模型预测的不确定性。保持这种批判性思维,才能更准确地掌握机器学习的基础概念。
6. 小练习与参考答案
小练习
标有苹果的水果记录中,苹果是什么?
参考答案
苹果是标签;颜色、重量等可作为输入特征。
请说明答案的适用边界,不把模型输出当作事实保证。
参考文献
- Google for Developers. Machine Learning Crash Course. https://developers.google.com/machine-learning/crash-course 来源
Paragoger衍生者AI训练营。发布者:稻草人,转载请注明出处:https://www.shxcj.com/archives/10396