本文属于《AI 深度培训》系列 · 难度:专家 · 篇幅:约 7000 字
本文系统推导 Transformer 核心机制,从缩放点积注意力的数值稳定性出发,深入解析多头子空间分解、因果掩码下的自回归训练,以及残差连接与归一化的工程权衡。通过量化计算复杂度与显存开销,厘清架构设计背后的数学逻辑与硬件约束,为理解大模型预训练及推理优化奠定坚实基础。
目录
1. 导读:为什么注意力取代了循环结构
在深度学习的早期阶段,循环神经网络(RNN)及其变体(如 LSTM、GRU)是处理序列数据的主流架构。然而,RNN 存在两个根本性的工程与理论瓶颈:一是顺序依赖,二是并行瓶颈。 顺序依赖意味着计算当前时刻的隐藏状态 h_t 必须依赖上一时刻的状态 h_t-1。这种链式结构导致信息传递路径极长,使得长距离依赖关系难以有效捕获,且梯度在反向传播时容易消失或爆炸。尽管残差连接和门控机制在一定程度上缓解了这些问题,但并未从根本上改变其串行计算的本质。 并行瓶颈则更为致命。现代硬件(如 GPU 和 TPU)的设计初衷是大规模并行计算。RNN 的串行特性使得在训练阶段无法充分利用硬件的并行能力,导致训练速度极慢,难以扩展到大规模数据集和长序列场景。相比之下,卷积网络虽然可以并行,但其感受野受限于卷积核大小,难以直接建模全局依赖。 注意力机制(Attention Mechanism)的引入彻底改变了这一局面。在(Vaswani et al., 2017)中,作者提出了 Transformer 架构,完全摒弃了循环和卷积结构,仅依靠自注意力机制来建模序列依赖。注意力机制可以被视为一种内容寻址的软检索:它允许模型中的每个位置直接关注序列中的其他所有位置,从而在一步之内建立全局依赖关系。这种机制不仅解决了长距离依赖问题,还极大地提升了训练和推理的并行度。 从直觉上看,注意力机制类似于一个动态的“软指针”,它根据查询(Query)与键(Key)的相似度,对值(Value)进行加权求和。这种加权过程是内容驱动的,而非位置驱动的,使得模型能够灵活地捕捉语义相关性。
本文路线图
为了帮助读者系统性地理解 Transformer 的核心机制,本文将按照以下路线展开:
- 缩放点积注意力:深入剖析 Q/K/V 的定义、缩放因子的必要性以及 Softmax 的数值稳定性技巧。
- 多头注意力:探讨子空间分解、参数量估算以及 MQA/GQA 等优化策略。
- 因果掩码与自回归训练:解析上三角掩码的作用、Teacher Forcing 机制以及训练与推理的差异。
- 残差、归一化与前馈网络:对比 Post-LN 与 Pre-LN 的梯度特性,分析 LayerNorm/RMSNorm 及 FFN 的结构设计。
- 复杂度分析:从计算量、显存占用和序列长度的角度,全面评估 Transformer 的工程成本。
- 小结与思考题:回顾关键公式,并提供三道具有挑战性的思考题以巩固理解。
通过本文的学习,读者将能够掌握 Transformer 架构的数学原理、工程实现细节以及性能优化策略,为后续的大模型预训练、对齐和推理优化奠定坚实基础。
2. 缩放点积注意力:公式、缩放因子与 Softmax 数值稳定
在 Transformer 架构中,自注意力机制通过查询(Query)、键(Key)和值(Value)三个矩阵实现了序列内部的信息交互。假设输入序列长度为 n,模型维度为 d_model。我们将输入矩阵 X 分别乘以三个可学习的投影矩阵 W_Q、W_K 和 W_V,得到形状均为 (n, d_k) 的 Q、K、V 矩阵。其中 d_k 通常为 d_model 除以头数 h。 缩放点积注意力的核心公式如下:
Attention(Q, K, V) = softmax(QKᵀ / √d_k) · V
如下图所示,该计算过程首先计算 Q 与 K 的转置乘积,随后进行缩放和 Softmax 归一化,最后加权求和 V。 为什么除以 √d_k? 这一缩放因子源于对点积分布特性的数学分析。假设 Q 和 K 中的元素是独立同分布的随机变量,均值为 0,方差为 1。那么 Q 和 K 的点积 q·k 是 d_k 个独立随机变量乘积之和。根据概率论,点积的方差为 d_k。 当 d_k 较大时,点积的数值范围会显著扩大,导致 Softmax 函数的输入进入饱和区(接近正无穷或负无穷)。在饱和区,Softmax 的梯度变得极其微小,甚至为零,从而引发梯度消失问题,阻碍模型训练。 除以 √d_k 后,点积的方差被归一化为 1,使得 Softmax 的输入分布更加集中,梯度流动更加稳定。这一推导在原始论文中有详细阐述(Vaswani et al., 2017)。 Softmax 的数值稳定性技巧 在实际工程中,直接计算 exp(x_i) 可能导致浮点数溢出(Overflow),特别是当 x_i 为较大的正数时。为了保持数值稳定,通常采用“减最大值”技巧:
def stable_softmax(x):
    # x 是 (n, n) 的注意力分数矩阵
    max_x = max(x, axis=-1, keepdims=True)  # 每行(每个查询)取最大值
    exp_x = exp(x - max_x)  # 减去最大值,防止溢出
    sum_exp = sum(exp_x, axis=-1, keepdims=True)
    return exp_x / sum_exp
由于 softmax(x) = softmax(x - c) 对任意常数 c 成立,减去最大值 max(x) 不会改变最终的概率分布,但能将指数函数的输入范围限制在 (-∞, 0] 之间,确保 exp 值始终小于等于 1,从而避免溢出。 注意力矩阵的行随机性 Softmax 操作确保了注意力矩阵的每一行(对应一个查询位置)的元素之和为 1,且所有元素非负。这意味着每个查询位置对序列中其他位置的注意力权重构成一个概率分布。这种“行随机性”使得注意力机制可以被视为一种软检索(Soft Retrieval):模型不是硬性地选择某个位置,而是根据相关性加权聚合信息。这种特性使得注意力机制能够并行处理序列中的所有位置,克服了 RNN 顺序依赖的瓶颈。
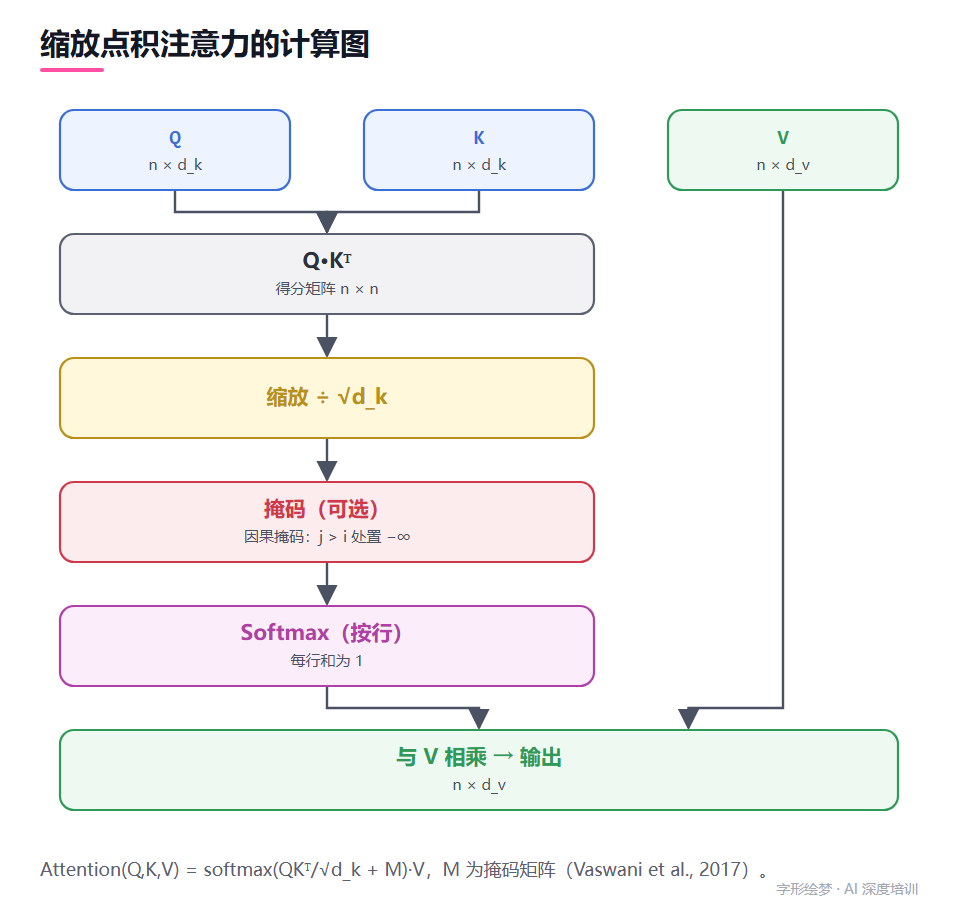
Attention(Q,K,V) = softmax(QKᵀ/√d_k + M)·V,M 为掩码矩阵(Vaswani et al., 2017)。
3. 多头注意力:子空间分解与参数量
在单头注意力中,Query、Key 和 Value 向量在同一高维空间中进行匹配与聚合。然而,单一线性投影往往难以同时捕捉序列中多种不同语义关系(如语法依赖、指代消解、长程语义关联等)。多头注意力(Multi-Head Attention, MHA)的核心直觉在于:将模型维度 d_model 分割为 h 个低维子空间,让每个头独立学习一种特定的“注意力模式”,最后再拼接并线性变换回原维度。这相当于在特征空间中进行了一次并行化的子空间分解。
1. 维度分配与形状定义
设模型隐藏层维度为 d_model,注意力头数为 h。为了保持计算量与单头(若 d_k=d_model)相当,通常设定每个头的维度 d_k = d_v = d_model / h。 对于输入序列 X ∈ ℝ^n × d_model(n 为序列长度),多头注意力的计算流程如下:
- 线性投影:分别将
X投影到Q, K, V空间。注意,这里的投影矩阵不再是单个d_model × d_model矩阵,而是分头处理的。 - 分头计算:将
Q, K, V沿特征维度切分为h份,每份形状为n × d_k。 - 并行注意力:对每个头
i独立执行缩放点积注意力。 - 拼接与输出投影:将
h个头的输出拼接(Concatenate),形状变为n × (h · d_v) = n × d_model,最后通过一个线性层W_O变换。
# 伪代码:多头注意力前向传播
def multi_head_attention(X, W_Q, W_K, W_V, W_O, h, d_k):
    n = X.shape[0]
    # 1. 投影:X (n, d_model) -> Q, K, V (n, d_model)
    Q = X @ W_Q
    K = X @ W_K
    V = X @ W_V
    # 2. 重塑为多头:(n, d_model) -> (h, n, d_k)
    # 假设 d_model = h * d_k
    Q = Q.reshape(n, h, d_k).transpose(1, 0, 2)
    K = K.reshape(n, h, d_k).transpose(1, 0, 2)
    V = V.reshape(n, h, d_k).transpose(1, 0, 2)
    # 3. 计算每个头的注意力输出 (h, n, d_k)
    outputs = []
    for i in range(h):
        # 缩放点积注意力
        scores = Q[i] @ K[i].T / sqrt(d_k)
        attn_weights = softmax(scores)
        out_i = attn_weights @ V[i]
        outputs.append(out_i)
    # 4. 拼接:h 个 (n, d_k) 沿最后一维拼成 (n, d_model)
    concat_out = concatenate(outputs, axis=-1)
    # 5. 输出投影
    Y = concat_out @ W_O
    return Y
2. 参数量分析
多头注意力的参数量主要来源于四个投影矩阵:W_Q, W_K, W_V ∈ ℝ^d_model × d_model 和 W_O ∈ ℝ^d_model × d_model。
- 单个矩阵参数量:
d_model^2 - 总参数量:
4 · d_model^2
值得注意的是,无论头数 h 如何变化,只要 d_k · h = d_model,投影矩阵的总参数量保持不变。这意味着增加头数并不增加参数开销,而是增加了计算图的并行度和特征分解的粒度。在原始 Transformer base 模型中,d_model=512,h=8,则每个头的 d_k=64,注意力层参数量为 4 × 512^2 ≈ 1.05 × 10^6(Vaswani et al., 2017)。
3. 头的分工与冗余性
虽然理论上每个头可以学习不同的子空间,但实证研究表明,多头机制中存在显著的冗余性。部分头可能学习相似的模式,或者某些头在推理过程中贡献极小。这种冗余性带来两个工程启示:
- 可剪枝性:在模型压缩中,可以直接移除部分注意力头而不显著降低性能,前提是保留信息量最大的头。
- KV 共享的动机:在解码阶段,Key 和 Value 矩阵需要被缓存(KV Cache)以供后续 token 生成使用。由于
K和V的参数量与Q相同(均为d_model^2),且每个头独立存储 KV,导致显存占用随序列长度线性增长。
4. 从 MHA 到 MQA/GQA:KV 共享
为了缓解解码时的显存瓶颈,研究者提出了多查询注意力(Multi-Query Attention, MQA)和分组查询注意力(Grouped-Query Attention, GQA)。
- MQA (Shazeer, 2019):所有
h个 Query 头共享同一个 Key 和 Value 头。即W_K, W_V ∈ ℝ^d_model × d_k(而非d_model)。这将 KV Cache 的大小减少了h倍,显著提升了推理吞吐量。 - GQA (Ainslie et al., 2023):作为 MHA 和 MQA 的折中方案,将
h个 Query 头分为g组(1 < g < h),每组共享一对 Key 和 Value。例如,若h=32, g=8,则每 4 个 Query 头共享 1 对 KV。GQA 在保持接近 MHA 性能的同时,大幅降低了 KV Cache 显存占用,已被许多现代大模型采用,例如 Llama 2 的 34B 与 70B 模型(Touvron et al., 2023)。
工程提示:在实现 GQA 时,需注意
W_K和W_V的输出维度变为g · d_k,而在计算注意力分数时,需要将K和V沿头维度复制(或广播)以匹配Q的头数,或者在矩阵乘法中直接处理非对齐维度(取决于硬件支持)。
小结
多头注意力通过子空间分解提升了模型的表达能力,其参数量固定为 4d_model^2,与头数无关。然而,解码阶段的 KV Cache 瓶颈促使了 MQA 和 GQA 等共享机制的发展,它们在精度与效率之间取得了更好的平衡。
4. 因果掩码与自回归训练
自回归语言建模的核心假设是:给定前文 x_<t,预测下一个 token x_t。在 Transformer 架构中,这一假设通过因果掩码(Causal Mask)得以实现,从而允许模型在训练阶段并行处理整个序列,而非像 RNN 那样逐步迭代。
因果掩码与上三角 −∞ 机制
在解码器(Decoder)的自注意力计算中,我们需要确保位置 i 只能关注位置 j ≤ i 的信息,严禁“窥探”未来的 token。如下图所示,因果掩码在注意力分数矩阵中体现为一个上三角区域。
位置 i \ j | 1    2    3    4
-----------+------------------
    1      |  0   -∞   -∞   -∞
    2      |  0    0   -∞   -∞
    3      |  0    0    0   -∞
    4      |  0    0    0    0
具体实现上,我们在计算 softmax(QKᵀ/√d_k) 之前,将注意力分数矩阵 S 的上三角部分(即 j > i 的位置)填充为负无穷大(-∞)。由于 exp(-∞) = 0,经过 Softmax 归一化后,这些位置的注意力权重严格为 0。这种操作在数值上是稳定的,且完全兼容 GPU 的并行矩阵乘法操作。
Teacher Forcing 与批量损失计算
传统的自回归生成是串行的:生成 x_1 后,将其作为输入生成 x_2。但在训练时,我们拥有完整的真实序列(Ground Truth)。Teacher Forcing 技术利用这一特性:将真实的前文序列作为输入,直接预测对应的下一个 token。 这意味着,对于长度为 n 的序列,我们可以在一次前向传播中,同时计算所有 n 个位置的预测概率。每个位置 i 的输出 h_i 都基于 x_1..i 计算,并通过交叉熵损失函数与真实标签 x_i+1 进行比较。
# 伪代码:并行计算所有位置的损失
# logits: [batch, seq_len, vocab_size]
# targets: [batch, seq_len] (真实序列,通常右移一位)
# 1. 因果掩码已在 Attention 层内部应用
# 2. 一次性计算所有位置的 log 概率
log_probs = F.log_softmax(logits, dim=-1)
# 3. 并行计算交叉熵,忽略 padding 部分
loss = F.nll_loss(log_probs.view(-1, vocab_size),
                  targets.view(-1),
                  ignore_index=PAD_TOKEN)
这种机制将原本 O(n) 的串行依赖转化为 O(1) 的并行计算(指单次前向传播中的步骤数),极大地提升了训练效率。
训练并行 vs 推理串行
这里存在一个关键的非对称性:
- 训练时(Training):输入是已知的完整序列。由于因果掩码的存在,位置
i的计算不依赖于位置i+1的输出,只依赖于其输入。因此,所有位置的注意力计算和 FFN 计算可以完全并行化。 - 推理时(Inference):输入是动态生成的。生成
x_t必须等待x_t-1的计算完成并作为输入。这是自回归生成的固有瓶颈,无法通过因果掩码消除,只能依靠 KV Cache、推测解码(Speculative Decoding)或线性注意力等优化手段缓解。
常见误区:认为因果掩码使得推理也能并行。实际上,掩码只保证了训练时的并行性;推理时的串行性是由“预测下一个 token 需要依赖前一个 token 的生成结果”这一自回归定义决定的,与掩码无关。
这种训练-推理的非对称性是 Transformer 架构设计中的核心权衡,也是后续各种高效推理优化(如 FlashAttention、PagedAttention)的出发点。
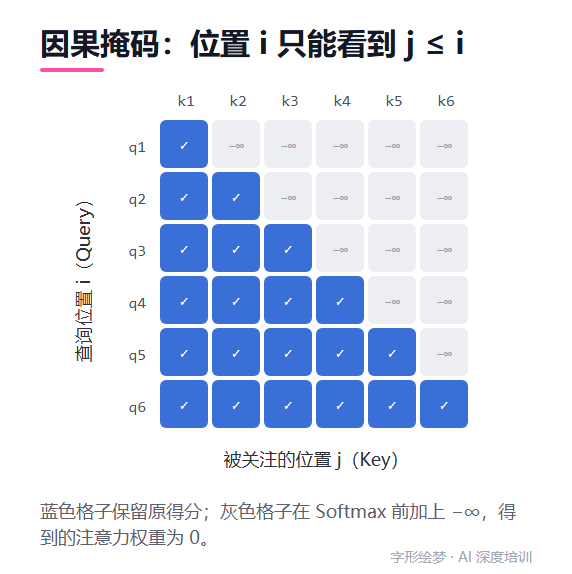
蓝色格子保留原得分;灰色格子在 Softmax 前加上 −∞,得到的注意力权重为 0。
5. 残差、归一化与前馈网络
在 Transformer 架构中,残差连接(Residual Connection)与归一化(Normalization)是保证深层网络梯度的关键组件。Vaswani et al. (2017) 提出的原始架构采用 Post-LN 结构,即先经过子层(注意力或 FFN),再相加残差,最后进行 LayerNorm:
y = LayerNorm(x + Sublayer(x))
然而,Xiong et al. (2020) 指出,Post-LN 在训练初期存在梯度不稳定问题,尤其是深层网络中,残差路径的梯度可能被归一化操作抑制。相比之下,Pre-LN 将归一化置于子层之前:
y = x + Sublayer(LayerNorm(x))
这种结构使得残差路径上的梯度可以直接流动,无需经过归一化的缩放,从而显著提升了训练稳定性,并允许使用更大的学习率而无需复杂的预热策略。如下图所示的 Pre-LN 解码器块,清晰地展示了这一顺序:输入先经过 LayerNorm,再进入注意力或 FFN 子层,最后与原始输入相加。
在归一化算法上,LayerNorm(Ba et al., 2016)对每个样本的特征维度进行均值和方差归一化:
LayerNorm(x)_i = (x_i - μ) / √(σ² + ε) · γ_i + β_i
其中 μ 和 σ² 是特征维度的均值和方差,γ 和 β 是可学习的缩放和偏移参数。Zhang & Sennrich (2019) 提出的 RMSNorm 进一步简化了这一过程,移除了均值中心化步骤,仅保留均方根(RMS)归一化:
RMSNorm(x)_i = x_i / √(mean(x²) + ε) · γ_i
RMSNorm 减少了计算开销,且在大多数任务中性能与 LayerNorm 相当,因此被广泛应用于现代大模型中。 前馈网络(FFN)是 Transformer 中的主要计算单元。原始架构采用两层线性变换加 ReLU 激活:
FFN(x) = max(0, xW₁ + b₁)W₂ + b₂
其中内层维度 d_ff 通常设为 4·d_model。Shazeer (2020) 提出的 SwiGLU 门控机制进一步提升了 FFN 的效率与性能,其结构为:
SwiGLU(x) = (Swish(xW₁) ⊙ xW₂) W₃
其中 ⊙ 表示逐元素乘法,Swish 是平滑的激活函数。SwiGLU 通过门控机制动态调节信息流,避免了 ReLU 的“死神经元”问题,同时在相同参数量下通常能获得更好的收敛效果。 每层 Transformer 的参数量估算如下:
- 注意力层:4 个投影矩阵(W_Q, W_K, W_V, W_O),每个为
d_model × d_model,共4·d_model²。 - FFN 层:两个线性层,
d_model × d_ff和d_ff × d_model,若d_ff = 4·d_model,则共8·d_model²。 - 归一化参数:可忽略不计。
因此,每层总参数量约为 12·d_model²。这一估算对于模型规模规划和显存分配至关重要,尤其在训练大规模模型时,需结合 Kaplan et al. (2020) 的缩放定律,合理选择 d_model、层数和 d_ff 以平衡性能与计算成本。
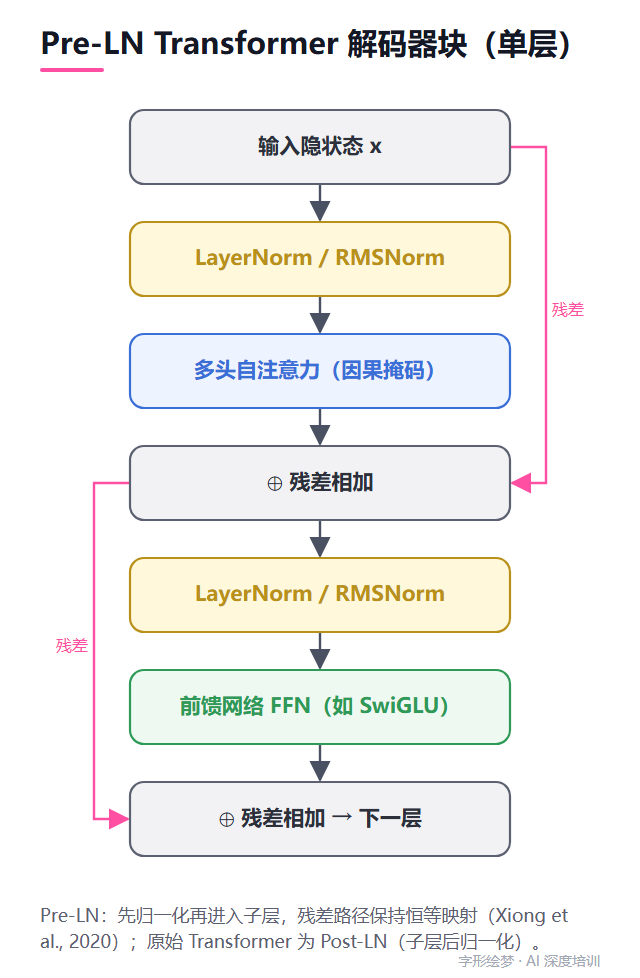
Pre-LN:先归一化再进入子层,残差路径保持恒等映射(Xiong et al., 2020);原始 Transformer 为 Post-LN(子层后归一化)。
6. 复杂度分析:计算量、显存与序列长度
在评估大模型架构效率时,核心在于权衡计算复杂度(FLOPs)与内存占用(显存)。对于自注意力机制与前馈网络(FFN),其计算成本随序列长度 n 和模型维度 d 的变化规律截然不同,这决定了模型在不同场景下的瓶颈所在。
1. 注意力与 FFN 的复杂度交叉点
自注意力的核心操作包括 QKᵀ 矩阵乘法和 S V 矩阵乘法。若忽略多头中的头数 h(因为 h · d_k = d),单层注意力的计算复杂度为 O(n^2 d)。相比之下,FFN 包含两个矩阵乘法,维度为 d → 4d 和 4d → d,其复杂度为 O(n · d^2)(假设 FFN 内层维度为 4d,这是常见配置)。 只看量级时,两者在 n^2·d ≈ n·d^2 即 n ≈ d 处同阶;但交叉点要带上常数系数才准确。按每次乘加记 2 FLOPs 精确计数(单层前向):QKV 与输出投影约 8·n·d^2,FFN 约 16·n·d^2,注意力得分 QKᵀ 与加权求和 PV 共约 4·n^2·d。令二者相等,得到交叉点(Crossover Point):
4·n^2·d ≈ 24·n·d^2
化简得:
n ≈ 6d
这意味着:
- 当序列长度
n < 6d时,投影与 FFN 的矩阵乘是主要计算量。 - 当序列长度
n > 6d时,注意力的n^2项成为主要计算量。
对于现代大模型(如 d_model = 4096 或更高),这一交叉点约在 n ≈ 6 × 4096 ≈ 24.6K token 处(采用因果掩码的融合内核可跳过约一半的注意力计算,交叉点相应后移)。因此,在处理长文本(如长文档摘要、代码生成)时,注意力的 O(n^2) 特性使得其成为性能优化的首要目标,这也是稀疏注意力、线性注意力等变体被广泛研究的原因。
2. 前向 FLOPs 估算
根据 Kaplan et al. (2020) 的 Scaling Laws 研究,对于标准的 Transformer 架构,每个 token 的前向传播计算量(FLOPs)近似为非嵌入参数量 N 的两倍:
FLOPs_forward ≈ 2N
这一近似成立的前提是:
- 参数量主要由线性层(注意力投影、FFN)贡献。
- 激活函数的计算开销相对较小。
- 上下文长度相对模型维度不太大(例如
n明显小于6d),使得与n相关的注意力项可以忽略;长上下文时需额外加上约4·L·n·d的注意力项(L 为层数)。
工程含义:
- 在推理阶段,若已知模型参数量
N(例如 7B 参数),则每生成一个 token 的理论计算量约为14 × 10^9FLOPs。 - 小批量自回归解码通常受内存带宽限制(Memory-Bound)而非计算能力(Compute-Bound):每生成一个 token 都要把全部权重和 KV Cache 从显存读一遍,而对应的计算量很小。
3. 激活显存与重计算(Activation Memory & Recomputation)
训练时的显存占用不仅包括模型参数(Θ)和优化器状态(≈ 2Θ),还包括激活值(Activations)。激活值用于反向传播计算梯度,其大小与序列长度 n、批大小 B 和隐藏维度 d 成正比。 对于 L 层 Transformer,单层激活显存主要来源于:
- 注意力输出:
B · n · d - FFN 中间层:
B · n · 4d - 注意力分数矩阵:
B · h · n · n(若未使用 FlashAttention 等优化,此项在长序列下巨大)
重计算(Activation Checkpointing) 是一种以时间换空间的策略:
- 做法:在前向传播中只保存部分激活值(如每层输入的隐状态),在反向传播时重新计算未保存的中间激活值。
- 代价:反向传播时需要把未保存的激活重算一遍;若每层都重算,相当于多做一次前向。由于前向约占“前向+反向”的 1/3(2N 对 6N),训练总计算量约增加 1/3,换来激活显存的大幅下降。
- 适用场景:当显存不足以容纳完整激活值,但计算资源相对充裕时。
常见误区: 1. 混淆 FLOPs 与延迟:FLOPs 衡量计算量,但推理延迟往往受限于内存带宽(尤其是 KV Cache 的读取)。 2. 忽视 KV Cache 增长:在自回归推理中,KV Cache 随生成步骤线性增长,其显存占用可能超过模型参数本身,尤其在长上下文场景下。 3. 误用重计算:在计算受限(Compute-Bound)的场景下使用重计算可能得不偿失,需根据硬件特性权衡。
小结
- 复杂度交叉点:按量级是
n ≈ d,带系数精确计数约为n ≈ 6d,超过后注意力成为计算主项。 - FLOPs 估算:
FLOPs ≈ 2N是快速估算前向计算量的有效工具。 - 显存优化:重计算是缓解激活显存压力的关键手段,但需权衡计算开销。
7. 小结与思考题
关键公式与结论回顾
在深入工程实现之前,我们需要对 Transformer 的核心数学结构进行一次紧凑的回顾。这些公式不仅是代码实现的蓝图,更是理解模型行为边界的基石。 首先,缩放点积注意力(Scaled Dot-Product Attention)是信息交互的核心。其定义为 softmax(QKᵀ/√d_k)V。其中,缩放因子 1/√d_k 至关重要:当维度 d_k 较大时,点积 Q·K 的方差会随 d_k 线性增长,导致 Softmax 进入梯度极小的饱和区。除以 √d_k 将方差归一化至 1,保证了梯度的有效流动(Vaswani et al., 2017)。 其次,多头机制(Multi-Head Attention)本质上是特征子空间的并行分解。若模型维度为 d_model,头数为 h,则每个头的维度为 d_k = d_model/h。多头允许模型在不同子空间中同时关注不同的语义关系(如语法、指代、位置等),避免了单头注意力可能出现的平均化效应。尽管引入了额外的投影矩阵 W_Q, W_K, W_V, W_O,总参数量为 4·d_model²(不计偏置),与头数 h 无关。 在归一化与激活方面,现代大模型普遍采用 Pre-LN 结构。相较于原始论文中的 Post-LN,Pre-LN 将 LayerNorm 置于子层之前,显著改善了梯度传播路径,使得训练更加稳定,降低了对学习率预热(Warmup)的依赖(Xiong et al., 2020)。此外,FFN 层通常采用 4 倍维度扩张,并常配合 SwiGLU 等门控线性单元,以增强非线性表达能力(Shazeer, 2020)。 最后,关于计算复杂度,对于长度为 n、维度为 d 的序列,注意力计算量为 O(n²·d),而 FFN 为 O(n·d²)。在长序列场景下,注意力成为主要瓶颈。根据缩放定律,每个 token 的前向推理计算量约为 2N FLOPs(N 为非嵌入参数量),训练则约为 6N(Kaplan et al., 2020)。这一线性关系是评估模型规模与算力需求的基础。
深度思考题
为了检验对上述原理的深层理解,以下三道题目从数值稳定性、架构权衡和系统瓶颈三个维度展开: 1. 数值稳定性与梯度消失
问题:假设我们将注意力公式中的缩放因子
1/√d_k移除,直接计算softmax(QKᵀ)V。当d_k从 64 增加到 1024 时,Softmax 输出的分布会发生什么变化?这种变化如何影响反向传播中的梯度大小?请结合 Softmax 的导数形式进行定性分析。 提示:考虑点积Q·K的方差随d_k增长的特性,以及 Softmax 在输入值差异极大时,其输出趋近于 One-Hot 向量对梯度的抑制作用。
2. 架构权衡:MQA/GQA 的推理加速
问题:在多查询注意力(MQA)或分组查询注意力(GQA)中,多个 Query 头共享同一组 Key 和 Value 头。这种设计如何影响 KV Cache 的显存占用?在训练阶段,这种共享机制是否会破坏多头注意力原本提供的“子空间多样性”?如果会,如何通过初始化或训练策略缓解? 提示:对比标准 MHA 中 KV Cache 的大小与 MQA/GQA 中的比例关系;思考共享权重是否限制了模型捕捉不同语义关系的能力,以及 Ainslie et al. (2023) 中提到的从 MHA 检查点迁移至 GQA 的方法。
3. 长序列的扩展瓶颈
问题:当序列长度
n远大于模型维度d时(例如n > 10d),注意力机制的计算复杂度O(n²·d)将远超 FFN 的O(n·d²)。在这种情况下,单纯增加模型维度d对降低每 token 推理成本是否有效?为什么?请从 FLOPs 公式的角度解释,并指出此时优化推理性能的主要方向应是什么。 提示:分析2NFLOPs 公式中,注意力部分参数量与序列长度的关系;考虑稀疏注意力、线性注意力或 FlashAttention 等算法对n²项的优化潜力。
参考文献
- Vaswani et al., 2017. Attention Is All You Need. arXiv:1706.03762 arxiv.org/abs/1706.03762
- Ba, Kiros, Hinton, 2016. Layer Normalization. arXiv:1607.06450 arxiv.org/abs/1607.06450
- Xiong et al., 2020. On Layer Normalization in the Transformer Architecture. arXiv:2002.04745 arxiv.org/abs/2002.04745
- Zhang & Sennrich, 2019. Root Mean Square Layer Normalization. arXiv:1910.07467 arxiv.org/abs/1910.07467
- Shazeer, 2020. GLU Variants Improve Transformer. arXiv:2002.05202 arxiv.org/abs/2002.05202
- Shazeer, 2019. Fast Transformer Decoding: One Write-Head is All You Need. arXiv:1911.02150 arxiv.org/abs/1911.02150
- Ainslie et al., 2023. GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints. arXiv:2305.13245 arxiv.org/abs/2305.13245
- Kaplan et al., 2020. Scaling Laws for Neural Language Models. arXiv:2001.08361 arxiv.org/abs/2001.08361
- Touvron et al., 2023. Llama 2: Open Foundation and Fine-Tuned Chat Models. arXiv:2307.09288 arxiv.org/abs/2307.09288
Paragoger衍生者AI训练营。发布者:稻草人,转载请注明出处:https://www.shxcj.com/archives/10338