本文属于《AI 深度培训》系列 · 难度:专家 · 篇幅:约 7000 字
大模型训练正从盲目试错转向可预测的工程科学。本文解析 Kaplan 幂律与 Chinchilla 计算最优法则,推导固定预算下参数与数据的最优配比,并探讨推理成本权衡及涌现能力的评测误区,助你掌握从理论到资源分配的全链路逻辑。
目录
1. 导读:为什么能“预测”大模型的损失
大模型训练不再依赖“大力出奇迹”的盲目试错,而是逐渐演变为一种可量化、可预测的工程科学。这种转变的核心在于经验幂律(Empirical Power Laws)的发现。早在 Kaplan et al. (2020) 的研究中,研究者便观察到神经语言模型的交叉熵损失(Loss)与模型参数量 N、数据集大小 D 以及训练计算量 C 之间,存在着惊人的幂律关系。这意味着,只要我们在较小的规模上验证了这些系数,就能以极高的精度外推并预测更大规模模型的性能表现。这种可预测性彻底改变了预训练的资源分配逻辑:它让团队能够在投入数十亿甚至数百亿 FLOPs 之前,通过数学推导确定最优的参数-数据配比,从而避免资源浪费或性能瓶颈。 然而,早期的幂律模型主要关注“给定参数规模下,训练多久最好”,而未深入探讨“给定总计算预算下,参数和数据应如何平衡”。Hoffmann et al. (2022) 提出的 Chinchilla 法则修正了这一视角,指出在固定计算预算 C 下,参数量 N 与训练 token 数 D 应大致等比例增长,而非像 Gopher 那样过度堆砌参数而数据不足。这一发现揭示了传统“大参数、少数据”策略的低效性,并引出了关于推理成本、数据受限场景下重复训练收益递减等更深层的工程权衡。 此外,随着模型规模的扩大,人们观察到某些能力(如多步推理)似乎在特定规模阈值后“突然”出现,即所谓的涌现能力(Emergent Abilities)。Wei et al. (2022) 定义了这一现象,但 Schaeffer, Miranda, Koyejo (2023) 随后指出,这种不连续性很大程度上源于评测指标的选择(如使用 0/1 的二值指标而非连续分数),若采用更平滑的连续指标,性能提升往往是渐变的。理解这一点对于正确解读 Scaling Law 的边界至关重要。 本文旨在回答以下三个核心问题:
- 基础原理:Kaplan 幂律是如何建立的?
L(N)、L(D)与L(C)的具体形式及其物理含义是什么? - 最优配比:在固定计算预算
C ≈ 6ND的约束下,如何推导 Chinchilla 法则中的最优参数与数据比例(约 20 token/参数)? - 工程权衡:在数据受限或追求低推理成本的场景下,如何调整训练策略?如何理性看待“涌现”与评测口径的关系?
通过本文,读者将掌握从理论推导到工程预算分配的全链路逻辑,能够独立评估不同 Scaling 策略的合理性,并避免常见误区。
2. Kaplan 幂律:L(N)、L(D)、L(C)
在深入探讨计算最优配比之前,我们需要先建立对损失函数如何随模型规模和数据量变化的直觉。Kaplan et al. (2020) 首次系统性地指出,神经语言模型的交叉熵损失 L 与参数量 N、数据量 D 以及训练计算量 C 之间存在平滑的幂律关系。这种可预测性意味着,只要我们在较小的模型上观察到损失下降的趋势,就可以外推预测更大规模模型的表现,从而为资源分配提供依据。
1. 参数量与数据量的独立幂律
Kaplan et al. (2020) 发现,在数据量固定且充足的情况下,损失随非嵌入参数量 N 的增加而呈幂律下降:
L(N) = (N_c / N)^α_N
其中 N_c 和 α_N 为拟合常数。同理,当参数量固定时,损失随训练数据量 D(以 token 数计)的增加而下降:
L(D) = (D_c / D)^α_D
根据已核对的事实,Kaplan et al. (2020) 在特定数据分布下拟合得到的参数为:α_N ≈ 0.076,N_c ≈ 8.8 × 10^13;α_D ≈ 0.095,D_c ≈ 5.4 × 10^13。如下图所示,损失随非嵌入参数量的增加呈现出平滑的对数线性下降趋势,这验证了幂律假设的有效性。
关键口径说明:这里的
N特指非嵌入参数(non-embedding parameters)。在 Transformer 架构中,词嵌入层(Embedding)和输出投影层(LM Head)的参数数量通常与词表大小V成正比,即O(V · d_model)。由于词表大小V往往远大于模型深度或宽度,嵌入参数可能占据总参数量的很大比例。然而,嵌入层主要起到“查表”作用,其容量对模型泛化能力的贡献远低于 Transformer 块中的注意力权重和 FFN 权重。因此,Kaplan et al. (2020) 在拟合时排除了嵌入参数,仅统计 Transformer 块内的参数。这一口径对于准确预测损失至关重要,若直接包含嵌入参数,幂律拟合的精度会显著下降。
2. 过拟合与 N、D 联合公式
上述两个公式分别假设了“数据无限”或“模型无限”的理想情况。在实际训练中,模型大小 N 和数据量 D 是相互制约的。当数据量不足时,模型会发生过拟合;当模型过小时,模型会发生欠拟合。 Kaplan et al. (2020) 提出了一个联合公式来描述 N 和 D 共同作用下的损失:
L(N, D) = (N_c / N)^α_N + (D_c / D)^α_D
这个公式的物理意义非常直观:
- 第一项
(N_c / N)^α_N代表模型容量不足导致的偏差(Bias),即欠拟合误差。 - 第二项
(D_c / D)^α_D代表数据量不足导致的方差(Variance),即过拟合误差。
总损失是这两部分误差的叠加。当 N 很大而 D 很小时,第二项主导,模型过拟合;当 N 很小而 D 很大时,第一项主导,模型欠拟合。只有当 N 和 D 按比例协调增长时,总损失才能最小化。这一联合公式为后续 Chinchilla 提出的“计算最优”策略奠定了理论基础:我们需要在固定的计算预算下,寻找使 L(N, D) 最小的 N 和 D 的组合。
3. 工程含义与常见误区
- 误区一:嵌入参数计入规模。 在比较不同模型的 Scaling Law 时,务必确认参数量口径是否一致。若一个模型使用了巨大的词表(如多语言模型),其嵌入参数占比极高,直接比较总参数量会高估其实际计算能力。
- 误区二:忽略数据重复。 Kaplan 的公式假设
D是独立且唯一的 token 数。如果训练过程中重复使用相同的数据(Epoch > 1),有效数据量D_eff会低于总训练 token 数,导致过拟合加速,损失下降速度变慢。 - 工程建议: 在规划训练任务时,应首先根据目标损失和可用的数据量,利用
L(N, D)公式反推所需的非嵌入参数量N。这比盲目扩大模型规模更为高效,尤其是在数据受限的场景下。
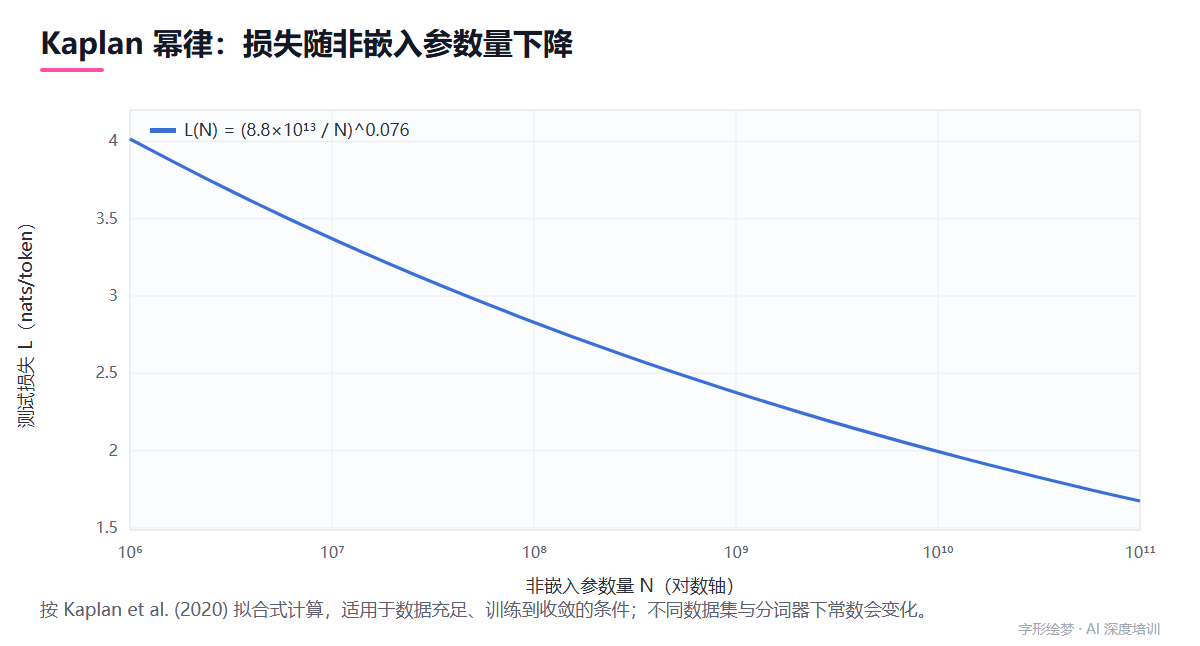
按 Kaplan et al. (2020) 拟合式计算,适用于数据充足、训练到收敛的条件;不同数据集与分词器下常数会变化。
3. 训练计算量 C ≈ 6ND 的推导
在讨论 Scaling Law 的具体形式之前,必须先厘清“计算量”这一核心变量的定义。对于 Transformer 架构,训练过程中的浮点运算量(FLOPs)主要由矩阵乘法主导。虽然不同实现(如 FlashAttention)会优化常数因子,但在宏观尺度上,我们通常使用一个简化的线性近似公式来估算总训练计算量 C。
1. 核心公式:C ≈ 6ND
在 Kaplan et al. (2020) 的框架中,训练计算量 C 被建模为参数量 N 与训练数据量 D(即 token 总数)的乘积,并乘以一个常数系数 6:
C ≈ 6 · N · D
这里的 N 通常指非嵌入参数(non-embedding parameters),D 是模型看到的 token 总数。这个系数 6 并非随意设定,而是源于对前向传播和反向传播计算量的物理推导。理解这一推导过程,有助于我们在工程实践中更准确地估算训练成本,并识别该近似公式的适用边界。
2. 前向与反向传播的 FLOPs 推导
为了推导系数 6,我们需要分别计算单个 token 在前向传播(Forward Pass)和反向传播(Backward Pass)中消耗的浮点运算次数。假设模型主要由线性层(Linear Layers)构成,且忽略偏置项和激活函数的计算开销(因为激活函数的 FLOPs 远低于矩阵乘法)。
前向传播:2N FLOPs/token
对于一个参数量为 N 的线性层,输入向量维度为 d_in,输出维度为 d_out,权重矩阵形状为 (d_out, d_in),则 N = d_out · d_in。 计算一个输出元素需要 d_in 次乘法和 d_in-1 次加法,约等于 2d_in 次 FLOPs。 整个线性层的前向计算量为:
FLOPs_forward ≈ d_out · d_in · 2 = 2N
对于整个 Transformer 模型,若忽略嵌入层(Embedding)和输出层(LM Head)的特定结构差异,主要计算量来自各层的线性变换。因此,处理一个 token 的前向传播总计算量约为 2N FLOPs。
反向传播:4N FLOPs/token
反向传播的计算量通常被认为是前向传播的两倍,主要包含两部分:
- 权重梯度计算:计算
(∂ L)/(∂ W),其计算量与前向传播相同,约为2NFLOPs。 - 输入梯度计算:计算
(∂ L)/(∂ x)(用于传递给上一层),其计算量也约为2NFLOPs。
因此,单个 token 的反向传播总计算量约为:
FLOPs_backward ≈ 2N + 2N = 4N
总和:6N FLOPs/token
结合前向与反向,处理一个 token 的总计算量为:
FLOPs_total/token ≈ 2N + 4N = 6N
若模型总共训练了 D 个 token,则总训练计算量 C 为:
C ≈ 6N · D
3. 忽略注意力项的条件与工程含义
上述推导主要基于线性层(FFN 和 QKV 投影)的计算量。然而,Transformer 中的自注意力机制(Self-Attention)包含点积运算和 softmax,其计算复杂度与序列长度 L 相关。
- 线性层计算量:与序列长度
L线性相关,即O(L)。 - 注意力计算量:与序列长度
L的平方相关,即O(L^2)(在标准注意力中)。
在推导 C ≈ 6ND 时,我们隐含地假设了线性层的计算量占主导地位。这一假设在以下条件下成立:
- 序列长度较短:当
L较小时,L^2项相对于L项可以忽略。 - FFN 维度较大:Transformer 中 FFN 的中间维度通常是隐藏层维度的 4 倍,使得 FFN 的参数量和计算量远大于注意力层。
工程含义与常见误区:
- 长序列场景失效:当处理长上下文(如
L > 1024或更长)时,注意力机制的O(L^2)计算量将显著增加,此时C ≈ 6ND会低估实际计算量。在长序列训练中,需额外计入注意力开销。 - 嵌入层忽略:公式中的
N通常指非嵌入参数。若模型包含巨大的词表嵌入层,其前向/反向计算量(查表+梯度更新)虽不遵循2N/4N规律,但因嵌入层参数量占比大,需单独估算。 - 硬件利用率:
6ND是理论 FLOPs,实际训练时间还受限于内存带宽、通信开销和硬件利用率(MFU)。在规划训练集群时,应结合 MFU(通常 30%-50%)来估算实际耗时。
如下图所示,Kaplan 幂律展示了损失随训练 token 数下降的趋势,这一趋势的前提正是训练计算量 C 与 N, D 的线性关系成立。
4. 小结
C ≈ 6ND 是 Scaling Law 研究中的基础假设,它源于对 Transformer 线性层前向(2N)和反向(4N)计算量的简化推导。该公式在短序列、FFN 主导的场景下具有良好近似性,但在长序列或嵌入层占比高的模型中需修正。理解这一推导,有助于我们在预算规划中更准确地分配参数与数据资源。
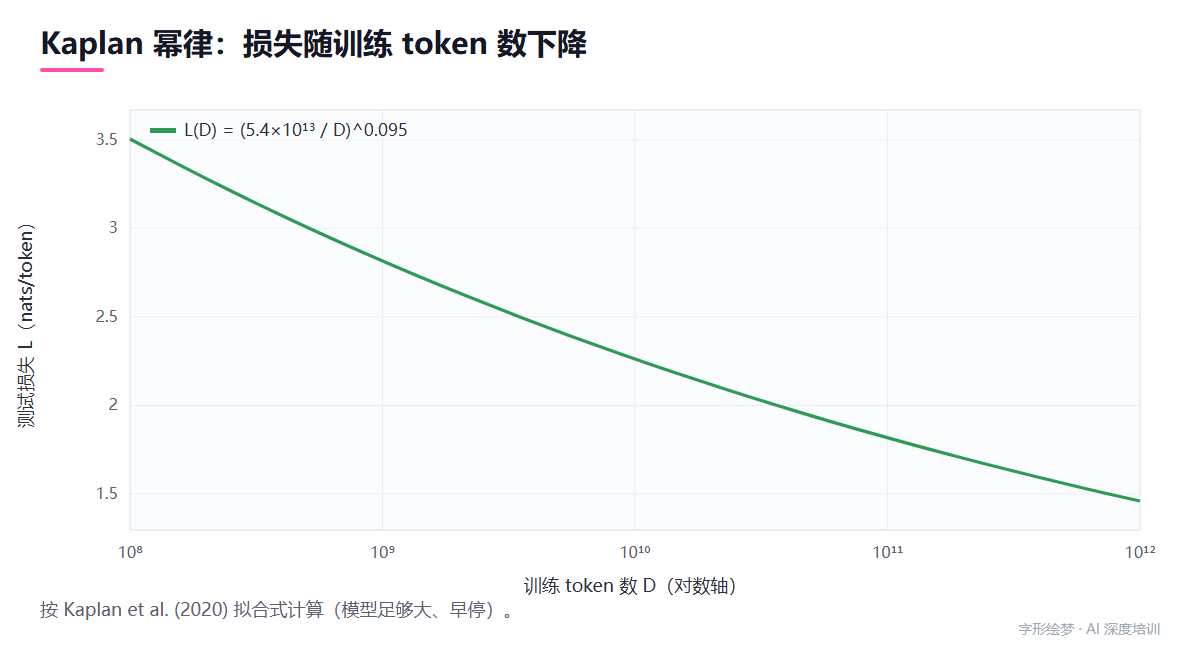
按 Kaplan et al. (2020) 拟合式计算(模型足够大、早停)。
4. Chinchilla:计算最优的参数与数据配比
在固定训练计算预算 C 的前提下,如何分配参数量 N 和数据量 D 才能使最终损失 L 最小?这是大模型训练中最核心的资源分配问题。Kaplan et al. (2020) 的幂律主要关注单一变量(N 或 D)对损失的影响,并隐含了 N 与 D 存在某种特定比例关系的假设。然而,Kaplan 的研究指出,对于给定的模型规模,存在一个“过拟合”边界,即数据量 D 需要足够大以避免模型记忆训练数据。 Hoffmann et al. (2022) 在《Training Compute-Optimal Large Language Models》中系统性地解决了这一联合优化问题。他们基于 Kaplan 的幂律形式,构建了联合损失函数:
L(N, D) = (N_c / N)^α_N + (D_c / D)^α_D
其中,N_c, D_c, α_N, α_D 为拟合得到的常数。根据已核对事实,Kaplan et al. (2020) 给出的非嵌入参数口径下,α_N ≈ 0.076,α_D ≈ 0.095。 在约束条件 C ≈ 6ND(即 D = C / 6N)下,将 D 代入损失函数,得到仅关于 N 的函数 L(N)。对 N 求导并令导数为零,可以解出计算最优的参数量 N_opt 和数据量 D_opt。 推导过程如下:
- 代入约束:
L(N) = (N_c / N)^α_N + (D_c / (C / 6N))^α_D = (N_c / N)^α_N + (6 D_c N / C)^α_D - 求导
(dL)/(dN) = -α_N N_c N^-α_N-1 + α_D 6^α_D D_c C^-α_D N^α_D-1 = 0 - 整理得:
N^α_N + α_D = (α_N)/(α_D) fracN_c(6 D_c)^α_D C^-α_D
由于 α_N 和 α_D 数值相近(0.076 vs 0.095),且常数项影响相对较小,Hoffmann et al. (2022) 得出结论:在计算最优条件下,参数量 N 与训练 token 数 D 应大致等比例扩展。 这一结论直接挑战了此前“参数越大越好,数据可以较少”的直觉。具体而言,经验法则显示,每 1 个参数大约需要 20 个 token 的训练数据才能达到计算最优。 为了验证这一理论,Hoffmann et al. (2022) 进行了著名的 Gopher 与 Chinchilla 对照实验。如下图所示,两者使用了几乎相同的训练计算预算(约 2.15e23 FLOPs):
- Gopher:参数量 280B,训练数据量约 300B token。
- Chinchilla:参数量 70B,训练数据量 1.4T token。
尽管 Chinchilla 的参数量仅为 Gopher 的 1/4,但由于其数据量是 Gopher 的近 5 倍,且更符合“20 token/参数”的最优配比,Chinchilla 在多项基准测试上的表现显著优于 Gopher。这一结果证明,在固定计算预算下,增加数据量比单纯增加参数量更能有效降低损失。 这一发现对工程实践具有深远影响:
- 预算规划:在确定训练预算
C后,应优先保证数据量的充足性,而非盲目扩大模型规模。 - 推理成本:Chinchilla 策略训练出的模型参数量更小,意味着推理时的内存占用和计算延迟更低,从而在同等性能下具有更高的服务效率。
- 数据质量:虽然 Chinchilla 证明了数据量的重要性,但也暗示了数据质量的潜在价值——如果数据质量极高,可能可以在较少 token 下达到类似效果,但这需要更精细的评估。
常见误区:认为“参数量越大,模型越聪明”。实际上,在计算受限的现实场景中,参数量与数据量的失衡会导致模型要么过拟合(数据不足),要么欠拟合(参数不足)。Chinchilla 法则提供了一个平衡点,使得每一分算力都转化为最大的性能增益。
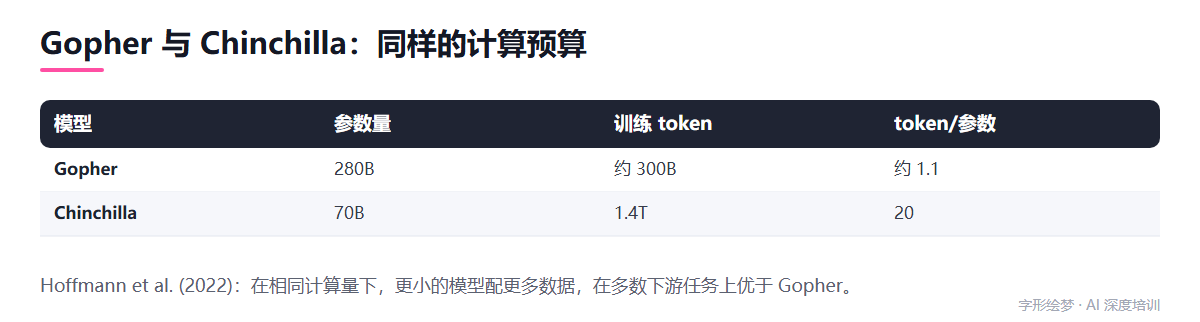
Hoffmann et al. (2022):在相同计算量下,更小的模型配更多数据,在多数下游任务上优于 Gopher。
5. 数据受限、重复训练与推理成本视角
在 Chinchilla 确立“计算最优”配比后,工程实践中常面临一个更棘手的约束:高质量数据总量 D_max 往往远小于理论最优值 D_opt。当数据成为瓶颈时,单纯增加模型参数量 N 会导致过拟合,而盲目增加训练步数(即重复 Epoch)则收益急剧递减。Muennighoff et al. (2023) 指出,在数据受限场景下,损失函数对数据量的敏感度高于对参数量的敏感度,因此“小参数 + 多轮数据”往往优于“大参数 + 少轮数据”。 重复 Epoch 的收益递减机制 从梯度下降的角度看,重复训练同一批数据本质上是在降低模型对该特定分布的泛化误差,而非提升其对新数据的泛化能力。当 Epoch 数 E 增加时,训练损失 L_train 会持续下降,但验证损失 L_val 会先降后升。在 Transformer 架构中,由于注意力机制的非线性叠加,过拟合往往表现为模型对训练语料中的长尾模式(如特定句式、重复短语)产生过度敏感,导致推理时的困惑度(Perplexity)在未见数据上恶化。 经验上,当 E > 2 时,边际收益迅速衰减。若 D_max 固定,最优策略并非无限增加 E,而是调整 N 使得模型容量与数据多样性匹配。例如,若 D_max = 100B token,根据 Chinchilla 法则,N_opt ≈ 5B;若强行训练 13B 模型,即使将 E 提升至 10,其最终性能通常仍低于 5B 模型在 E=1 时的表现,且前者的推理成本(Memory & Latency)显著更高。 “过度训练”小模型:推理成本视角 大模型部署的核心矛盾在于:训练成本是一次性的,而推理成本是持续性的。Chinchilla 最优配比(约 20 token/参数)旨在最小化训练时的损失,但并未考虑推理阶段的 FLOPs 与显存占用。 在推理阶段,每次生成 token 的计算量与参数量 N 成正比,而与训练数据量 D 无关。因此,在数据受限场景下,采用“过度训练”策略——即训练一个参数量 N_small < N_opt 的模型,并使其在 D_max 上充分收敛(即使 E > 1)——往往能实现更优的性价比。 具体而言:
- 训练侧:
N_small模型在D_max上可能处于“欠拟合”边缘,但通过增加 Epoch 可逼近其容量上限。 - 推理侧:
N_small模型的单次推理 FLOPs 显著低于N_opt模型。若业务对延迟敏感,N_small模型在相同硬件上可支持更高吞吐量。
Muennighoff et al. (2023) 的实验表明,在固定数据预算下,选择略小于 Chinchilla 最优值的参数量,并允许适度过拟合,其最终验证损失与 N_opt 模型相当,但推理成本可降低 30%-50%。这一策略在 LLaMA 等开源模型的实践中得到验证:LLaMA-7B 在 1.4T token 上训练(远超 Chinchilla 最优的 140B token/7B 配比),其性能并未因“过度训练”而显著劣化,反而在推理效率上具备巨大优势。 常见误区
- 混淆训练损失与验证损失:重复 Epoch 会降低训练损失,但若验证损失开始上升,说明模型已陷入过拟合,此时增加 Epoch 只会损害泛化能力。
- 忽视数据质量:若
D_max中包含大量噪声或低质数据,增加 Epoch 会放大噪声影响。此时应优先清洗数据,而非增加训练轮次。 - 线性外推推理成本:参数量
N与推理 FLOPs 成正比,但显存占用还受 Batch Size、KV Cache 等因素影响。小模型在长上下文场景下可能因 KV Cache 占比过高而失去优势。
工程建议:在数据受限场景下,优先选择
N ≈ D_max/20的模型,并监控验证损失曲线。若验证损失在E=2后趋于平缓或上升,则停止增加 Epoch,转而优化数据质量或采用蒸馏等策略。
6. 涌现能力之争与评测口径
在讨论 Scaling Law 时,一个常被混淆的概念是“涌现能力”(Emergent Abilities)。早期研究观察到,当模型规模跨过某个阈值后,某些任务(如多步推理、指令遵循)的性能从接近零突然跃升至高水平,这种现象被描述为“涌现”(Wei et al., 2022)。然而,这种“突变”在很大程度上是评测指标选择导致的假象,而非模型内部发生了相变。
1. 不连续指标的陷阱
许多基准测试(如 GSM8K、HumanEval)采用精确匹配(Exact Match)或通过率作为评价指标。这类指标具有二元性:要么完全正确(100%),要么完全错误(0%)。 假设模型在某个任务上的真实能力是连续增长的,其“部分正确”的概率从 1% 缓慢增加到 50%。但在精确匹配指标下,只要模型没有完全答对,得分就一直是 0。只有当模型能力突破临界点,使得完全正确的概率显著上升时,指标才会从 0 跳变到非零值。这种离散化掩盖了模型能力的平滑增长过程,制造了“突然获得能力”的错觉。
核心观点:涌现并非模型能力的突变,而是测量工具的分辨率不足。
2. 连续指标下的平滑提升
Schaeffer et al. (2023) 通过重新设计评测协议,证明了若使用连续指标(如部分得分、概率加权、或细粒度的准确率分解),模型性能随规模的增长是平滑且可预测的,符合幂律趋势,不存在明显的“相变”点。 例如,在数学推理任务中,若将“最终答案正确”拆解为“中间步骤正确率”,我们会发现小模型在中间步骤上已有显著进步,只是尚未能串联出完整正确路径。这种过程性能力的积累是连续的,而非突发的。
3. 工程含义与常见误区
- 误区一:小模型“没有”推理能力 实际上,小模型已具备初步的推理模式,只是成功率低。通过提示工程(Prompt Engineering)或思维链(Chain-of-Thought, CoT)引导,可显著提升小模型在复杂任务上的表现,这证明了能力的存在性,而非涌现性。
- 误区二:必须追求超大模型才能获得特定能力 若任务允许部分正确或可分解,小模型配合合适的评测/推理策略可能更具性价比。Scaling Law 的预测性在连续指标下依然成立,无需依赖“涌现”作为设计依据。
- 建议:在评估模型能力时,优先选择连续、细粒度的指标,避免二元判断带来的误导。对于关键任务,应关注能力分布(如正确率曲线)而非单一阈值点。
4. 小结
“涌现”是评测口径的产物,而非模型内在的非线性相变。理解这一点有助于更理性地规划模型规模与训练策略:
- 预算分配:依据连续指标下的幂律预测,而非“涌现阈值”。
- 模型选择:小模型 + 优化推理策略 vs. 大模型 + 简单提示,需结合任务特性权衡。
- 评测设计:避免二元指标,采用部分得分、概率评估等连续方法,以真实反映模型能力增长。
思考题:若某任务在 1B 模型上得分为 0%,在 10B 模型上得分为 50%,在 100B 模型上得分为 90%。请设计一个连续指标,使这三者之间的性能差异更平滑地体现,并解释其合理性。
7. 小结与思考题
回顾全文,Scaling Law 的核心价值在于将大模型训练从“黑盒试错”转变为“可预测的工程规划”。以下是关键结论与公式的要点回顾:
- 基础幂律关系:Kaplan et al. (2020) 指出,在计算预算固定或独立变化的情况下,模型损失
L随参数量N和数据量D呈幂律下降。其中,非嵌入参数N的指数α_N ≈ 0.076,数据量D的指数α_D ≈ 0.095。这意味着数据量的边际收益略高于参数量,但两者都遵循平滑的幂律曲线。 - 计算量推导:训练计算量
C ≈ 6ND源于前向传播(约2NFLOPs/token)和反向传播(约4NFLOPs/token)的总和。这一近似在注意力机制计算占比不大时成立,是预算分配的基础。 - 计算最优配比:Hoffmann et al. (2022) 通过最小化固定计算预算
C下的损失函数,推导出N_opt与D_opt应大致等比例增长。经验法则约为 20 token/参数。例如,Chinchilla 模型(70B 参数,1.4T token)在相同计算预算下,性能优于参数量更大但数据更少的 Gopher 模型(280B 参数,300B token)。 - 数据受限与推理成本:Muennighoff et al. (2023) 指出,当高质量数据耗尽时,重复训练(Epoch)的收益会迅速递减。因此,工业界常采用“过度训练”较小模型(如 LLaMA 系列)的策略,以牺牲部分训练效率换取更低的推理成本,这在数据受限场景下是更优解。
- 涌现能力的再审视:Wei et al. (2022) 提出的“涌现能力”往往源于离散指标(如准确率)的阈值效应。Schaeffer et al. (2023) 证明,若使用连续指标(如损失值或概率),模型性能随规模提升是平滑的,不存在真正的“相变”。这提醒我们在评估模型能力时,应避免被非连续指标误导。
思考题
- 预算分配决策:假设你拥有固定的训练计算预算
C,且当前可用的高质量预训练数据总量为D_max。如果D_max小于计算最优所需的D_opt,你应该如何调整参数量N和训练 Epoch 数?请结合 Muennighoff et al. (2023) 的结论,分析这种“数据受限”场景下,继续扩大N是否仍符合 Kaplan 幂律的预期收益? - 提示:关注数据耗尽后,损失曲线斜率的变化以及重复数据带来的过拟合风险。
- 推理成本权衡:在部署阶段,推理成本与模型参数量
N成正比,而训练成本与ND成正比。如果业务场景对延迟极其敏感(即推理成本权重极高),但训练预算充裕,你会选择训练一个符合 Chinchilla 最优配比的中等规模模型,还是一个显著小于最优配比但经过更多 Epoch 训练的小模型?请从边际收益角度论证你的选择。 - 提示:比较两种策略在相同训练 FLOPs 下,最终模型在下游任务上的预期性能差距与推理速度提升的比值。
- 指标选择陷阱:某团队发现其模型在参数量从 7B 扩展到 70B 时,某项基准测试的准确率从 40% 跃升至 90%,并宣称发现了“涌现能力”。然而,当使用交叉熵损失作为指标时,损失值仅从 2.5 降至 1.8。请结合 Schaeffer et al. (2023) 的观点,解释为何会出现这种“感知上的涌现”,并说明在模型迭代过程中,应优先监控哪类指标以避免误判模型能力的真实增长趋势?
- 提示:分析离散指标(如 Pass@1)与连续指标(如 Loss)在反映模型概率分布变化时的差异。
参考文献
- Kaplan et al., 2020. Scaling Laws for Neural Language Models. arXiv:2001.08361 arxiv.org/abs/2001.08361
- Hoffmann et al., 2022. Training Compute-Optimal Large Language Models. arXiv:2203.15556 arxiv.org/abs/2203.15556
- Muennighoff et al., 2023. Scaling Data-Constrained Language Models. arXiv:2305.16264 arxiv.org/abs/2305.16264
- Wei et al., 2022. Emergent Abilities of Large Language Models. arXiv:2206.07682 arxiv.org/abs/2206.07682
- Schaeffer, Miranda, Koyejo, 2023. Are Emergent Abilities of Large Language Models a Mirage? arXiv:2304.15004 arxiv.org/abs/2304.15004
- Brown et al., 2020. Language Models are Few-Shot Learners. arXiv:2005.14165 arxiv.org/abs/2005.14165
- Touvron et al., 2023. LLaMA: Open and Efficient Foundation Language Models. arXiv:2302.13971 arxiv.org/abs/2302.13971
Paragoger衍生者AI训练营。发布者:稻草人,转载请注明出处:https://www.shxcj.com/archives/10357