本文属于《AI 深度培训》系列 · 难度:专家 · 篇幅:约 7000 字
分词是连接连续文本与离散模型输入的关键桥梁,直接决定序列长度、词表规模及参数效率。本文深入剖析 BPE、WordPiece、Unigram 及字节级分词的原理,从直觉到算法推导,解析其如何平衡未登录词处理与计算开销。通过对比不同算法在中文、代码等场景下的压缩率差异,揭示词表设计对嵌入矩阵与推理性能的深层影响,助你构建高效的大模型数据预处理体系。
1. 导读:词、字符与子词的取舍
自然语言处理的核心挑战之一,在于如何将连续、无界的文本流映射为离散、有限的符号序列。这一过程即分词(Tokenization),它直接决定了模型输入序列的长度、词表规模以及参数效率。在深入探讨 BPE、WordPiece 等具体算法之前,必须厘清“词”、“字符”与“子词”三种粒度之间的本质权衡。 最直观的粒度是字符级分词。其优势在于词表极小(通常仅为数百个字符),从根本上消除了未登录词(OOV, Out-of-Vocabulary)问题,任何文本均可被完整编码。然而,其劣势同样显著:序列长度急剧膨胀。以中文为例,一个常用汉字对应一个 token,但英文单词平均长度约为 4-5 个字符,导致同等语义信息的序列长度增加 4 倍以上。由于 Transformer 的自注意力机制计算复杂度与序列长度平方成正比(O(N^2)),字符级分词会显著增加推理与训练的算力开销,且限制了上下文窗口的有效利用率。 另一种极端是词级分词。其优势是序列长度最短,语义单元完整,有利于模型捕捉句法结构。但词级分词面临严重的 OOV 问题:语言是开放集合,新词、专有名词、拼写错误在真实场景中无处不在。对于预训练大模型而言,词表无法穷尽所有可能的词汇,导致大量输入无法被有效编码。此外,词级词表通常高达数万甚至数十万,虽然比字符级大,但相比子词级仍显稀疏,且难以覆盖低频词。 子词(Subword) 分词正是为了解决上述矛盾而诞生。它介于字符与词之间,将高频词保持完整,将低频词或新词拆分为若干个子词单元(如 "unhappiness" 拆分为 "un", "happi", "ness")。BPE 算法的提出标志着子词分词在神经机器翻译中的成功应用(Sennrich et al., 2016)。子词分词的核心权衡在于:词表大小与序列长度的平衡。
- 词表大小(Vocabulary Size, V):决定了嵌入矩阵(Embedding Matrix)和输出投影层的参数量。参数量约为
2 × V × d_model(输入嵌入 + 输出头)。V 越大,模型能表示的语义单元越丰富,但参数量线性增长,显存占用增加。 - 序列长度(Sequence Length, N):决定了注意力计算的复杂度
O(N^2)和 KV Cache 的内存占用。N 越短,推理速度越快,长上下文能力越强。
子词分词通过调整训练时的合并规则,可以在给定的词表预算下,最小化平均序列长度。例如,LLaMA 系列模型采用 SentencePiece 的 BPE 模型,词表大小约为 32,000(Touvron et al., 2023),相比早期的词级分词,它在保持较短序列长度的同时,显著降低了 OOV 率。而 BERT 则采用 WordPiece 算法,词表约为 30,522(Devlin et al., 2018),其设计目标是在固定词表大小下,最大化语料库的似然概率。 因此,选择何种分词器,本质上是在参数效率(嵌入层大小)、计算效率(序列长度)和语义完整性(OOV 处理)三者之间寻找帕累托最优。对于多语言模型,还需考虑不同语言的压缩率差异:拉丁字母语言通常压缩率较高(一个 token 对应多个字符),而中文、日文等表意文字压缩率较低(一个 token 常对应一个字符或更少),这直接影响了多语言模型的词表设计策略。 本文后续将依次解析 BPE、WordPiece、Unigram 的训练机制,探讨字节级分词如何彻底消除 OOV,并分析词表大小对模型参数与任务性能的具体影响。
本文路线
- BPE 原理:基于频率统计的合并规则训练与编码过程。
- WordPiece 与 Unigram:基于似然增益与剪枝策略的子词选择。
- 字节级与 SentencePiece:无 OOV 的通用分词框架与空格处理。
- 工程权衡:词表大小、嵌入参数与压缩率的量化分析。
2. BPE:合并规则的训练与编码
BPE(Byte Pair Encoding)的核心思想是将分词视为一个迭代合并的过程:从字符级初始词表出发,统计语料中相邻符号对的频率,每次合并出现频率最高的一对,直到达到预设的词表大小。这种“贪心合并”策略在训练阶段决定了子词的粒度,而在编码阶段则通过重放合并顺序来还原分词结果。
训练过程:统计与合并
假设初始词表 V_0 包含所有字符及特殊标记(如 <unk>、<s>、</s>)。对于语料库中的每个句子,将其分解为字符序列。训练循环如下:
- 统计频率:遍历所有句子,统计所有相邻符号对
(a, b)的出现次数count(a, b)。 - 选择合并对:找到频率最高的对
(a^*, b^*)。 - 执行合并:将所有句子中的
a^* b^*替换为新符号a^*b^*,并将a^*b^*加入词表。 - 终止条件:重复上述步骤,直到词表大小达到目标值
V_target。
如下图所示,BPE 训练循环通过不断合并高频相邻对来扩展词表,最终形成包含高频子词和低频字符的混合词表。
def train_bpe(corpus, target_vocab_size):
    # 初始化:将每个句子拆分为字符列表
    # 假设 corpus 是 list[list[str]],每个内层列表是一个句子的字符序列
    vocab = set("".join(["".join(sent) for sent in corpus])) | {"<unk>", "<s>", "</s>"}
    merge_rules = []  # 存储合并规则 (a, b) -> a+b
    while len(vocab) < target_vocab_size:
        # 1. 统计当前语料中所有相邻符号对的频率
        pair_freq = {}
        for sent in corpus:
            for i in range(len(sent) - 1):
                pair = (sent[i], sent[i+1])
                pair_freq[pair] = pair_freq.get(pair, 0) + 1
        # 2. 找到频率最高的对
        if not pair_freq:
            break
        best_pair = max(pair_freq, key=pair_freq.get)
        # 3. 执行合并:替换语料中的 best_pair
        new_symbol = best_pair[0] + best_pair[1]
        for i, sent in enumerate(corpus):
            # 简单的字符串替换逻辑,实际工程中需处理重叠
            new_sent = []
            i = 0
            while i < len(sent):
                if i < len(sent) - 1 and (sent[i], sent[i+1]) == best_pair:
                    new_sent.append(new_symbol)
                    i += 2
                else:
                    new_sent.append(sent[i])
                    i += 1
            corpus[i] = new_sent
        # 4. 更新词表和规则
        vocab.add(new_symbol)
        merge_rules.append(best_pair)
    return vocab, merge_rules
编码过程:贪心应用
编码时,给定一个未登录词 w,BPE 并不直接查表,而是将其分解为字符序列,然后按照训练时记录的合并规则顺序,逐步应用合并操作,直到无法再合并或达到词表限制。
def encode_bpe(word, vocab, merge_rules):
    # 1. 初始化为字符序列
    # 假设 word 是字符串,如 "l-o-w-e-r"
    symbols = list(word)
    # 2. 按训练时的顺序应用合并规则
    for pair in merge_rules:
        # 检查当前符号序列中是否存在该对
        i = 0
        while i < len(symbols) - 1:
            if (symbols[i], symbols[i+1]) == pair:
                # 合并
                new_symbol = pair[0] + pair[1]
                symbols[i] = new_symbol
                symbols.pop(i+1)
            else:
                i += 1
    # 3. 检查最终符号是否在词表中
    # 如果不在,可能需要进一步拆分或使用 <unk>,但标准 BPE 通常保证可分词
    return symbols
复杂度分析
- 训练复杂度:每次迭代需要遍历整个语料库统计频率,时间复杂度为
O(N · L),其中N是词表扩展次数(即V_target - |V_0|),L是语料库平均长度。由于每次合并都改变语料结构,总复杂度较高,通常为O(N · N · L)或更优的实现可达O(N · L log N)。 - 编码复杂度:编码时需要遍历所有合并规则,每条规则在符号序列中查找匹配,最坏情况下时间复杂度为
O(|merge\_rules| · |word|)。由于|merge\_rules| ≈ V_target,编码速度受词表大小影响显著。
工程含义与误区
- 合并顺序依赖性:BPE 的编码结果依赖于合并规则的顺序。若两个对频率相同,不同随机种子可能导致不同的词表结构,进而影响模型性能。
- 长词编码效率:对于极长且罕见的词,BPE 可能生成大量子词,导致序列长度增加,影响注意力机制的计算效率。
- 不可逆性:BPE 合并是不可逆的,即从子词序列无法唯一还原原始字符序列(存在歧义),但在实际应用中,由于合并规则是确定的,编码结果是唯一的。
BPE 的优势在于其简单性和对 OOV 问题的天然解决能力,但其贪心策略可能导致子词边界不自然,影响语义连贯性。
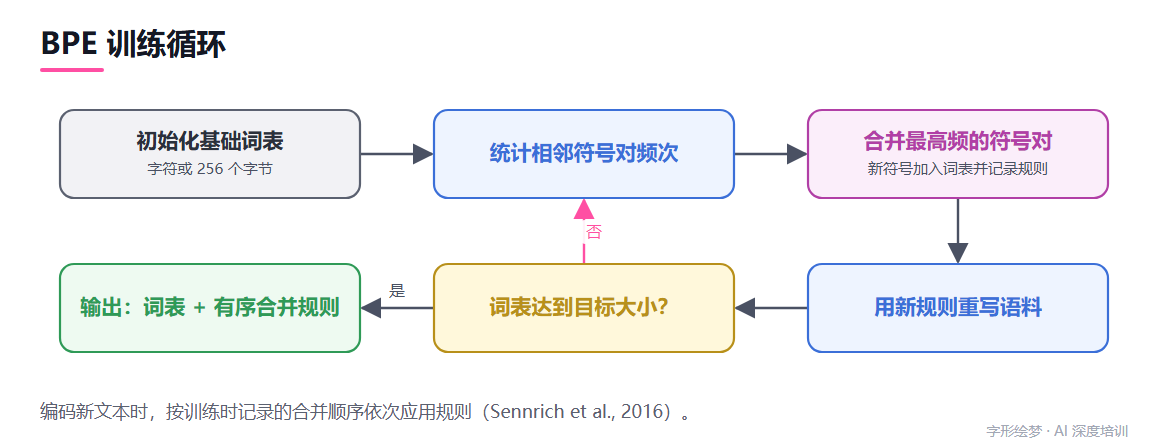
编码新文本时,按训练时记录的合并顺序依次应用规则(Sennrich et al., 2016)。
3. WordPiece 与 Unigram LM
WordPiece 与 BPE 的核心差异在于合并准则:BPE 追求高频符号对的统计频率,而 WordPiece 追求最大似然估计(MLE)。其直觉是:如果将两个相邻符号 A, B 合并为 AB,应当使得整个语料库的对数似然(Log-Likelihood)提升最大。 形式化定义如下:设词表为 V,语料库为 D。对于任意相邻符号对 (s_i, s_i+1),计算合并前后的似然增益 Δ:
Δ = log P(D | V ∪ s_i s_i+1) - log P(D | V)
在训练阶段,WordPiece 反复计算所有候选对的 Δ,选择 Δ 最大的一对进行合并,并将其加入词表。这一过程确保了合并操作在概率意义上是“最优”的,而非仅仅在频率上占优。BERT 即采用此策略构建词表(Devlin et al., 2018)。 Unigram LM 分词器则采取了完全不同的逆向思维。它不从单字符开始合并,而是从一个巨大的初始词表(通常包含所有可能的 n-gram 或基于 BPE 预合并的符号)出发,通过剪枝(Pruning)来缩小词表。其核心思想是:如果移除某个子词 w 后,整个语料库的对数似然损失(Loss)小于预设阈值 τ,则移除 w。
Loss(w) = log P(D | V) - log P(D | V \ w)
Unigram 分词器维护一个子词语言模型 P(w_1, ..., w_n) = ∏ P(w_i)。训练时,它不断评估移除每个子词带来的似然损失,并移除损失最小的子词,直到词表大小达到目标值。这种方法的优势在于它允许“非贪心”的决策,能够保留那些虽然频率不高但对似然贡献关键的子词,从而在相同词表大小下通常获得更优的压缩率。 然而,Unigram 分词器在推理时面临一个独特挑战:由于词表是剪枝得到的,同一个字符串可能有多种合法的子词切分方式。例如,"unhappy" 可能被切分为 ["un", "happy"] 或 ["unh", "app", "y"]。为了利用这种歧义性提升模型鲁棒性,Kudo (2018) 提出了子词正则化(Subword Regularization)。 在训练阶段,对于每个输入句子,不再使用唯一的分词结果,而是根据 Unigram LM 的概率分布 P(W|S) 采样 K 个不同的子词序列作为增强样本。这种数据增强迫使模型学习对分词方式的不确定性具有鲁棒性,显著提升了翻译等任务的效果。 在工程实现上,SentencePiece 库统一了 BPE 和 Unigram 的训练与推理接口,并直接在原始文本(含空格)上操作,避免了传统分词器对空格处理的歧义(Kudo & Richardson, 2018)。LLaMA 系列模型即采用 SentencePiece 的 BPE 模型,但其底层架构思想与 Unigram 的似然驱动理念一脉相承,均强调分词器应与语言模型目标对齐。
常见误区:认为 Unigram 分词器在推理时必须使用“最可能”的切分。实际上,在训练中使用采样分词(Subword Regularization)是关键;而在推理时,通常使用 Viterbi 算法或前向-后向算法计算最可能的切分,以平衡效率与准确性。
4. 字节级 BPE 与 SentencePiece
在标准 BPE 实现中,分词器通常依赖空格来界定单词边界。这带来两个工程痛点:一是空格本身不参与词表学习,导致“a”与“ a”(带前导空格)被视为不同 token,增加了词表冗余;二是对于无空格语言(如中文、日文)或代码文本,基于空格的预处理极易出错,且难以保证分词与还原(detokenization)的严格可逆性。 字节级 BPE(Byte-level BPE)与 SentencePiece 框架解决了这些问题。其核心思想是:将输入文本映射为字节序列,而非字符序列。由于 UTF-8 编码覆盖所有 Unicode 字符,任何文本均可无损转换为 0–255 的字节流。因此,基础词表固定为 256 个字节符号,天然不存在 OOV(Out-of-Vocabulary)问题——任何未登录词都会被分解为字节序列,而非被替换为 <unk>。 SentencePiece(Kudo & Richardson, 2018)进一步将空格视为普通符号处理。它引入特殊标记 ▁(U+2581)表示“词首”(即空格或行首),而非直接依赖空格字符。例如,文本 "hello world" 被预处理为 ▁hello▁world,其中 ▁ 是词表中的普通 token。这一设计带来两个优势:
- 语言无关性:无需针对特定语言定制空格规则,统一处理所有文本;
- 严格可逆性:分词(tokenize)与还原(detokenize)构成双射映射。还原时,
▁被替换为空格,其余 token 按顺序拼接,即可精确恢复原始文本。这避免了传统分词器中因空格处理不一致导致的“分词-还原”误差,对 RLHF 奖励建模、代码生成等对文本精确性敏感的任务至关重要。
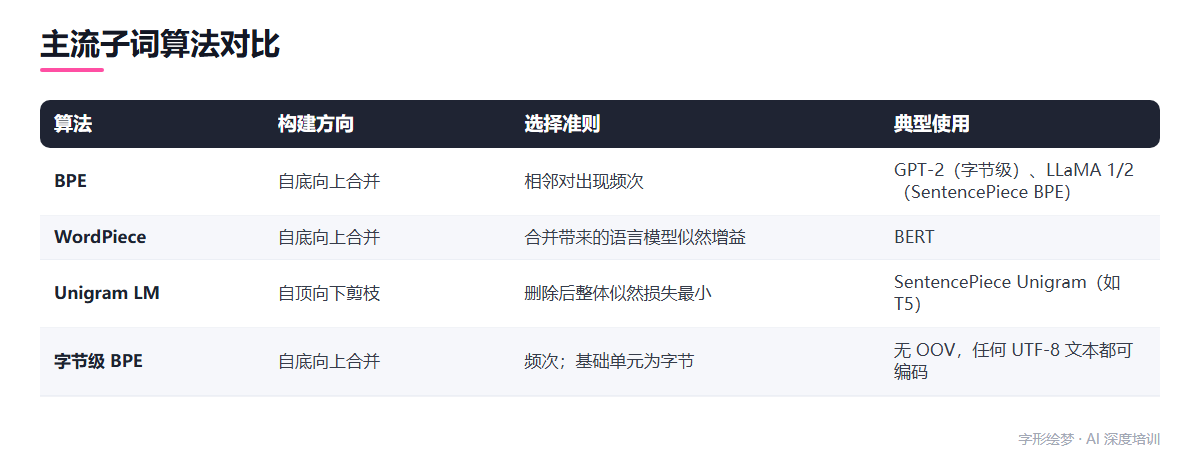
从算法角度看,SentencePiece 的 BPE 模式在字节序列上执行与字符级 BPE 相同的合并规则:统计相邻字节对频率,迭代合并最高频对,直至词表达到目标大小。由于基础词表已覆盖所有字节,合并过程仅生成多字节组合(如 ▁h、el、lo),无需处理 OOV。训练复杂度仍为 O(N log N),其中 N 为语料字节数。 LLaMA(第 1、2 代)采用 SentencePiece 的 BPE 模型,词表大小设为 32,000,其中包含 256 个字节符号及 ▁ 标记(Touvron et al., 2023)。这一选择验证了字节级分词在大规模预训练中的有效性:既保证了多语言文本的鲁棒性,又通过子词合并控制了序列长度。 如下图所示,主流子词算法在基础词表、OOV 处理、空格建模及可逆性上存在显著差异。字节级 BPE 与 SentencePiece 通过字节基础词表和 ▁ 标记,实现了语言无关、无 OOV、严格可逆的分词范式,成为当前大模型的主流选择。
5. 词表大小、嵌入矩阵与压缩率
在 Transformer 架构中,词表大小 V 对模型参数量和推理效率有着直接且深远的影响。最核心的参数开销体现在嵌入层(Embedding)和输出投影层(Output Head)。若模型隐藏层维度为 d,则嵌入矩阵的参数量为 V × d,输出层的参数量同样为 V × d(若未使用权重绑定)。
Params_embedding = V · d
Params_output = V · d
以 LLaMA 系列模型为例,其采用 SentencePiece 的 BPE 模型,词表大小通常设定在 32k 至 32k 左右(具体视版本而定,LLaMA-1/2 为 32000)。若 d=4096(以 LLaMA-7B 为例),仅嵌入和输出层就占据 2 × 32000 × 4096 ≈ 2.6 亿参数,约占 7B 总参数的 3.7%。虽然这一比例看似不高,但在超大词表(如某些多语言模型中 V 可达 250k+)场景下,这部分参数将膨胀至数十亿级别,显著增加显存占用和 I/O 带宽压力。 压缩率与语言特性 分词器的“压缩率”定义为:原始字符数 / 生成的 Token 数。高压缩率意味着更短的序列长度,从而降低注意力机制的计算复杂度(O(L^2))和 KV Cache 的内存占用。
- 中文:由于汉字本身是单字符语义单位,且 BPE 倾向于将高频汉字或双字词合并为 Token,中文的压缩率通常较高。例如,“深度学习”可能被编码为 2-3 个 Token,而对应字符数为 4。
- 代码:代码包含大量特殊符号、长标识符和重复模式。BPE 对代码的压缩效果往往优于自然语言,因为代码中的变量名、函数名往往具有前缀/后缀规律,容易被合并为长 Token。然而,代码中的空格和缩进若未被有效处理,可能会产生冗余 Token。SentencePiece 将空格视为普通符号(▁),这在一定程度上缓解了代码分词中的边界问题(Kudo & Richardson, 2018)。
对算术与拼写类任务的影响 分词粒度直接影响模型对细粒度结构的感知能力:
- 算术任务:若数字被拆分为多个 Token(如 "123" → "1", "2", "3"),模型需学习跨 Token 的位值关系,难度增加。若数字被合并为单一 Token(如 "123" → "123"),则模型可直接操作数值,但词表中需包含大量数字组合,导致
V增大。实践中,LLaMA 等模型通过 BPE 将常见数字片段合并,在压缩率与表示能力间取得平衡。 - 拼写错误鲁棒性:BPE 的子词特性使其对拼写错误具有一定鲁棒性。例如,"kitten" 被错误拼写为 "kiten",BPE 可能将其分解为 "ki", "te", "n",而正确拼写 "kitten" 分解为 "ki", "tten"。由于共享子词 "ki" 和 "n",模型仍能捕捉部分语义。相比之下,若词表仅包含完整单词,"kiten" 将直接成为 OOV(Out-of-Vocabulary),导致信息丢失。Unigram LM 通过子词正则化(Subword Regularization)进一步增强了这种鲁棒性,训练时随机采样不同分词路径,使模型对分词边界不敏感(Kudo, 2018)。
工程建议
- 词表大小:在资源受限场景下,优先选择 32k-50k 的词表,以平衡参数效率与覆盖度。
- 语言混合:若模型需处理多语言,需确保分词器在训练数据中覆盖目标语言,避免特定语言压缩率过低导致序列过长。
- 任务导向:若模型需频繁处理代码或数学公式,可考虑在预训练阶段增加此类数据,促使 BPE 合并更多符号组合,提升压缩率。
6. 小结与思考题
回顾全文,分词器的核心任务是在词表大小、序列长度与语义粒度之间寻找最优平衡。BPE 通过贪心合并高频相邻符号对构建词表,其编码过程严格遵循训练时的合并顺序,保证了确定性(Sennrich et al., 2016)。WordPiece 则基于似然增益最大化原则选择合并路径,而 Unigram LM 采用从大词表出发、按损失剪枝的策略,并引入了子词正则化以增强模型对输入扰动的鲁棒性(Kudo, 2018)。 在工程实现层面,SentencePiece 通过引入 256 字节的基础词表彻底解决了 OOV 问题,并将空格视为普通符号(如 ▁),实现了分词与反分词的可逆性,这使得它成为 LLaMA 等现代大模型的首选方案(Kudo & Richardson, 2018; Touvron et al., 2023)。相比之下,BERT 使用的 WordPiece 更侧重于特定语言(如英文)的子词组合优化(Devlin et al., 2018)。 选择分词器时,建议遵循以下检查清单:
- 语言覆盖:是否支持目标语言?中文、代码等高压缩率语言是否需要更大的词表或字节级回退机制?
- 序列长度:在相同上下文窗口下,该分词器产生的 token 数是否过多?这将直接影响推理成本与注意力机制的计算复杂度。
- 任务特性:若涉及拼写检查、数学公式或代码生成,细粒度分词(如字符级或字节级)通常优于粗粒度分词,以避免拼写错误导致的语义断裂。
- 可逆性:是否需要精确还原原始文本?SentencePiece 的可逆性在此场景下优于传统基于正则表达式的分词器。
思考题:
- 词表大小与嵌入参数的权衡:假设模型隐藏层维度
d=4096,词表大小V从 32,000 增加到 64,000。请估算嵌入层和输出层参数量的变化,并讨论这种增加对模型总参数占比及内存带宽的影响。 提示:嵌入层参数为V × d,输出层通常共享嵌入权重。考虑参数量占比随模型规模变化的趋势。 - 子词正则化的训练效率:Kudo (2018) 提出的子词正则化在训练时随机采样不同的子词划分。请分析这种策略如何影响梯度估计的方差,以及在大规模预训练中可能带来的计算开销。 提示:对比固定分词与随机分词在反向传播时的计算图差异,思考采样次数与收敛速度的关系。
- 字节级分词的语义碎片化:在代码生成任务中,字节级 BPE 将特殊符号(如
{,})拆分为多个 token。请讨论这种细粒度表示对注意力机制捕捉长距离依赖(如括号匹配)的挑战,并提出一种可能的架构改进方案。 提示:考虑注意力分数在短序列片段上的分布特性,以及位置编码对局部语义的影响。
参考文献
- Sennrich, Haddow, Birch, 2016. Neural Machine Translation of Rare Words with Subword Units. arXiv:1508.07909 arxiv.org/abs/1508.07909
- Kudo, 2018. Subword Regularization: Improving Neural Network Translation Models with Multiple Subword Candidates. arXiv:1804.10959 arxiv.org/abs/1804.10959
- Kudo & Richardson, 2018. SentencePiece: A simple and language independent subword tokenizer and detokenizer. arXiv:1808.06226 arxiv.org/abs/1808.06226
- Devlin et al., 2018. BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. arXiv:1810.04805 arxiv.org/abs/1810.04805
- Brown et al., 2020. Language Models are Few-Shot Learners. arXiv:2005.14165 arxiv.org/abs/2005.14165
- Touvron et al., 2023. LLaMA: Open and Efficient Foundation Language Models. arXiv:2302.13971 arxiv.org/abs/2302.13971
Paragoger衍生者AI训练营。发布者:稻草人,转载请注明出处:https://www.shxcj.com/archives/10361