本文属于《AI 深度培训》系列 · 难度:专家 · 篇幅:约 7000 字
预训练赋予大模型强大的语言生成能力,却难以直接对齐人类意图。本文深入剖析 RLHF、PPO、DPO 与 GRPO 等核心对齐技术,从 Bradley-Terry 偏好建模到 KL 约束优化,再到隐式奖励推导与组相对策略优化,系统梳理各方法的数学本质与工程权衡。旨在帮助读者理解从“会续写”到“会帮忙”的技术演进,为构建安全、可控且高性能的大模型提供坚实的理论依据与选型参考。
目录
1. 导读:从“会续写”到“会帮忙”
大语言模型(LLM)的预训练阶段主要基于自回归目标,即最大化下一个词元的似然概率。这一目标使模型具备了强大的世界知识表征与文本生成能力,但也导致其输出往往只是统计意义上的“合理续写”,而非符合人类意图的“有用回答”。预训练数据中混杂着大量低质量、有害或无关信息,且模型缺乏对“什么是好回答”的明确定义。因此,直接部署预训练模型(Base Model)通常无法满足用户对准确性、安全性及有用性的要求。 为弥合这一偏差,业界引入了HHH(Helpful, Harmless, Honest)目标,即要求模型的回答既有帮助、又无害、且诚实。这一目标无法通过简单的交叉熵损失直接优化,因为“帮助性”和“无害性”是主观的、多模态的偏好概念,而非单一的客观事实。解决这一问题的核心路径是对齐(Alignment),即通过引入人类反馈或结构化规则,将模型的输出分布向人类偏好分布拉近。 对齐技术不仅是提升模型实用性的关键,也是确保 AI 系统安全可控的基础。从早期的强化学习从人类反馈(RLHF)到近期的直接偏好优化(DPO)及组相对策略优化(GRPO),技术路线经历了从“复杂多阶段”到“简洁高效”的演进。理解这些方法的数学本质与工程权衡,是构建高性能大模型的核心能力。 本文路线:
- 三阶段 RLHF 流程:解析 SFT、奖励模型训练及 PPO 优化的标准范式。
- 奖励模型原理:深入 Bradley-Terry 偏好建模及其损失函数推导。
- PPO 与 KL 约束:探讨策略优化中的稳定性问题及奖励欺骗现象。
- DPO 机制:推导如何隐式消除奖励模型,实现离线偏好优化。
- GRPO 与 AI 反馈:介绍无价值网络的优势估计方法及 Constitutional AI 范式。
通过本文,读者将掌握从预训练到对齐的完整技术图谱,理解不同对齐算法在计算成本、训练稳定性及效果间的权衡,为实际工程选型提供理论依据。
2. 三阶段 RLHF 流程
在预训练阶段,大模型的核心目标是最小化下一词预测损失,这使得模型擅长捕捉语言分布中的统计规律,但往往缺乏对人类意图的精确理解。模型可能会生成语法正确但事实错误、有害或不符合指令要求的内容。为了弥合这一“会续写”与“会帮忙”之间的鸿沟,强化学习从人类反馈(RLHF)成为主流对齐技术。如下图所示,InstructGPT 确立了一套经典的三阶段流程,该范式被广泛采用并不断优化(Ouyang et al., 2022)。 第一阶段是监督微调(SFT)。在这一阶段,我们收集高质量的人类示范数据,通常包含指令(prompt)和理想的响应(completion)。这些示范数据展示了模型应该如何遵循指令、保持礼貌、提供有用且无害的回答。通过标准的交叉熵损失函数对预训练模型进行微调,模型学习模仿这些专家行为。SFT 的主要作用是让模型适应对话格式和基本的指令遵循能力,但它本质上仍是模仿学习,无法直接优化那些难以用规则明确定义的复杂偏好,如“更有帮助”或“更安全”。 第二阶段是训练奖励模型(Reward Model, RM)。由于人类的偏好通常是成对比较的(例如,回答 A 比回答 B 更好),我们采用 Bradley-Terry 模型来建模这种偏好。对于给定的提示 x 和两个响应 y_w(获胜)与 y_l(落败),奖励模型 r_φ(x, y) 预测的偏好概率为:
P(y_w ≻ y_l | x) = σ(r_φ(x, y_w) - r_φ(x, y_l))
其中 σ 是 Sigmoid 函数。训练目标是最小化负对数似然损失:
L(φ) = -E_(x, y_w, y_l) ~ D [log σ(r_φ(x, y_w) - r_φ(x, y_l))]
奖励模型将人类的主观偏好转化为标量奖励信号,为后续的强化学习提供可优化的目标函数。需要注意的是,奖励模型仅基于有限的偏好数据训练,可能存在过拟合或奖励欺骗(reward hacking)的风险,即策略模型找到奖励模型打分高但实际质量差的输出。 第三阶段是使用近端策略优化(PPO)算法优化策略模型。在此阶段,策略模型 π_θ 生成响应,奖励模型提供即时奖励,同时引入 KL 散度约束以防止策略偏离参考模型 π_ref 过远,从而保持语言流畅性和通用能力。优化目标为最大化期望奖励并最小化 KL 惩罚:
max_θ E_x~D, y~π_θ(·|x) [r_φ(x, y)] - β·KL(π_θ || π_ref)
PPO 通过裁剪比率(clipping ratio)来限制策略更新幅度,确保训练稳定性。该过程需要同时维护策略网络、价值网络(用于估计基线以减少方差)和奖励模型,计算开销较大。尽管如此,这种三阶段流程在 InstructGPT 中取得了显著成效:1.3B 参数的 InstructGPT 输出比 175B GPT-3 的输出更受标注者偏好(Ouyang et al., 2022),证明了 RLHF 在提升模型对齐度上的有效性。
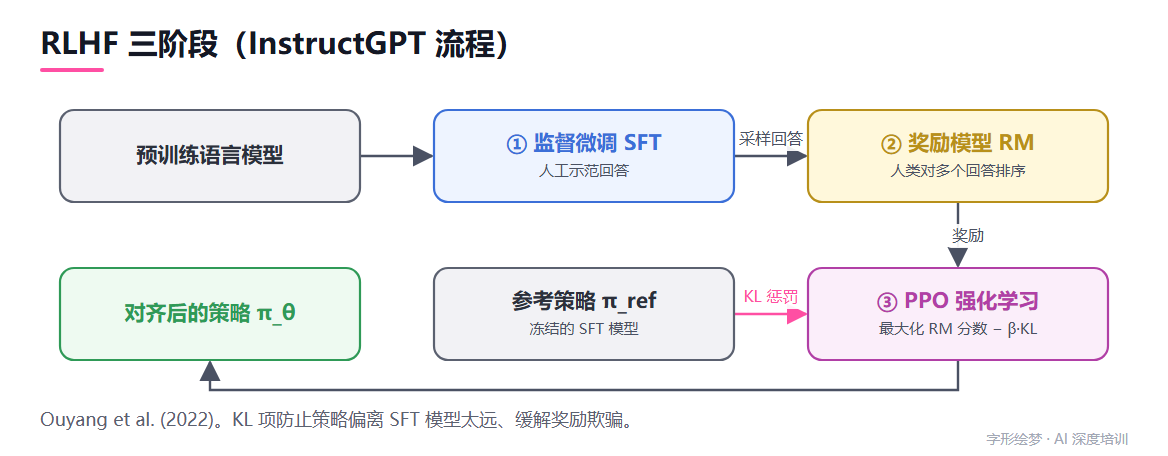
Ouyang et al. (2022)。KL 项防止策略偏离 SFT 模型太远、缓解奖励欺骗。
3. 奖励模型:Bradley-Terry 偏好建模
在 RLHF 体系中,奖励模型(Reward Model, RM)充当了人类偏好的量化代理。其核心任务是将离散的成对比较数据转化为连续的标量分数,以便后续策略优化。这一过程通常基于 Bradley-Terry (BT) 模型进行建模。
1. Bradley-Terry 偏好概率
假设对于给定的提示 x,存在两个候选回答 y_w(偏好)和 y_l(非偏好)。BT 模型假设每个回答有一个潜在的潜在效用分数,且偏好概率仅取决于两者分数的差值。形式化定义如下:
P(y_w succ y_l | x) = σ(r_φ(x, y_w) - r_φ(x, y_l))
其中:
r_φ是参数为φ的奖励模型,通常是一个在语言模型骨干上添加线性分类头得到的网络。σ(·)是 Sigmoid 函数σ(z) = 1 / (1 + e^-z)。r_φ(x, y)输出标量奖励值。
该公式的直觉是:如果 r_φ(x, y_w) 显著大于 r_φ(x, y_l),则 Sigmoid 输出趋近于 1,表示模型认为 y_w 优于 y_l 的置信度高;反之趋近于 0。这种参数化方式具有平移不变性,即同时给两个奖励加上常数 c 不会改变偏好概率,这符合人类比较判断的相对性特征。
2. 损失函数推导
给定数据集 D = \(x_i, y_w,i, y_l,i)\_i=1^N,我们采用最大似然估计(MLE)来训练奖励模型。目标是最大化观测到的偏好对的联合概率:
max_φ Σ_i=1^N log P(y_w,i succ y_l,i | x_i)
取负对数后,得到最小化损失函数:
L_RM(φ) = - Σ_i=1^N log σ(r_φ(x_i, y_w,i) - r_φ(x_i, y_l,i))
在工程实现中,这等价于对每一对数据计算二元交叉熵(BCE)损失。梯度方向清晰地指示了模型应如何调整参数:增加 r_φ(x, y_w) 或降低 r_φ(x, y_l),从而拉大两者的差距。
3. 校准与工程含义
校准问题(Calibration): BT 模型仅约束奖励的相对差值,而不约束其绝对值。这意味着奖励分数可能随训练过程发生漂移(例如整体均值上升)。虽然这对 PPO 等基于优势函数的算法影响较小(因为优势通常涉及基线或价值网络),但在 DPO 等直接优化方法中,奖励的尺度会直接影响隐式奖励的强度。此外,奖励分数的分布形态(如方差)会影响策略探索的稳定性。 常见误区:
- 奖励 hacking 的前兆:如果奖励模型在某些特定模式(如长度、特定词汇)上过度拟合,策略模型可能学会生成这些模式以获取高奖励,而非真正提升质量。
- 忽略不确定性:BT 模型假设偏好是确定的,但人类标注存在噪声。在实际应用中,可以考虑引入标签平滑或不确定性估计,以提高鲁棒性。
- 奖励模型与策略模型的耦合:奖励模型是在固定策略分布上训练的,而策略模型在不断变化。这种分布偏移可能导致奖励模型在新策略生成的文本上表现不佳,这是 RLHF 中“奖励模型失效”现象的根本原因之一。
注意:奖励模型的质量直接决定了 RLHF 的上限。一个校准良好、泛化能力强的 RM 是后续 PPO 或 DPO 成功的关键前提。
4. PPO 与 KL 约束
直觉与形式化定义
在强化学习微调(RLHF)中,核心矛盾在于:我们希望模型生成符合人类偏好的文本,但又必须防止模型为了最大化奖励而“过拟合”奖励模型,导致输出退化(如重复短语、乱码)或偏离预训练分布。 为了解决这一问题,我们不再单纯最大化期望奖励,而是引入一个正则化项,将策略 π_θ 锚定在参考策略 π_ref(通常是 SFT 后的模型)附近。目标函数定义为:
maximize E_x ~ D, y ~ π_θ(·|x) [ r(x, y) ] − β · KL( π_θ(·|x) || π_ref(·|x) )
其中 r(x, y) 是奖励模型给出的标量分数,β 是控制偏离程度的超参数。β 越大,模型越保守,越接近 SFT 模型;β 越小,模型越激进,越容易陷入奖励欺骗(Reward Hacking)。
PPO 算法机制
直接优化上述目标函数在计算上不可行,因此采用近端策略优化(PPO)算法(Schulman et al., 2017)。PPO 的核心思想是通过裁剪概率比率来限制策略更新的步长。 定义概率比率:
r_t(θ) = π_θ(a_t|s_t) / π_old(a_t|s_t)
PPO 的裁剪目标函数为:
L^CLIP(θ) = E_t [ min( r_t(θ) A_t, clip(r_t(θ), 1−ε, 1+ε) A_t ) ]
其中 A_t 是优势函数(Advantage),ε 是裁剪范围(通常设为 0.1 或 0.2)。该机制确保当新策略相对于旧策略的变化过大时,梯度会被截断,从而保证训练稳定性。 在语言模型中,状态 s_t 是前缀文本,动作 a_t 是下一个 token。由于序列长度可变且奖励仅在序列结束时给出,我们需要估计每个 token 的价值。这引入了价值网络(Value Network),通常是一个与策略网络共享底层的独立头,用于预测状态价值 V(s_t)。 为了降低优势估计的方差,广泛使用广义优势估计(GAE):
A_t = Σ_l=0^∞ (γ λ)^l δ_t+l
其中 δ_t = r_t + γ V(s_t+1) - V(s_t) 是 TD 误差,γ 是折扣因子,λ 是 GAE 参数(通常设为 0.95)。GAE 在偏差和方差之间取得了平衡,是 PPO 在 LLM 对齐中成功的关键组件之一(Ouyang et al., 2022)。
奖励欺骗与工程误区
尽管 PPO 结构复杂,但其主要风险在于奖励欺骗。奖励模型 r(x, y) 是基于有限的人类偏好数据训练的,其决策边界存在漏洞。策略模型 π_θ 可能会发现某些特定的 token 模式能持续获得高奖励,但这些模式在语义上毫无意义。 常见误区包括:
- 忽略 KL 散度的监控:如果 KL 散度急剧上升,说明策略正在远离参考分布,此时即使奖励分数很高,输出质量也往往极差。
- 价值网络训练不足:如果价值网络无法准确预测长期回报,优势估计
A_t将充满噪声,导致策略更新方向错误。 - 超参数
β设置不当:β过小会导致奖励欺骗,过大则导致模型无法有效学习新行为。通常需要根据 KL 散度动态调整或手动调优。
注意:PPO 需要同时维护策略网络、价值网络和奖励模型,计算开销大且超参数敏感。这也是后续 DPO 等直接偏好优化方法兴起的背景(Rafailov et al., 2023)。
5. DPO:把奖励模型“消掉”
从最优解到直接偏好优化
RLHF 的核心痛点在于需要显式训练奖励模型(RM),这引入了额外的计算开销、超参数调优以及奖励欺骗(Reward Hacking)的风险。DPO(Direct Preference Optimization)的关键洞察在于:我们不需要显式估计奖励函数,可以直接优化策略,因为最优策略与奖励函数之间存在一一对应的数学关系。
1. KL 约束问题的最优策略形式
回顾 RLHF 的目标函数。我们希望在最大化人类偏好的同时,防止策略 π_θ 偏离参考策略 π_ref 太远。形式化地,这可以写为:
max_π E_x ~ D, y ~ π(·|x) [r(x, y)] - β · KL(π(·|x) \| π_ref(·|x))
其中 r(x, y) 是奖励函数,β 是 KL 惩罚系数。这是一个凸优化问题,其解析解(Optimal Policy)具有封闭形式。通过变分法推导,最优策略 π^* 可以表示为:
π^*(y|x) = (1)/(Z(x)) π_ref(y|x) exp((1)/(β) r(x, y))
这里 Z(x) 是配分函数(Partition Function),用于归一化:
Z(x) = Σ_y π_ref(y|x) exp((1)/(β) r(x, y))
这个公式揭示了策略与奖励之间的指数关系。如果我们将公式变形,可以反解出奖励函数 r(x, y):
r(x, y) = β log fracπ^*(y|x)π_ref(y|x) + β log Z(x)
注意,β log Z(x) 仅依赖于输入 x,与输出 y 无关。在比较两个不同输出 y_w 和 y_l 时,这一项会被抵消。
2. 代入 Bradley-Terry 模型
人类偏好通常用 Bradley-Terry (BT) 模型建模。假设给定输入 x 和两个输出 y_w (win) 和 y_l (loss),偏好概率为:
P(y_w succ y_l | x) = σ(r(x, y_w) - r(x, y_l))
将上述反解出的 r(x, y) 表达式代入 BT 模型:
P(y_w succ y_l | x) = σ( β log fracπ^*(y_w|x)π_ref(y_w|x) - β log fracπ^*(y_l|x)π_ref(y_l|x) )
由于 β log Z(x) 在相减时消去,我们得到了一个仅包含策略 π^* 和参考策略 π_ref 的表达式。DPO 的核心假设是:如果我们将策略 π_θ 训练为最优策略 π^*,那么最大化这个偏好似然等价于最大化原始 RLHF 目标。 因此,DPO 的损失函数直接定义为负对数似然:
L_DPO(π_θ; π_ref) = -E_(x, y_w, y_l) ~ D [ log σ ( β log fracπ_θ(y_w|x)π_ref(y_w|x) - β log fracπ_θ(y_l|x)π_ref(y_l|x) ) ]
这一推导在 Rafailov et al., 2023 中得到了严格证明。它意味着我们完全跳过了奖励模型的训练步骤,直接利用偏好数据对语言模型进行微调。
3. 隐式奖励与工程含义
DPO 中的项 β log [π_θ(y|x) / π_ref(y|x)] 被称为隐式奖励(Implicit Reward)。
- 直觉:如果模型
π_θ比参考模型π_ref更倾向于生成y_w而不是y_l,则隐式奖励差值变大,损失函数减小。 - 稳定性:由于不需要价值网络(Critic)和复杂的 PPO 采样过程,DPO 的训练过程更接近标准的监督学习(SFT),收敛更快,超参数更少。
- 局限性:DPO 假设偏好数据是独立同分布的,且模型能够充分拟合最优策略。在某些复杂任务中,DPO 可能不如 PPO 灵活,因为 PPO 可以通过探索发现数据集中未覆盖的更好策略,而 DPO 受限于偏好数据的质量。
4. 伪代码实现
以下是 DPO 训练单步的核心逻辑:
def dpo_loss(policy_logits_w, policy_logits_l, ref_logits_w, ref_logits_l, beta):
    """
    计算 DPO 损失。
    假设输入是已经计算好的 logits,需要转换为 log-probabilities。
    """
    # 1. 计算 log-probabilities (假设 logits 已经过 softmax 前的处理,这里简化为 log_softmax)
    # 实际中通常计算序列级别的 log-prob: sum(log_softmax(logits)[y])
    log_pi_w = log_softmax(policy_logits_w) # 形状: [batch, seq_len]
    log_pi_l = log_softmax(policy_logits_l)
    log_ref_w = log_softmax(ref_logits_w)
    log_ref_l = log_softmax(ref_logits_l)
    # 2. 计算隐式奖励: beta * (log_pi - log_ref)
    # 注意:实际实现中,通常只对有效 token 求和,忽略 padding
    implicit_reward_w = beta * (log_pi_w - log_ref_w).sum(dim=-1)
    implicit_reward_l = beta * (log_pi_l - log_ref_l).sum(dim=-1)
    # 3. 计算 DPO 损失
    # L = -log sigma(implicit_reward_w - implicit_reward_l)
    logits = implicit_reward_w - implicit_reward_l
    loss = -F.logsigmoid(logits).mean()
return loss常见误区:不要将 DPO 视为 SFT 的简单替代。DPO 对参考模型
π_ref的选择非常敏感。如果π_ref质量太差,隐式奖励的基线不稳定,训练容易发散。通常建议π_ref使用经过 SFT 的模型。
思考题
- 为什么 DPO 损失函数中不需要计算配分函数
Z(x)?这在计算上带来了什么优势? - 如果偏好数据中存在噪声(即标注者对
y_w和y_l的偏好不一致),DPO 和 PPO 哪种方法更鲁棒?为什么?
6. GRPO 与 AI 反馈
在 PPO 中,价值网络(Critic)用于估计状态价值以计算优势函数(Advantage),但这引入了额外的参数和训练不稳定性。DeepSeekMath 提出的 GRPO(Group Relative Policy Optimization)针对这一问题进行了简化:它不再引入独立的价值网络,而是利用同一提示词(prompt)下的一组采样输出(Group)来进行相对优势估计(Shao et al., 2024)。
组内采样与相对优势
GRPO 的核心思想是:对于同一个输入 x,策略 π_θ 采样一组输出 \y_1, y_2, ..., y_G\。假设奖励模型给出对应的奖励 \r_1, r_2, ..., r_G\,GRPO 直接在组内计算归一化的优势值:
A_i = (r_i - mean(r_1, ..., r_G)) / std(r_1, ..., r_G)
这种“组内归一化”替代了 PPO 中基于价值函数 V(s) 的 GAE 计算。其直觉在于:我们不需要知道绝对的好坏,只需要知道在当前这一组候选中,哪个更好。由于去除了价值网络,GRPO 显著降低了显存占用和训练开销,特别适用于数学推理等可验证奖励(Verifiable Rewards)的场景,因为这类任务往往不需要复杂的奖励模型,只需判断答案是否正确即可(Shao et al., 2024)。
Constitutional AI 与 RLAIF
传统 RLHF 依赖昂贵的人类反馈来构建奖励模型。Bai et al. (2022) 提出的 Constitutional AI(CAI)展示了如何利用 AI 自身反馈来替代部分人类劳动。CAI 的核心流程分为两步:
- 批评与修正(Critique & Revision):模型根据一组明确的“宪法原则”(如“不要生成有害内容”、“保持诚实”)对自己的输出进行自我批评,并生成修正后的版本。
- 偏好训练:将原始输出与修正后的输出配对,训练奖励模型或直接进行偏好优化。
这种方法被称为 RLAIF(Reinforcement Learning from AI Feedback)。RLAIF 的优势在于:
- 可扩展性:AI 反馈可以大规模、低成本地生成,突破了人类标注的瓶颈。
- 一致性:宪法原则提供了明确、可解释的对齐目标,减少了人类标注中的噪声和主观性。
如下图所示,RLHF-PPO、DPO 与 GRPO 在奖励来源、价值网络依赖及计算效率上存在显著差异。GRPO 通过组内相对优势消除了价值网络,而 RLAIF 则通过 AI 反馈降低了奖励信号获取的成本,两者共同推动了大模型对齐技术向更高效、更自动化的方向发展。
工程提示:在使用 GRPO 时,需注意组的大小
G对优势估计方差的影响。G过小可能导致优势估计噪声大,G过大则增加采样成本。通常G在 4-16 之间是常见的选择范围(示例值,需根据具体任务调整)。
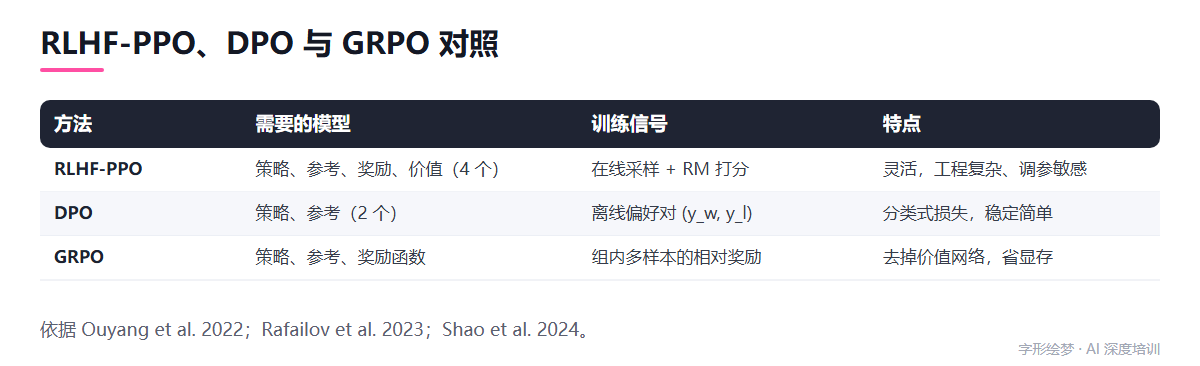
依据 Ouyang et al. 2022;Rafailov et al. 2023;Shao et al. 2024。
7. 小结与思考题
方法选择对照
在工程实践中,RLHF、DPO 与 GRPO 并非简单的线性演进关系,而是针对不同约束条件下的权衡选择。 RLHF (PPO) 是最经典的范式。其核心优势在于能够利用在线生成的数据,通过强化学习不断探索策略边界。然而,其工程复杂度极高:需要同时维护策略网络、价值网络、奖励模型和参考模型四个组件,且 PPO 超参数(如 GAE lambda、clip ratio)对训练稳定性影响巨大。此外,奖励模型可能产生“奖励欺骗”(Reward Hacking),即策略模型找到奖励模型的漏洞而非真正优化人类偏好(Ouyang et al., 2022)。 DPO 通过数学推导将奖励模型“内化”到策略模型中,消除了显式的 RL 循环。其核心损失函数为:
L_DPO = -E_(x, y_w, y_l) ~ D [ log σ( β · log(π_θ(y_w|x) / π_ref(y_w|x)) - β · log(π_θ(y_l|x) / π_ref(y_l|x)) ) ]
DPO 的优势在于训练稳定、无需价值网络、计算开销显著降低(Rafailov et al., 2023)。但其局限在于依赖离线偏好数据,若数据分布覆盖不足,模型难以泛化到未见过的场景,且对数据质量极度敏感。 GRPO 则针对数学推理等可验证任务进行了优化。它通过组内采样(Group Sampling)利用同一问题的多个输出进行相对优势估计,从而避免了训练价值网络的高昂成本(Shao et al., 2024)。GRPO 结合了 RL 的在线探索能力与 DPO 的低复杂度,特别适用于奖励信号明确(如代码执行结果、数学答案正确性)的场景。
| 特性 | RLHF (PPO) | DPO | GRPO |
|---|---|---|---|
| 核心机制 | 在线 RL + 奖励模型 | 离线偏好优化 | 在线 RL + 组内归一化 |
| 价值网络 | 需要 | 不需要 | 不需要 |
| 数据需求 | 在线生成 + 离线偏好 | 离线偏好 | 在线生成 + 可验证奖励 |
| 工程复杂度 | 高 | 低 | 中 |
| 适用场景 | 通用对话、复杂指令遵循 | 数据充足、追求效率 | 数学、代码等可验证任务 |
思考题
- 奖励模型的局限性:在 RLHF 中,奖励模型是基于有限的人类偏好数据训练的。如果策略模型生成的回答超出了奖励模型的“认知范围”(即分布外样本),奖励信号可能会误导策略优化。请结合 KL 约束项
β · KL(π \| π_ref)的作用,分析为什么 KL 约束能部分缓解这一问题,以及当β取值过大或过小时分别会导致什么后果? > 提示:思考 KL 散度作为正则化项如何限制策略偏离参考模型,以及这对探索-利用平衡的影响。 - DPO 的隐式奖励:DPO 论文指出,语言模型本身可以被视为一个奖励模型。请推导并解释:为什么在 DPO 的最优解下,隐式奖励
r(x, y) = β log fracπ_θ(y|x)π_ref(y|x)能够等价地还原出 Bradley-Terry 模型中的偏好概率?这一等价性对理解 DPO 与 RLHF 的关系有何启示? > 提示:回顾 KL 约束优化问题的拉格朗日对偶形式,以及最优策略与奖励函数之间的解析关系。 - GRPO 的组内归一化:GRPO 使用组内奖励的均值和标准差来归一化优势函数。假设在一个数学推理任务中,模型对某个问题生成了 8 个样本,其中 7 个错误,1 个正确。请分析这种极端情况下的优势估计值,并讨论这种归一化方式相比传统 PPO 的价值网络估计,在方差控制和偏差方面各有什么优缺点? > 提示:计算该极端情况下的标准化优势值,思考组内相对排名与绝对奖励值在梯度信号上的差异。
参考文献
- Christiano et al., 2017. Deep Reinforcement Learning from Human Preferences. arXiv:1706.03741 arxiv.org/abs/1706.03741
- Ziegler et al., 2019. Fine-Tuning Language Models from Human Preferences. arXiv:1909.08593 arxiv.org/abs/1909.08593
- Stiennon et al., 2020. Learning to Summarize from Human Feedback. arXiv:2009.01325 arxiv.org/abs/2009.01325
- Ouyang et al., 2022. Training Language Models to Follow Instructions with Human Feedback. arXiv:2203.02155 arxiv.org/abs/2203.02155
- Schulman et al., 2017. Proximal Policy Optimization Algorithms. arXiv:1707.06347 arxiv.org/abs/1707.06347
- Rafailov et al., 2023. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. arXiv:2305.18290 arxiv.org/abs/2305.18290
- Shao et al., 2024. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv:2402.03300 arxiv.org/abs/2402.03300
- Bai et al., 2022. Constitutional AI: Harmlessness from AI Feedback. arXiv:2212.08073 arxiv.org/abs/2212.08073
Paragoger衍生者AI训练营。发布者:稻草人,转载请注明出处:https://www.shxcj.com/archives/10374