本文属于《AI 深度培训》系列 · 难度:专家 · 篇幅:约 7000 字
全参微调虽适应性强,但显存与存储成本高昂,难以满足多任务部署需求。本文深入解析参数高效微调(PEFT)原理,从低秩假设切入,详解 LoRA 的结构、初始化及推理合并机制,并进阶探讨 QLoRA 在 4-bit 量化底座上的显存优化策略。通过横向对比 Adapter 等主流方法,提供从理论到工程落地的完整知识链,助你根据显存预算与业务场景,灵活选择最优微调方案,实现低成本、高灵活性的模型适配。
目录
1. 导读:为什么不做全参微调
在大模型时代,“全参微调”(Full-Parameter Fine-Tuning)虽然能提供最充分的适应能力,但其高昂的工程成本往往使其成为不可持续的选择。对于拥有数十亿乃至数千亿参数的基础模型,全参微调不仅意味着巨大的显存占用,还带来了沉重的存储与部署负担。 首先,显存成本是全参微调最大的瓶颈。在反向传播过程中,除了需要存储模型参数本身,还必须保存梯度(Gradients)和优化器状态(Optimizer States,如 Adam 的一阶和二阶矩)。以 32-bit 精度为例,每个参数在训练时至少需要 12 字节的显存(4 字节参数 + 4 字节梯度 + 4 字节优化器状态)。这意味着微调一个 7B 参数的模型,仅优化器状态就需要约 84GB 显存,加上激活值(Activations)的开销,单卡甚至多卡集群都难以承受。相比之下,参数高效微调(PEFT)方法仅更新少量参数,大幅降低了这一开销。例如,LoRA 论文报告,与 GPT-3 175B 全参微调相比,可训练参数减少约 10000 倍、GPU 显存需求减少约 3 倍(Hu et al., 2021)。 其次,存储与多任务部署是另一个关键痛点。如果每个下游任务都需要保存一份完整的全参微调模型,存储成本将呈线性爆炸增长。例如,微调 100 个不同领域的模型,若每个模型 14GB,总存储需求高达 1.4TB。而在实际业务中,我们往往需要在一个基础模型上支持多种任务(如客服、代码生成、医疗问答)。全参微调要求为每个任务加载不同的完整权重,导致推理时切换任务需要频繁加载/卸载模型,延迟极高且显存利用率低。 参数高效微调的核心思想是:冻结基础模型的大部分参数,仅训练少量附加参数。这样,每个任务只需保存几 MB 到几百 MB 的“适配器”权重,即可通过热加载实现毫秒级的任务切换,极大提升了多任务部署的灵活性与经济性。 本文路线:
- 低秩假设:解释为什么微调更新量可以用低秩矩阵近似,以及内在维度的含义。
- LoRA 原理:深入解析 LoRA 的结构、初始化策略及推理时的合并机制。
- QLoRA 进阶:介绍如何在 4-bit 量化底座上进一步降低显存需求。
- 方法对比:横向比较 Adapter、Prefix-Tuning 等主流 PEFT 方法。
- 工程实践:提供调参清单与常见误区分析。
通过本文,你将掌握从理论假设到工程落地的完整知识链,能够根据显存预算和业务场景选择合适的 PEFT 策略。
2. 低秩假设与内在维度
在深入 LoRA 的数学结构之前,必须回答一个核心问题:为什么我们敢用两个低秩矩阵 A 和 B 来近似全参数更新 Δ W?这并非拍脑袋的工程技巧,而是基于对语言模型微调过程本质的观察:微调更新的有效秩(Effective Rank)往往远低于权重矩阵的维度。
1. 直觉:微调是“微调”而非“重构”
预训练模型 W_0 已经在一个巨大的参数空间中找到了一个能够捕捉通用语言结构的“吸引子”。当我们针对特定下游任务(如情感分析、代码生成)进行微调时,模型并不需要重写整个知识体系,而是需要在原有分布附近进行微小的“形变”。 如果 Δ W = W_fine-tuned - W_0 是一个满秩矩阵,意味着微调过程改变了模型在高维空间中的所有方向,这通常对应于灾难性遗忘或过拟合。然而,经验证据表明,Δ W 的能量主要集中在少数几个主成分上。换句话说,微调更新 Δ W 是一个“低秩”结构。
2. 内在维度(Intrinsic Dimensionality)
Aghajanyan et al. (2020) 在《Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning》中提出了“内在维度”的概念。他们指出,虽然 BERT 等模型的参数空间维度极高(例如 110M 参数对应 110M 维),但决定模型性能的关键变化只发生在一个低维子空间中。 该研究通过计算微调过程中权重更新向量的协方差矩阵特征值,发现大部分特征值迅速衰减至零。这意味着,微调轨迹被限制在一个低维流形上。这一发现为低秩适应提供了理论支撑:既然更新本身是低秩的,那么用低秩矩阵参数化更新过程就是自然且高效的。
3. 形式化视角:SVD 与截断
假设全参数微调得到的更新矩阵为 Δ W ∈ ℝ^d × k。根据奇异值分解(SVD),我们可以将其分解为:
ΔW = U Σ Vᵀ
其中 U ∈ ℝ^d × d,V ∈ ℝ^k × k,Σ 是对角矩阵,包含奇异值 σ_1 ≥ σ_2 ≥ dots ≥ σ_m(m = min(d, k))。 如果 Δ W 是低秩的,意味着存在一个整数 r ll m,使得前 r 个奇异值占据了总能量(Frobenius 范数平方)的绝大部分:
fracΣ_i=1^r σ_i^2Σ_i=1^m σ_i^2 ≈ 1
此时,我们可以用截断 SVD 近似 Δ W:
Δ W ≈ U_r Σ_r V_rᵀ
令 A = Σ_r V_rᵀ(形状 r × k),B = U_r(形状 d × r),则 Δ W ≈ BA。这正是 LoRA 的核心假设:微调更新 Δ W 可以被分解为两个低秩矩阵的乘积。
4. 工程含义与误区
- 误区一:所有任务都低秩? 虽然大多数语言任务表现出低秩特性,但某些任务(如需要记忆大量特定事实或极小数据集上的过拟合)可能导致更新秩升高。因此,
r的选择需要根据任务复杂度调整,而非固定不变。 - 误区二:低秩意味着性能损失? 在大多数 NLP 任务中,低秩适应的性能与全参微调相当,甚至更优(因为正则化效应)。但在某些视觉或语音任务中,低秩假设可能不成立,需结合具体领域验证。
- 实践建议: 在应用 LoRA 时,建议从较小的
r(如 4 或 8)开始,逐步增加,观察验证集损失曲线。如果损失在r增加后不再显著下降,说明当前任务的内在维度较低,无需更大的秩。
通过理解低秩假设,我们不仅解释了 LoRA 的有效性,也为后续选择 rank、初始化策略以及与其他 PEFT 方法(如 Adapter)的比较奠定了理论基础。
3. LoRA:结构、初始化与缩放
LoRA(Low-Rank Adaptation)的核心思想是:不直接更新预训练权重矩阵 W_0,而是将其冻结,并在旁路中引入两个低秩矩阵 A 和 B 来学习权重更新量 Δ W。如下图所示,前向传播时,输入向量 x 同时经过冻结的主路径和低秩旁路,输出为两者之和:
h = W_0 x + (α/r) · B A x
其中,W_0 ∈ ℝ^d × k 是冻结的原始权重,A ∈ ℝ^r × k 和 B ∈ ℝ^d × r 是可训练的低秩矩阵,r ll min(d, k) 是秩,α 是缩放因子。 初始化策略是确保训练稳定性的关键。根据 LoRA 论文(Hu et al., 2021),A 采用随机高斯分布初始化,而 B 初始化为全零矩阵。这一设计使得在训练开始的第一步,低秩旁路的输出严格为零:
Δ W = B A = 0 implies h_init = W_0 x
这意味着 LoRA 模块在初始状态下完全不影响预训练模型的输出,避免了因随机初始化引入的噪声干扰,使优化过程从“零更新”状态平滑启动。 缩放因子 α/r 的作用在于解耦秩 r 的选择与梯度量级。若仅使用 BA,当 r 增大时,B 和 A 的参数量增加,初始梯度范值可能随 r 波动。通过引入 α/r,可以保持不同秩配置下梯度的相对稳定性,使得超参数 α 和 r 可以独立调节。通常 α 设为 r 的 2 倍或 4 倍,以平衡更新幅度与稳定性。 推理时的合并是 LoRA 工程优势的核心。由于 Δ W = (α/r)BA 是一个固定的低秩矩阵,可以在部署前将其与 W_0 合并:
W_merged = W_0 + (α/r) B A
合并后的权重矩阵形状与原模型完全一致,前向计算图未发生任何改变,因此推理延迟与原始模型完全相同,没有额外的计算开销。这使得 LoRA 在保持高效微调的同时,完美兼容现有的推理优化技术(如 KV Cache、FlashAttention 等)。 以下是 LoRA 前向传播的简化伪代码实现:
import torch.nn as nn
class LoRALinear(nn.Module):
    def __init__(self, in_features, out_features, r=8, alpha=16.0):
        super().__init__()
        # 冻结的原始权重
        self.W0 = nn.Parameter(torch.empty(out_features, in_features), requires_grad=False)
        # 低秩旁路:A 随机初始化,B 初始化为 0
        self.A = nn.Parameter(torch.randn(r, in_features) * 0.01)
        self.B = nn.Parameter(torch.zeros(out_features, r))
        self.scaling = alpha / r
    def forward(self, x):
        # x: [batch, seq_len, in_features]
        # W0x: [batch, seq_len, out_features]
        out = torch.matmul(x, self.W0.T)
        # BAx: [batch, seq_len, out_features]
        # 注意:先乘 A,再乘 B,最后缩放
        delta = torch.matmul(torch.matmul(x, self.A.T), self.B.T) * self.scaling
return out + delta常见误区提示:
- 不要将
A和B初始化为相同的随机值:必须保证B=0,否则初始输出不为零,会破坏预训练分布。 α不是越大越好:过大的α会导致更新量过大,可能破坏预训练知识,引发灾难性遗忘。- 合并后无法热更新:一旦合并权重,若需切换不同任务,必须重新加载未合并的 LoRA 权重或重新合并,因此多任务部署时建议保留未合并状态或使用动态加载机制。
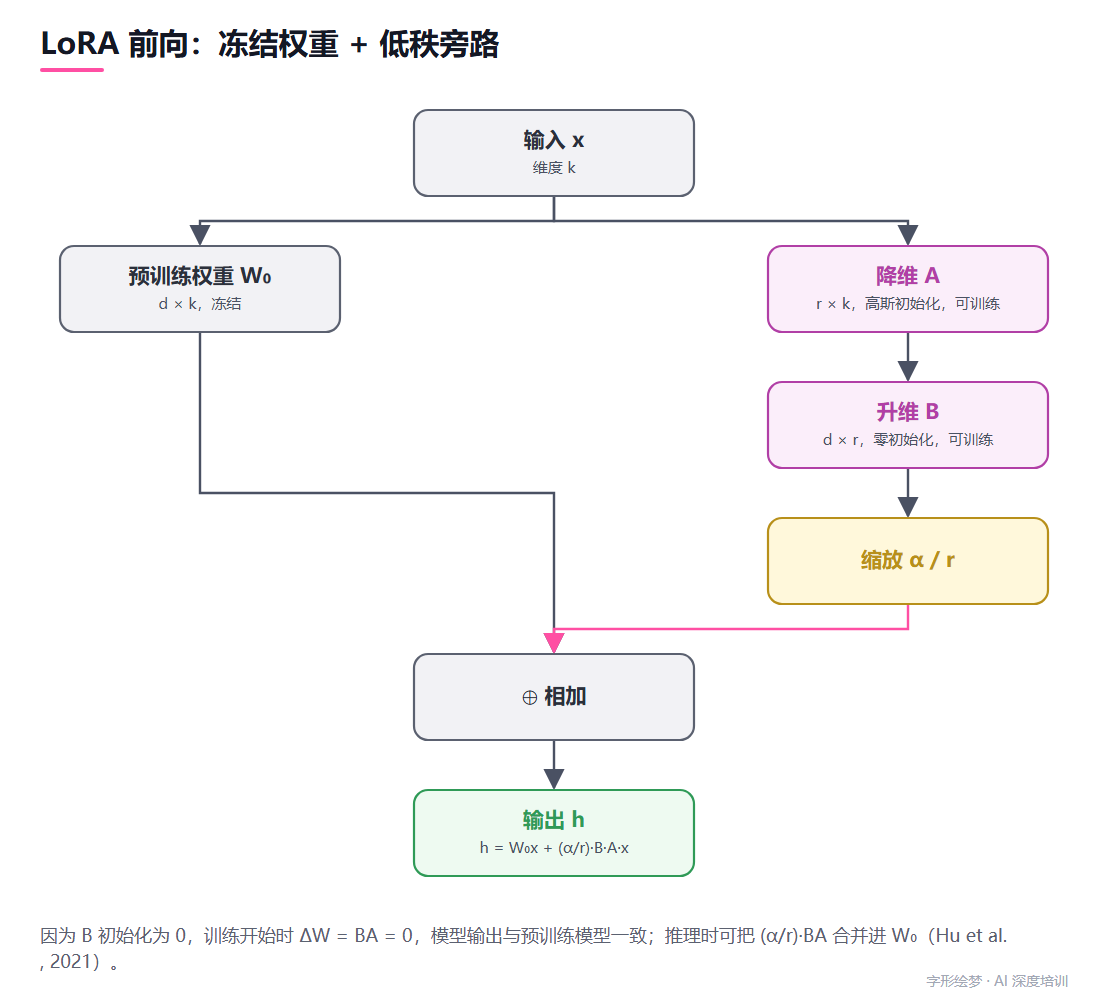
因为 B 初始化为 0,训练开始时 ΔW = BA = 0,模型输出与预训练模型一致;推理时可把 (α/r)·BA 合并进 W₀(Hu et al., 2021)。
4. 可训练参数量与 rank 选择
在确定 LoRA 的秩 r 之前,必须先量化“节省了多少参数”。LoRA 将原本 d × k 的权重矩阵 W 替换为两个低秩矩阵 A ∈ ℝ^d × r 和 B ∈ ℝ^r × k 的乘积,因此每个被适配的线性层新增的可训练参数量为 r(d+k)。相比之下,全参微调需要优化 d × k 个参数。以 LLaMA-7B 中常见的 4096 × 4096 注意力投影矩阵为例,全参微调需更新约 1677 万个参数;若取 r=8,则仅需 8 × (4096+4096) = 65536 个参数,压缩比约为 256 倍。如下图所示,随着 r 从 1 增至 64,可训练参数量呈线性增长,但始终远低于全参规模。
r=1   :  8,192  params  (0.05% of full)
r=8   : 65,536  params  (0.39% of full)
r=16  : 131,072 params  (0.78% of full)
r=32  : 262,144 params  (1.56% of full)
r=64  : 524,288 params  (3.13% of full)
Full  : 16,777,216 params
参数量节省直接转化为显存收益:优化器状态(Adam 的 m、v 向量)与梯度仅需为 A、B 分配,底座权重 W_0 保持冻结。Hu et al. (2021) 报告,与 GPT-3 175B 全参微调相比,LoRA 使可训练参数减少约 10000 倍、GPU 显存需求减少约 3 倍。 关于秩的选择,存在一个常见误区:r 越大越好。事实上,Aghajanyan et al. (2020) 指出语言模型微调的有效内在维度远低于参数总量,即 Δ W 的有效秩很低。Hu et al. (2021) 的实验也表明,r=8 或 r=16 在多数下游任务上已接近全参微调效果,继续增大 r 收益递减且可能过拟合。工程上建议从 r=8 起步,若验证集损失未收敛再逐步尝试 r=16、r=32,避免盲目使用 r=64 以上的高秩配置。 另一个关键决策是适配位置。LoRA 可作用于注意力层的 W_Q、W_K、W_V、W_O,也可扩展至 FFN 的 W_gate、W_up、W_down。Hu et al. (2021) 发现,仅适配注意力投影(W_Q 和 W_V)即可取得与适配全部线性层相当的性能,且参数量更少。Dettmers et al. (2023) 在 QLoRA 中进一步验证,将 LoRA 应用于所有线性层(包括 FFN)在 4-bit 底座上能带来额外 1–2 个点的困惑度改善,但参数量相应增加。因此,若显存极度受限,优先适配 W_Q、W_V;若追求极致性能且显存允许,可扩展至全部线性层。
调参清单 –
r:从 8 开始,按 8→16→32 递增,监控验证集损失 –α:通常取2r或4r,保持α/r缩放因子在 2–4 区间 – 适配位置:先试W_Q、W_V,再扩展至W_K、W_O及 FFN – dropout:0.0–0.1,数据量小时可略高
思考题:若将 LoRA 应用于一个 8192 × 8192 的 FFN 矩阵,r=16 时新增参数量是多少?与 r=8 相比,参数量增加了多少百分比?在什么任务场景下,这种增加可能不值得其带来的性能收益?
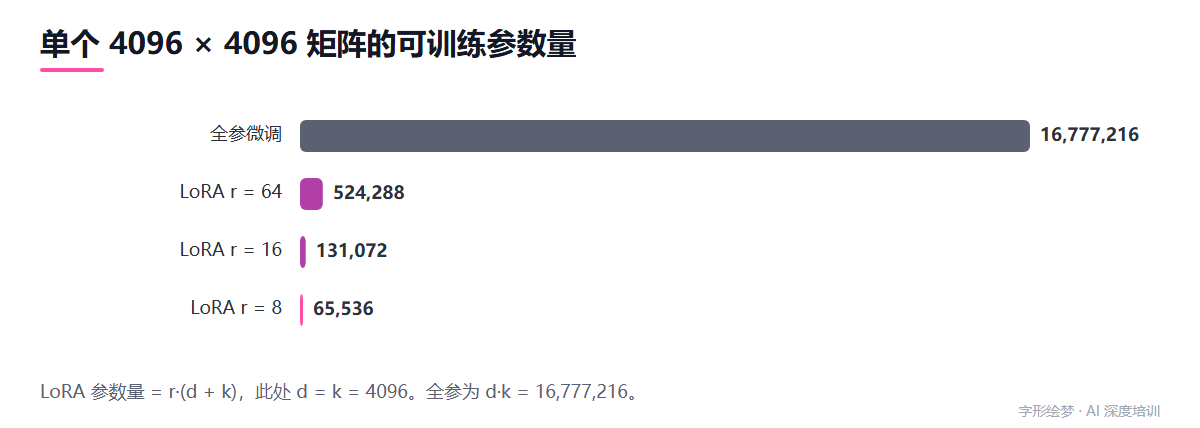
LoRA 参数量 = r·(d + k),此处 d = k = 4096。全参为 d·k = 16,777,216。
5. QLoRA:4-bit 底座上的 LoRA
在标准 LoRA 中,虽然低秩矩阵 A 和 B 的参数量极少,但预训练权重 W_0 仍以高精度(通常为 FP16 或 BF16)驻留在显存中。对于拥有数十亿甚至数百亿参数的大模型,仅存储 W_0 就占据了绝大部分显存,限制了可微调模型的规模。QLoRA 的核心思想是:将冻结的底座权重 W_0 量化至 4-bit,而将 LoRA 适配器 A, B 保持为高精度(FP16/BF16)。这样,底座权重占用显存减少约 4 倍,使得在单张消费级 GPU 上微调 65B 参数模型成为可能(Dettmers et al., 2023)。
1. NF4 数据类型
普通的 4-bit 量化通常采用均匀量化(Uniform Quantization),即假设数据在 [-1, 1] 区间内均匀分布。然而,大模型权重近似服从均值为 0 的高斯分布。若使用均匀量化,会导致权重分布两端的精度损失过大,而中间区域精度过剩。 QLoRA 提出了一种信息论最优的数据类型:NormalFloat (NF4)。NF4 是一个 4-bit 的对称数据类型,其量化码本(Codebook)基于标准正态分布 N(0, 1) 设计。具体而言,NF4 的 16 个离散值是通过最小化正态分布下的量化误差得到的。
# NF4 量化码本示例(简化示意,实际值由正态分布分位数确定)
# 假设数据 x ~ N(0, 1)
# NF4 的 16 个级别大致对应正态分布的累积概率分位数
nf4_codebook = [
    -1.0, -0.6962, -0.5251, -0.3949, -0.2844, -0.1849, -0.0910, 0.0,
    0.0910, 0.1849, 0.2844, 0.3949, 0.5251, 0.6962, 1.0, 1.5, 2.0, 3.0
]
# 注意:实际实现中,NF4 是动态计算的,确保覆盖 [-1, 1] 且符合正态分布特性
# 量化过程:x_q = codebook[argmin |x - codebook|]
# 反量化:x_deq = codebook[x_q]
通过 NF4,QLoRA 在 4-bit 精度下实现了比均匀量化更低的量化误差,从而在微调过程中保持了更高的精度。
2. 双重量化(Double Quantization)
在量化过程中,每个权重块(Block)都需要存储一个缩放因子(Scale Factor)和零点(Zero Point),以便将 4-bit 整数映射回浮点数。这些缩放因子本身通常以 FP16 存储。对于大模型,缩放因子的存储开销不可忽略。 例如,若每 64 个权重共享一个 FP16 缩放因子,则每个权重的额外开销为 16/64 = 0.25 bit。虽然看似微小,但在 100B 参数模型中,这部分开销可达数 GB。 双重量化旨在进一步压缩这些缩放因子。其核心思想是:将缩放因子本身也进行量化。具体步骤如下:
- 将权重分块,每块计算一个 FP16 缩放因子
s。 - 将所有缩放因子
s再次分块,每块计算一个更粗粒度的 FP8 缩放因子s'。 - 存储
s'和s相对于s'的偏移量(Offset)。
这样,原本需要 FP16 存储的缩放因子,现在只需 FP8 存储 s' 和 4-bit 的偏移量,显著降低了元数据的显存占用。
3. 分页优化器(Paged Optimizer)
在微调过程中,优化器状态(如 AdamW 的动量和方差)通常与可训练参数同精度存储。对于 LoRA,可训练参数是 A 和 B,其数量远少于底座权重。然而,在反向传播和梯度计算过程中,显存峰值往往出现在激活值(Activations)和中间张量的存储上。 QLoRA 引入分页优化器,借鉴了操作系统的虚拟内存分页机制。其核心思想是:
- 将优化器状态和梯度分块(Chunk)存储。
- 当 GPU 显存不足时,将部分不活跃的优化器状态或梯度交换(Swap)到 CPU 内存或 NVMe 存储中。
- 在需要时再将其加载回 GPU。
这种机制允许在 GPU 显存紧张时,动态管理显存分配,避免因显存溢出(OOM)而中断训练。它特别适用于显存有限但需要微调大模型的场景。
工程含义与常见误区
- 精度损失:虽然 QLoRA 在 4-bit 底座上表现优异,但相比 FP16 LoRA,其在某些复杂任务上可能存在轻微的性能下降。NF4 和双重量化已大幅缓解此问题,但在对精度极度敏感的场景中,仍需仔细评估。
- 训练速度:量化/反量化操作会引入额外的计算开销。然而,由于 LoRA 的可训练参数极少,整体训练速度主要受限于底座前向/反向传播,而底座在 4-bit 下的计算效率通常高于 FP16(取决于硬件支持),因此 QLoRA 的训练速度往往与 FP16 LoRA 相当甚至更快。
- 硬件依赖:QLoRA 的高效性依赖于硬件对低精度运算的支持。在支持 INT4/FP4 加速的 GPU(如 NVIDIA A100/H100)上,QLoRA 的性能优势更为明显。
注意:QLoRA 并非简单地“用 4-bit 训练”,而是“用 4-bit 存储底座,用高精度训练适配器”。这种混合精度策略是其成功的关键。
6. 与其他 PEFT 方法的比较
在深入探讨 LoRA 和 QLoRA 之前,有必要回顾参数高效微调(PEFT)领域的其他主要流派。不同的方法在“冻结”与“可训练”参数的边界、以及额外参数插入的位置上存在显著差异,这些差异直接影响了模型的表达能力、推理时的额外开销以及工程实现的复杂度。
1. Adapter:层间瓶颈模块
Adapter 方法由 Houlsby et al. (2019) 提出,其核心思想是在 Transformer 的每一层(通常是 FFN 层之后)插入一个小型的瓶颈网络。该网络由一个降维线性层、一个非线性激活函数和一个升维线性层组成。
- 结构特点:Adapter 是“加性”的,它不改变原始权重,而是通过残差连接将适配器输出加回主路径。
- 参数效率:虽然可训练参数极少(通常不到总参数的 1%),但由于每个层都增加了额外的计算图节点,推理时存在微小的延迟增加。
- 局限性:Adapter 需要修改模型的前向传播代码,且不同层的适配器大小需要单独调优。与 LoRA 相比,Adapter 在推理时无法通过简单的矩阵合并来消除额外开销,必须保留额外的计算步骤。
2. Prompt Tuning:连续提示向量
Prompt Tuning(Lester et al., 2021)采取了一种完全不同的策略:不修改任何模型权重,而是为每个任务学习一组“软提示”(Soft Prompts)。这些软提示是嵌入在输入序列最前端的连续向量,与真实的文本 token 嵌入拼接在一起。
- 直觉:模型学习的是“如何提问”,而不是“如何回答”。通过调整输入分布,引导冻结的预训练模型产生期望的输出。
- 参数效率:参数量极低(仅
seq_len × d_model),且推理时无额外计算开销(只是输入变长了)。 - 关键局限:Lester et al. (2021) 指出,Prompt Tuning 的效果高度依赖于模型规模。在小模型(如 100M 参数)上,其效果往往不如全参微调,甚至不如简单的 Adapter。只有当模型规模达到数十亿参数级别时,其优势才显现。这是因为小模型的“内在维度”较低,难以通过仅调整输入端来充分激发其潜力。
3. Prefix-Tuning:注意力前缀
Prefix-Tuning(Li & Liang, 2021)是 Prompt Tuning 的改进版。它不再将软提示拼接在输入序列中,而是将其作为“前缀”(Prefix)直接注入到 Transformer 每一层的 Key 和 Value 矩阵中。
- 结构特点:通过一个小型的 MLP 网络,从一组可学习的向量生成每一层所需的 Prefix Key 和 Prefix Value。
- 优势:相比 Prompt Tuning,Prefix-Tuning 在小模型上的表现更稳定,因为它直接干预了注意力机制的计算过程,而非仅仅影响输入表示。
- 劣势:实现复杂度较高,需要修改注意力层的内部逻辑。此外,由于 Prefix 在每一层都参与计算,其显存占用和计算开销略高于 Prompt Tuning,但远低于 Adapter。
4. 综合对比与选择建议
| 方法 | 可训练参数位置 | 推理额外开销 | 小模型表现 | 工程复杂度 |
|---|---|---|---|---|
| Adapter | 每层插入瓶颈网络 | 有(微小) | 较好 | 中(需改前向) |
| Prompt Tuning | 输入端软提示 | 无(仅输入变长) | 较差(需大模型) | 低 |
| Prefix-Tuning | 每层 K/V 前缀 | 有(中等) | 良好 | 高(需改注意力) |
| LoRA | 每层线性层旁路 | 无(可合并权重) | 优秀 | 低(标准接口) |
为什么 LoRA 成为主流?
- 推理零开销:LoRA 最大的工程优势在于,训练完成后可以将
W = W₀ + (α/r)BA合并,推理时与原始模型完全一致,无任何额外延迟。而 Adapter 和 Prefix-Tuning 必须保留额外的计算模块。 - 小模型友好:Aghajanyan et al. (2020) 的内在维度研究表明,微调的有效性源于低秩更新。LoRA 直接对权重矩阵进行低秩近似,因此在中小规模模型上也能取得接近全参微调的效果,而 Prompt Tuning 在此场景下往往失效。
- 实现简单:LoRA 只需修改线性层的前向传播,无需像 Prefix-Tuning 那样深入注意力机制内部,也无需像 Adapter 那样设计复杂的瓶颈结构。
常见误区:认为 Prompt Tuning 参数少就一定比 LoRA 好。实际上,在任务适配性和小模型场景下,LoRA 的低秩权重更新往往比输入端的软提示更有效,因为它直接调整了模型的“知识存储”结构,而非仅仅调整“查询方式”。
7. 小结与思考题
回顾本系列教程,我们首先明确了参数高效微调(PEFT)的核心动机:在显存与存储受限的场景下,避免全参微调的高昂成本。其理论基石在于低秩假设:研究表明,语言模型微调时的权重更新 Δ W 具有极低的内在维度(Aghajanyan et al., 2020)。这意味着,尽管原始权重矩阵 W ∈ ℝ^d × k 维度巨大,但其有效变化空间可以被一个低秩矩阵近似。 基于此,LoRA 通过冻结预训练权重 W_0,仅训练低秩分解矩阵 A 和 B 来实现适配。其核心公式为 h = W_0x + (α)/(r)BAx。关键的工程细节在于初始化策略:A 采用随机高斯初始化,而 B 初始化为零矩阵,确保训练初始时刻 Δ W = 0,从而保持预训练模型的原始行为(Hu et al., 2021)。推理时,由于 (α)/(r)BA 可以合并回 W_0,因此不引入额外的计算延迟。相比全参微调,LoRA 将可训练参数减少了约 10000 倍,显存需求降低了约 3 倍(Hu et al., 2021)。 QLoRA 进一步将底座模型量化至 4-bit,引入了 NF4 数据类型、双重量化(Double Quantization)以及分页优化器(Paged Optimizer),使得在单张消费级 GPU 上微调大规模模型成为可能(Dettmers et al., 2023)。与其他 PEFT 方法相比,LoRA 直接作用于线性层权重,而 Adapter、Prefix-Tuning 或 Prompt Tuning 则通过插入额外模块或优化连续提示词来实现(Houlsby et al., 2019; Li & Liang, 2021; Lester et al., 2021)。LoRA 的优势在于其模块化设计和推理时的零开销合并特性。 调参清单:
- Rank (
r):通常从 8 或 16 开始,若过拟合则增大,若欠拟合则减小。 - Scaling Factor (
α):通常设为r或2r,用于调节更新幅度。 - Target Modules:默认作用于
q, v投影层,也可扩展至k, o或 FFN 层。 - Dropout:在 LoRA 层中引入 0.05-0.1 的 Dropout 有助于正则化。
思考题:
- 低秩假设的边界:Aghajanyan et al. (2020) 指出微调更新的内在维度低,但这是否意味着所有下游任务都共享相同的低秩子空间?如果两个任务(如情感分析与代码生成)的更新方向正交,单一 LoRA 适配器是否足以同时捕捉两者? 提示:考虑任务间的干扰(Catastrophic Interference)以及多 LoRA 适配器动态加载的机制。
- 量化误差与反传:QLoRA 中底座权重以 4-bit 存储,但梯度计算通常在更高精度下进行。NF4 数据类型是如何利用信息论最优量化原则来最小化量化损失的?双重量化具体解决了什么额外的显存开销问题? 提示:回顾 NF4 基于正态分布假设的量化方案,以及双重量化对量化常数本身的压缩作用(Dettmers et al., 2023)。
- 推理合并的陷阱:LoRA 在推理时合并权重
W = W_0 + (α)/(r)BA看似无延迟,但在多租户服务器部署中,若需同时服务多个不同 LoRA 适配器,频繁合并/卸载权重会带来什么 I/O 瓶颈?有哪些替代方案可以避免物理合并? 提示:考虑显存带宽限制,以及类似 S-LoRA 或 vLLM 中支持多 LoRA 并行推理的架构设计。
参考文献
- Aghajanyan, Zettlemoyer, Gupta, 2020. Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning. arXiv:2012.13255 arxiv.org/abs/2012.13255
- Hu et al., 2021. LoRA: Low-Rank Adaptation of Large Language Models. arXiv:2106.09685 arxiv.org/abs/2106.09685
- Dettmers et al., 2023. QLoRA: Efficient Finetuning of Quantized LLMs. arXiv:2305.14314 arxiv.org/abs/2305.14314
- Houlsby et al., 2019. Parameter-Efficient Transfer Learning for NLP. arXiv:1902.00751 arxiv.org/abs/1902.00751
- Li & Liang, 2021. Prefix-Tuning: Optimizing Continuous Prompts for Generation. arXiv:2101.00190 arxiv.org/abs/2101.00190
- Lester, Al-Rfou, Constant, 2021. The Power of Scale for Parameter-Efficient Prompt Tuning. arXiv:2104.08691 arxiv.org/abs/2104.08691
Paragoger衍生者AI训练营。发布者:稻草人,转载请注明出处:https://www.shxcj.com/archives/10370