本文属于《AI 深度培训》系列 · 难度:专家 · 篇幅:约 7000 字
预训练是决定大模型基座能力上限的核心工程,涉及数据清洗、优化器配置及分布式系统协同。本文深入解析数据去重与打包策略,推导 AdamW 更新机制,拆解混合精度下的显存占用账本,并系统对比 DP、TP、PP 及 ZeRO 并行策略。旨在帮助工程师平衡显存效率与通信开销,突破单卡限制,构建高效、稳定的大规模训练管线。
目录
1. 导读:一次预训练的全景
在构建大语言模型(LLM)的过程中,预训练是决定模型基座能力上限的核心阶段。这并非简单的“数据输入-模型输出”过程,而是一个涉及海量数据处理、复杂模型架构、高效优化算法以及大规模分布式系统协同的庞大工程。对于一线工程师和研究员而言,理解预训练的全景至关重要,因为任何单点的优化(如仅调整学习率或仅增加 GPU 数量)如果脱离整体系统瓶颈,往往无法带来预期的性能提升,甚至可能导致训练发散或资源浪费。 预训练工程主要包含四个紧密耦合的维度:数据、模型、优化与系统。
- 数据管线:这是模型的“燃料”。原始互联网数据包含大量噪声、重复和低质量内容。高质量的数据过滤、去重(如 MinHash)以及序列打包策略,直接决定了模型学到的语言分布是否纯净。数据质量往往比单纯的数据数量更能影响模型的泛化能力(Kaplan et al., 2020)。
- 模型架构:Transformer 是当前的标准范式,但其计算密集特性对硬件提出了极高要求。理解注意力机制的内存访问模式,是进行后续并行策略设计的基础。
- 优化器与调度:AdamW 及其变体是目前主流的选择。理解一阶/二阶矩估计、解耦权重衰减以及学习率预热与余弦衰减机制,有助于避免训练初期的不稳定和后期的过拟合(Loshchilov & Hutter, 2017)。
- 分布式系统:这是工程实现的“骨架”。当模型参数规模达到数十亿甚至万亿级别时,单卡显存已无法容纳模型状态。必须通过数据并行(DP)、张量并行(TP)、流水线并行(PP)以及 ZeRO 等技术,将模型和状态切分到多卡之间(Shoeybi et al., 2019; Rajbhandari et al., 2019)。
瓶颈在哪里? 在预训练过程中,瓶颈通常不在算力本身,而在显存效率与通信开销的平衡。
- 显存瓶颈:混合精度训练下,仅参数、梯度和优化器状态就占用大量显存。例如,使用混合精度 Adam 训练时,每个参数约需 16 字节(FP16 参数 2 + FP16 梯度 2 + FP32 主参数、动量、方差共 12)(Rajbhandari et al., 2019)。这意味着 7B 参数的模型仅优化器状态就需要约 112GB 显存,远超单卡容量。
- 通信瓶颈:为了切分显存,必须引入跨卡通信。数据并行需要 All-Reduce 梯度,张量并行需要频繁交换激活值,流水线并行则存在气泡时间。如果通信带宽不足或并行策略设计不当,GPU 将大部分时间花在等待数据而非计算上,导致 MFU(Model FLOPs Utilization)大幅下降。
本文路线 本文旨在为专家读者提供一套完整的预训练工程视角,具体路线如下:
- 数据管线:深入解析质量过滤、MinHash 去重原理及文档边界掩码,确保输入数据的高信噪比。
- 优化器细节:从数学推导角度剖析 AdamW 的更新规则,并解释预热与余弦调度对训练稳定性的影响。
- 显存账本:详细拆解 16 字节/参数的显存构成,并探讨激活重计算(Activation Checkpointing)如何以计算换显存。
- 并行策略:对比 DP、TP、PP 的适用场景,重点分析 Megatron 张量并行的切分逻辑及流水线气泡问题。
- ZeRO 技术:解析 ZeRO-1/2/3 如何逐层切分冗余状态,以及通信量与显存节省之间的权衡。
通过阅读本节及后续章节,你将能够根据具体的硬件集群配置,设计出兼顾显存效率与通信开销的预训练系统,并准确诊断训练过程中的性能瓶颈。
2. 数据管线:过滤、去重与打包
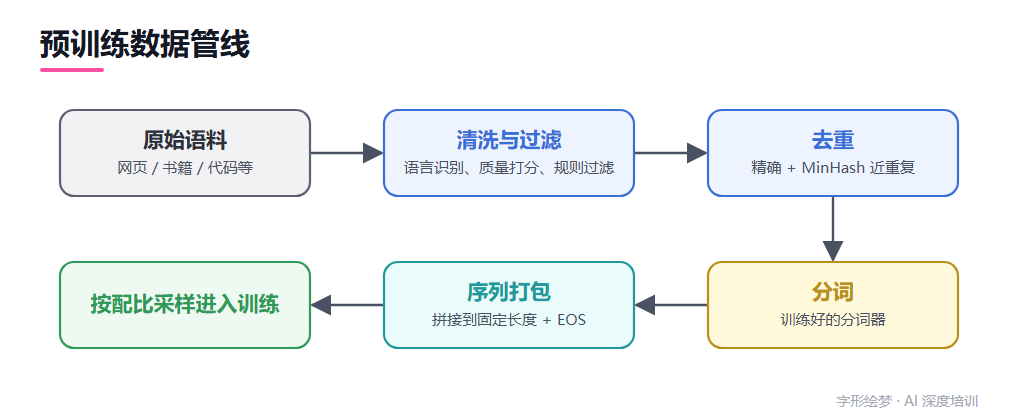
预训练数据的质量直接决定模型的上限。原始网页数据通常包含大量噪声(HTML 标签、广告、乱码)和重复内容,因此需要构建一个高效的数据管线。如下图所示,该管线主要包含质量过滤、语言识别、去重和序列打包四个核心阶段。
质量过滤与语言识别
质量过滤旨在剔除低信息密度的文本。常见策略包括:
- 启发式规则:过滤过短文档、包含过多特殊字符或 HTML 残留的文本。
- 分类器过滤:训练一个轻量级分类器(如基于 BERT 的模型),预测文本的“有用性”分数。Touvron et al., 2023 在 LLaMA 的训练中采用了类似策略,通过过滤低质量数据显著提升了模型效果。
语言识别确保模型在目标语言(如中文或英文)上训练。通常使用 fastText 或 langdetect 等工具进行语言分类,并设定置信度阈值。对于多语言模型,则需保留多种语言并平衡比例。
MinHash 近重复去重
完全重复(Exact Duplicate)可通过哈希表轻松去除,但互联网数据中存在大量近重复(Near-Duplicate),即经过轻微修改(如改写、截断)的文本。直接训练会导致模型过拟合于特定模式,降低泛化能力。 MinHash 是一种高效的近似集合相似度计算方法,常用于 LSH(Locality-Sensitive Hashing)去重:
- 分词与集合化:将文档分词,取所有
k-gram(如 5-gram)组成集合S。 - MinHash 签名:定义
h个独立的哈希函数h_i。MinHash 签名是一个长度为h的向量,其中第i个元素为min_x ∈ S h_i(x)。 - 相似度估计:两个集合
A, B的 Jaccard 相似度J(A,B) = (|A cap B|)/(|A cup B|)可以通过 MinHash 签名的匹配比例无偏估计:
E[ (1)/(h) Σ_i=1^h I(min_x ∈ A h_i(x) = min_y ∈ B h_i(y)) ] = J(A, B)
- LSH 分桶:将 MinHash 签名分成
b个带(band),每个带包含r个哈希值。若任意一个带完全匹配,则视为候选重复对。这种方法将时间复杂度从O(N^2)降低到接近O(N)。
序列打包与文档边界掩码
Transformer 模型通常有固定的上下文长度(如 2048 或 8192 token)。为了高效利用显存和计算资源,需要将短文档打包成长序列。 关键问题:如果简单拼接两个不同文档,模型可能会学习到跨文档的虚假依赖关系(例如,文档 A 的结尾与文档 B 的开头在语义上无关,但模型会尝试预测 B 的开头基于 A 的结尾)。 解决方案:文档边界掩码(Document Boundary Masking) 在构建注意力掩码(Attention Mask)时,需确保每个 token 只能关注同一文档内的前序 token。
# 假设 packed_ids 形状为 [seq_len],doc_ids 形状为 [seq_len]
# doc_ids 中相同值表示属于同一文档
seq_len = packed_ids.shape[0]
# 创建 [seq_len, seq_len] 的掩码矩阵
mask = torch.zeros(seq_len, seq_len, dtype=torch.bool)
# 对于每个位置 i,它只能关注 j <= i 且 doc_ids[j] == doc_ids[i] 的位置
for i in range(seq_len):
    # 找到文档 i 的起始位置(简化逻辑,实际可用向量化操作)
    start_idx = 0
    while start_idx < i and doc_ids[start_idx] == doc_ids[i]:
        start_idx += 1
    # 允许关注 [start_idx, i] 范围内的所有位置
    mask[i, start_idx:i+1] = True
在工程实现中,通常使用向量化操作避免 Python 循环。此外,还需在打包时插入特殊分隔符(如 <eos> 或 <pad>),并在损失计算时屏蔽这些分隔符的位置,避免模型学习无意义的预测目标。 常见误区:
- 忽略文档边界:直接拼接会导致“幻觉”依赖,降低模型质量。
- 打包长度不匹配:若打包后长度远小于模型最大上下文,会浪费计算资源;若远超,则需截断或丢弃,影响数据利用率。
3. 优化器与学习率:AdamW、预热与余弦衰减
在大模型预训练中,优化器不仅决定参数如何更新,更通过超参数调节直接影响训练的稳定性与收敛速度。虽然 SGD 是经典选择,但现代大模型几乎普遍采用 Adam 及其变体 AdamW。其核心在于利用自适应学习率,缓解不同维度梯度尺度差异带来的问题。
1. Adam 的核心机制
Adam(Adaptive Moment Estimation)结合了动量(Momentum)和 RMSProp 的思想。对于参数 θ,它在每一步维护两个状态:一阶矩估计 m(梯度的指数移动平均)和二阶矩估计 v(梯度平方的指数移动平均)。
m_t = β_1 · m_t-1 + (1 - β_1) · g_t
v_t = β_2 · v_t-1 + (1 - β_2) · g_t^2
由于初始值为零,m_t 和 v_t 会偏向于 0,因此需要进行偏差修正(Bias Correction):
m_t = (m_t)/(1 - β_1^t)
v_t = (v_t)/(1 - β_2^t)
最终的参数更新规则为:
θ_t = θ_t-1 - (η)/(√(v_t) + ε) · m_t
其中 η 是学习率,ε 是防止除零的小常数(通常取 10^-8)。这种机制使得对于梯度变化大的维度,有效学习率自动变小;对于梯度变化小的维度,有效学习率自动变大,从而加速收敛。
2. 为什么是 AdamW?解耦权重衰减
原始 Adam 将权重衰减(Weight Decay, L2 正则化)直接加在梯度上。然而,Loshchilov & Hutter (2017) 指出,在自适应优化器中,将 L2 惩罚项与梯度耦合会导致正则化效果被自适应学习率缩放,从而削弱了正则化的作用。 AdamW 的核心改进是解耦(Decoupled)权重衰减。它不再修改梯度,而是在更新参数时直接减去衰减项:
θ_t = θ_t-1 - η ( (m_t)/(√(v_t) + ε) + λ · θ_t-1 )
这里 λ 是权重衰减系数。这种解耦方式确保了权重衰减的大小不受自适应学习率的影响,使得正则化行为更符合预期,在 Transformer 架构中表现优于原始 Adam。
3. 学习率调度:预热与余弦衰减
大模型训练对学习率极度敏感。直接以峰值学习率开始训练往往导致初期损失震荡甚至发散。因此,标准的调度策略包含两个阶段:
- 线性预热(Linear Warmup):在前
N步内,学习率从 0 线性增加到峰值η_max。这有助于模型在参数初始分布较乱时平稳过渡。 - 余弦衰减(Cosine Decay):预热结束后,学习率按余弦函数从
η_max平滑衰减到接近 0(或一个最小值η_min)。
def cosine_schedule(step, warmup_steps, total_steps, max_lr, min_lr):
    if step < warmup_steps:
        # 线性预热
        return max_lr * (step / warmup_steps)
    else:
        # 余弦衰减
        progress = (step - warmup_steps) / (total_steps - warmup_steps)
        decayed_lr = min_lr + 0.5 * (max_lr - min_lr) * (1 + math.cos(math.pi * progress))
        return decayed_lr
4. 梯度裁剪
为了防止个别异常批次导致梯度爆炸,工程上必须使用梯度范数裁剪(Gradient Clipping)。在反向传播后、优化器更新前,计算所有梯度的全局 L2 范数,若超过阈值 max_norm,则按比例缩放所有梯度:
def clip_grad_norm_(parameters, max_norm):
    total_norm = 0.0
    for p in parameters:
        if p.grad is not None:
            total_norm += p.grad.data.norm(2).item() ** 2
    total_norm = total_norm ** 0.5
    clip_coef = max_norm / (total_norm + 1e-6)
    clip_coef = min(1.0, clip_coef)
    for p in parameters:
        if p.grad is not None:
p.grad.data.mul_(clip_coef)工程含义与误区:
- 误区:认为权重衰减越大越好。实际上,过大的衰减会导致模型欠拟合,且与 Adam 的自适应特性相互作用复杂,需仔细调参。
- 建议:预热步数通常占总步数的 1%~5%。梯度裁剪阈值通常设为 1.0,这是经验值,过小的阈值会阻碍学习,过大的阈值则失去保护作用。
4. 显存账本:为什么 1 个参数要 16 字节
在深入并行策略之前,必须先厘清单个参数在混合精度训练中的显存占用。这是理解后续所有内存优化技术(如 ZeRO)的基石。
1. 混合精度训练的显存构成
现代大模型训练通常采用混合精度策略:前向和反向传播使用半精度(FP16/BF16)以加速计算并节省带宽,但优化器状态保持单精度(FP32)以确保数值稳定性。 对于使用 Adam 优化器的模型,每个参数 θ 在显存中实际占用的字节数如下(Rajbhandari et al., 2019):
| 组件 | 精度 | 字节数/参数 | 说明 |
|---|---|---|---|
| 模型参数 | FP16 | 2 | 用于前向/反向传播 |
| 梯度 | FP16 | 2 | 反向传播计算得到 |
| 主参数副本 | FP32 | 4 | 优化器内部维护的高精度参数 |
| 一阶矩 (动量) | FP32 | 4 | Adam 的 m_t |
| 二阶矩 (方差) | FP32 | 4 | Adam 的 v_t |
| 总计 | – | 16 | 每个参数的显存开销 |
直觉理解:虽然参数本身只有 2 字节,但为了精确更新,我们需要额外存储 12 字节的“影子状态”。这意味着一个 7B 参数的模型,仅优化器状态就需要
7 × 10^9 × 16 B ≈ 112 GB显存。这解释了为何单卡无法训练大模型,也引出了 ZeRO 等切分技术的必要性。
2. 激活值显存:被忽视的大头
除了参数和梯度,激活值(Activations) 是显存消耗的另一个主要来源。激活值的大小与以下因素成正比:
Activation Memory ∝ Batch Size × Seq Length × Hidden Dim × Num Layers
在长序列(如 8K 或 32K)训练中,激活值显存往往超过参数显存。例如,对于 7B 模型,若 Batch Size 为 32,Seq Length 为 4096,仅激活值就可能占用数十 GB 显存。
3. 激活重计算(Activation Checkpointing)
为了节省激活值显存,常用重计算技术:
- 原理:在前向传播中不保存中间激活值,仅在反向传播时重新计算。
- 代价:增加约 30% 的计算量(前向计算执行两次)。
- 收益:激活值显存从
O(L)降至O(√(L))(L为层数),显著降低显存峰值。
# 伪代码:激活重计算的核心逻辑
def forward_with_checkpoint(x, layers):
    # 仅保存输入 x,不保存中间激活
    return x
def backward_with_recompute(x, layers):
    # 反向传播时,从 x 开始重新执行前向,获取激活
    activations = []
    for layer in layers:
        x = layer(x)
        activations.append(x)
    # 使用这些重新计算的激活进行梯度计算
    return compute_gradients(activations)
4. 工程含义与常见误区
- 误区 1:认为 FP16 参数只需 2 字节。
- 正解:必须考虑优化器状态,总开销为 16 字节/参数。
- 误区 2:忽略激活值显存。
- 正解:在长序列或大 Batch 下,激活值可能成为瓶颈,需启用重计算。
- 误区 3:盲目启用重计算。
- 正解:重计算增加计算开销,需权衡显存与速度。通常在显存紧张时启用,否则优先使用更大 Batch 或优化器状态切分(ZeRO)。
关键结论:显存规划 = 参数显存(16B/参数) + 激活值显存(与 Batch/Seq 成正比) + 通信缓冲区。理解这一账本,才能正确配置并行策略。
5. 三种并行:数据、张量与流水线
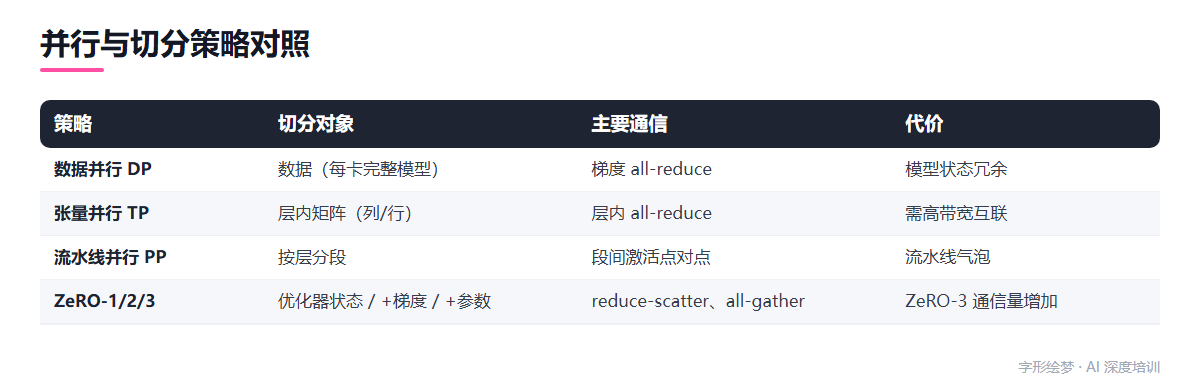
当模型参数量突破单卡显存上限,或数据吞吐成为瓶颈时,单一的分布式策略已无法兼顾效率与容量。工程实践中,通常组合使用数据并行(DP)、张量并行(TP)和流水线并行(PP)。
数据并行:梯度 All-Reduce
数据并行是最基础的策略。每个 GPU 持有完整的模型副本,但处理不同的数据批次。前向传播独立进行,反向传播计算出本地梯度后,通过 All-Reduce 通信原语聚合全局梯度。
# 伪代码:数据并行逻辑
local_grad = backward(local_batch)
global_grad = all_reduce(local_grad)  # 求和并平均,所有卡得到相同结果
optimizer.step(global_grad)
All-Reduce 的通信量为 2 × N_params(Ring All-Reduce 算法)。虽然通信开销随参数量线性增长,但由于计算与通信可重叠,DP 在模型能装入显存时是扩展吞吐的首选。其核心优势在于保持了计算的独立性,故障隔离性好。
张量并行:列/行切分
当模型单层(如 Transformer 的 FFN 或 Attention)过大,无法装入单卡时,需引入张量并行。Megatron-LM 提出的核心思想是将矩阵乘法切分到不同 GPU 上(Shoeybi et al., 2019)。 以线性层 Y = XW 为例,若 W 按列切分为 [W_1, W_2],则 Y = [XW_1, XW_2]。每个 GPU 计算部分输出,最后拼接(All-Gather)。若按行切分 W = [W_1; W_2],则 Y = XW_1 + XW_2,需先切分输入 X,计算后通过 All-Reduce 求和。 Megatron 通常将 Attention 的 QKV 投影按列切分,输出投影按行切分;FFN 的第一层按列切分,第二层按行切分。这种交替切分策略最小化了通信次数,使得 TP 组内通信量极低,适合在 NVLink 高带宽互联的节点内使用。
流水线并行:气泡与微批
流水线并行将模型按层切分,不同 GPU 负责不同的层。数据像流水线一样流过各阶段。然而,这引入了“流水线气泡”(Pipeline Bubble):当第一阶段计算完第一批数据时,后续阶段尚未就绪,导致空闲。 气泡比例近似为 (m-1)/m,其中 m 为微批数量。为减少气泡,需将全局批次拆分为多个微批(Micro-batch)。
# 流水线执行示意 (2 阶段, 2 微批)
Stage 1: [MB1] [MB2] [  空  ]
Stage 2: [ 空  ] [MB1] [MB2]
现代框架(如 1F1B 调度)通过交错前向和反向传播,进一步压缩气泡。PP 适合跨节点扩展,因为层间通信量远小于 TP 的层内通信,对网络带宽要求较低。
工程含义与常见误区
- TP 不宜跨节点:TP 通信频率极高,跨节点网络延迟会导致性能骤降。TP 应限制在单机内。
- DP 与 PP 组合:通常 PP 切分模型层,DP 复制整个流水线,TP 切分单层内部。三者正交,可组合使用。
- 误区:认为增加 DP 路数总能加速。若模型状态(优化器、梯度)超出显存,DP 反而因通信开销和显存压力导致效率下降,此时应优先引入 TP 或 PP 以减少单卡负载。
正确配置并行策略需权衡:显存容量(TP/PP 切分粒度)、通信带宽(TP 节点内,PP/DP 节点间)与计算效率(气泡最小化)。
6. ZeRO:切分冗余状态
在大规模分布式训练中,数据并行(DP)虽然通过复制模型副本实现了计算扩展,但每个 GPU 都需要维护完整的模型状态(参数、梯度、优化器状态)。对于 7.5B 参数的模型,若采用混合精度 Adam 优化器,每卡需存储约 16 字节的模型状态(Rajbhandari et al., 2019)。当数据并行度为 64 时,这种冗余存储导致显存利用率极低,成为扩展瓶颈。ZeRO(Zero Redundancy Optimizer)通过切分冗余状态来解决这一问题,其核心思想是:既然所有 GPU 上的参数、梯度和优化器状态在逻辑上是相同的,那么只需将它们分散存储在不同的 GPU 上,并在需要时通过通信获取。 ZeRO 分为三个阶段,逐步切分更多的状态:
- ZeRO-1:切分优化器状态 这是最基础的优化。每个 GPU 只存储
1/N的优化器状态(如 Adam 的动量和方差)。在反向传播后,各 GPU 计算局部梯度,然后通过 All-Reduce 同步梯度。接着,每个 GPU 利用自己持有的那部分优化器状态和全局梯度,计算出自己负责的那部分参数更新量,再通过 All-Gather 同步更新后的参数。 - 显存节省:显著减少优化器状态占用(通常占 12 字节/参数中的大部分)。
- 通信开销:与标准 DP 相同(All-Reduce 梯度 + All-Gather 参数)。
- ZeRO-2:切分优化器状态 + 梯度 在 ZeRO-1 基础上,进一步切分梯度。每个 GPU 只存储
1/N的梯度。反向传播时,各 GPU 计算局部梯度,但不进行完整的 All-Reduce,而是执行 Reduce-Scatter,使得每个 GPU 最终只持有全局梯度的1/N部分。随后,每个 GPU 使用自己持有的梯度分片和优化器状态分片,计算参数更新,最后通过 All-Gather 同步参数。 - 显存节省:比 ZeRO-1 额外节省梯度存储(2 字节/参数)。
- 通信开销:与标准 DP 相同(Reduce-Scatter 梯度 + All-Gather 参数,总通信量与 All-Reduce 相当)。
- ZeRO-3:切分优化器状态 + 梯度 + 参数 这是最彻底的切分。每个 GPU 只存储
1/N的参数、1/N的梯度和1/N的优化器状态。前向传播时,每个 GPU 需要完整的参数来计算激活值,因此在计算前通过 All-Gather 获取完整参数,计算后立即释放未使用的部分。反向传播时,类似地,通过 Reduce-Scatter 同步梯度分片。 - 显存节省:最大,每卡仅存储
1/N的完整模型状态。 - 通信开销:显著增加。前向和反向传播中都需要多次 All-Gather 和 Reduce-Scatter,通信量约为标准 DP 的 2 倍。
如下图所示,展示了 7.5B 参数模型在 64 路数据并行下,不同 ZeRO 阶段的每卡模型状态显存占用。基线(无 ZeRO)需 120GB,ZeRO-1 降至约 31.4GB,ZeRO-2 降至约 16.6GB,而 ZeRO-3 仅需约 1.9GB(Rajbhandari et al., 2019)。
| 策略       | 每卡存储内容          | 通信操作                     | 相对显存节省 |
|------------|-----------------------|------------------------------|--------------|
| 基线 (DP)  | 参数+梯度+优化器状态  | All-Reduce 梯度              | 0%           |
| ZeRO-1     | 1/N 优化器状态        | All-Reduce 梯度 + All-Gather 参数 | 高           |
| ZeRO-2     | 1/N 优化器+梯度       | Reduce-Scatter 梯度 + All-Gather 参数 | 更高         |
| ZeRO-3 | 1/N 优化器+梯度+参数 | All-Gather 参数 (前/反向) + Reduce-Scatter 梯度 | 最高 |工程注意:ZeRO-3 虽然显存效率最高,但其通信开销大,对网络带宽要求极高。在带宽受限的集群中,ZeRO-2 往往是性能与显存的更好平衡点。此外,ZeRO 通常与张量并行(TP)和流水线并行(PP)结合使用,以进一步突破单卡显存限制。
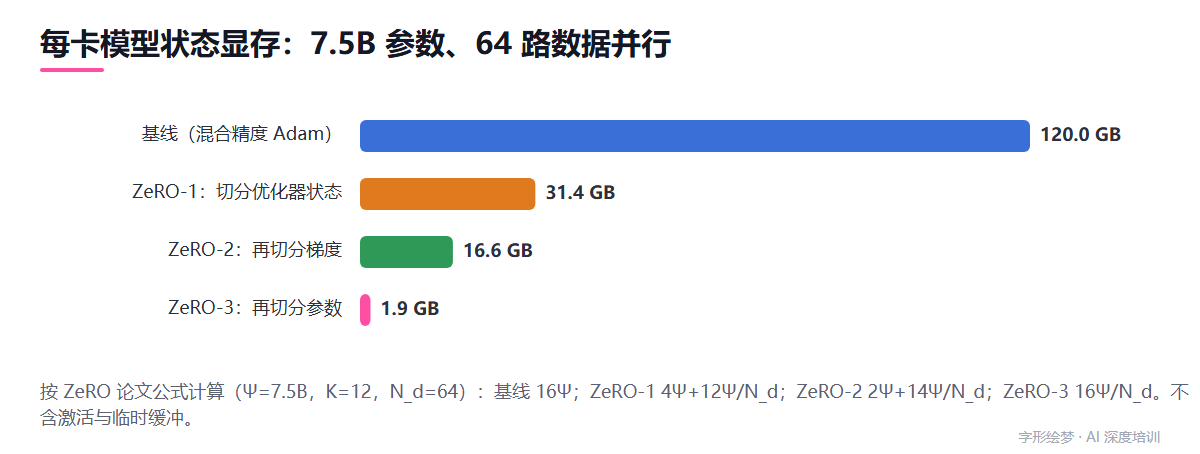
按 ZeRO 论文公式计算(Ψ=7.5B,K=12,N_d=64):基线 16Ψ;ZeRO-1 4Ψ+12Ψ/N_d;ZeRO-2 2Ψ+14Ψ/N_d;ZeRO-3 16Ψ/N_d。不含激活与临时缓冲。
7. 小结与思考题
回顾本次预训练工程的核心逻辑,我们需从显存瓶颈出发,构建数据、优化与并行的协同体系。 关键结论回顾:
- 数据质量是基石:MinHash 去重与文档边界掩码(Document Boundary Masking)直接决定了模型对上下文边界的感知能力,避免跨文档注意力污染。
- 优化器状态是显存大头:混合精度 Adam 训练下,每个参数需占用约 16 字节显存(FP16 参数/梯度各 2 字节,FP32 主参数/动量/方差共 12 字节)(Rajbhandari et al., 2019)。这是并行策略设计的核心约束。
- 并行策略的权衡:
- DP:通信开销最小,但无法解决单卡显存不足。
- TP:将矩阵乘法切分,通信频繁(All-Reduce),需限制在 NVLink 域内(Shoeybi et al., 2019)。
- PP:引入气泡(Bubble),需通过微批(Micro-batch)和 1F1B 调度降低气泡占比。
- ZeRO:通过切分优化器状态(ZeRO-1)、梯度(ZeRO-2)和参数(ZeRO-3),以通信换显存。例如在 7.5B 参数、64 路 DP 场景下,ZeRO-3 可将每卡模型状态显存从基线 120GB 降至约 1.9GB(Rajbhandari et al., 2019)。
配置并行策略的步骤:
- 估算显存需求:基于参数量
N和序列长度L,计算参数、梯度、优化器状态及激活值的总显存。 - 确定 TP 组大小:根据单卡显存上限和 NVLink 带宽,确定 TP 组大小(通常为 4 或 8),确保单卡可容纳切分后的参数与激活。
- 确定 PP 级数:若单卡仍无法容纳所有层,引入 PP。计算气泡占比
(p-1)/(m+p-1)(p为级数,m为微批数),调整m使气泡小于 10%。 - 选择 ZeRO 阶段:在 DP 组内,根据剩余显存选择 ZeRO-1/2/3。显存极度紧张时优先 ZeRO-3,但需评估通信开销对训练速度的影响。
- 验证与调优:监控显存峰值与通信时间,调整 micro-batch size 和 gradient accumulation steps。
思考题:
- 题目:在 TP 中,为何 Column Parallel Linear 后接 Row Parallel Linear 能避免额外的 All-Reduce 通信?若将顺序颠倒,通信模式会发生什么变化?
- 提示:分析矩阵乘法
Y = XA + B中,A按列切分与按行切分时,中间结果XA的分布状态及后续操作所需的归约类型。 - 题目:ZeRO-3 将参数切分至各 DP 卡,前向与反向传播时需动态聚合参数。这种“通信-计算重叠”策略在什么网络拓扑下效率最低?为什么?
- 提示:考虑参数聚合所需的 All-Gather 通信量与计算时间的比值,以及跨节点以太网带宽与 NVLink 带宽的差异。
- 题目:假设你有一个 70B 模型,8 节点 × 8 A100(40GB),NVLink 域为节点内。请设计一个可行的并行配置(TP/PP/DP/ZeRO),并说明如何最小化气泡和通信开销。
- 提示:先确定 TP 组大小(建议 4 或 8),再根据剩余显存决定是否需要 PP。若用 PP,计算所需微批数以控制气泡。最后选择 ZeRO 阶段以优化 DP 组内显存。
参考文献
- Kingma & Ba, 2014. Adam: A Method for Stochastic Optimization. arXiv:1412.6980 arxiv.org/abs/1412.6980
- Loshchilov & Hutter, 2017. Decoupled Weight Decay Regularization. arXiv:1711.05101 arxiv.org/abs/1711.05101
- Rajbhandari et al., 2019. ZeRO: Memory Optimizations Toward Training Trillion Parameter Models. arXiv:1910.02054 arxiv.org/abs/1910.02054
- Shoeybi et al., 2019. Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism. arXiv:1909.08053 arxiv.org/abs/1909.08053
- Kaplan et al., 2020. Scaling Laws for Neural Language Models. arXiv:2001.08361 arxiv.org/abs/2001.08361
- Touvron et al., 2023. LLaMA: Open and Efficient Foundation Language Models. arXiv:2302.13971 arxiv.org/abs/2302.13971
Paragoger衍生者AI训练营。发布者:稻草人,转载请注明出处:https://www.shxcj.com/archives/10366