本文属于《AI 深度培训》系列 · 难度:专家 · 篇幅:约 7000 字
量化并非简单的精度压缩,而是对显存、带宽与计算资源的重新分配。本教程深入解析 INT8、GPTQ、AWQ 及 SmoothQuant 的核心原理,从均匀量化数学基础出发,剖析激活离群值这一关键难点。通过对比仅权重量化与权重加激活量化的工程路径,揭示二阶误差补偿与通道缩放机制,帮助工程师在精度与吞吐间找到最优平衡,实现大模型推理的高效部署。
1. 导读:量化省的是什么
在大模型部署的瓶颈分析中,量化并非单纯的“精度压缩”,而是对硬件资源利用率的重新分配。对于专家级工程师而言,理解量化的价值必须从显存占用、内存带宽与计算吞吐三个维度切入,并明确区分仅权重量化与权重+激活量化的不同工程路径。
1. 显存与带宽:推理的核心瓶颈
在大语言模型(LLM)的自回归推理阶段,尤其是 Batch Size 较小(如 1 或 2)时,系统往往处于内存带宽受限(Memory-Bound)状态。此时,每一步生成的耗时主要取决于将权重从 HBM(高带宽内存)加载到计算单元的速度,而非 FLOPs(浮点运算次数)。 以 LLaMA-7B 为例,FP16 权重占用约 14 GB 显存。若将其量化为 INT8,显存占用减半至 7 GB。在带宽受限场景下,数据读取量减半直接带来接近 2 倍的理论吞吐提升。即使显存充足,带宽节省仍直接转化为延迟降低。此外,显存减半使得单卡可容纳更大参数量的模型,或支持更长的上下文长度,这是量化在工程落地中的首要价值。
2. 仅权重 vs. 权重+激活:两条技术路线
量化策略的选择直接决定了硬件加速的可行性与精度损失的风险:
- 仅权重量化(Weight-only Quantization):
- 代表方法:GPTQ、AWQ。
- 计算流程:权重以 INT8/INT4 存储,但在计算矩阵乘法时,权重需反量化(Dequantize)为 FP16/BF16,再与 FP16 激活进行计算。
- 优势:实现简单,精度损失可控,无需修改算子库。
- 局限:计算单元仍执行 FP16 运算,无法利用 INT8 Tensor Core 的 2 倍算力优势;带宽节省主要来源于权重读取量减少。
- 适用场景:显存受限、对延迟敏感但算力未饱和的场景。
- 权重+激活量化(W8A8 / W4A16 等):
- 代表方法:SmoothQuant、LLM.int8()。
- 计算流程:权重和激活均以低精度(如 INT8)存储和计算,直接调用 INT8 GEMM 算子。
- 优势:同时节省显存、带宽,并提升计算吞吐(利用 INT8 Tensor Core)。
- 挑战:激活值中存在显著的离群值(Outliers),导致 INT8 量化误差极大。必须通过算法(如 SmoothQuant 的逐通道缩放)或混合精度(如 LLM.int8() 的分解计算)来缓解精度损失。
- 适用场景:追求极致吞吐、Batch Size 较大、算力受限的场景。
3. 本文路线
本节导读旨在建立量化的性能直觉。后续章节将深入算法原理:
- 均匀量化数学基础:解析量化公式、粒度选择(张量/通道/组)对精度的影响。
- 离群值问题:剖析 LLM 激活分布特性,介绍 LLM.int8() 的混合精度分解策略(Dettmers et al., 2022)。
- GPTQ:基于 Hessian 矩阵的二阶误差补偿机制,实现高精度权重量化(Frantar et al., 2022)。
- AWQ 与 SmoothQuant:前者通过保护显著权重通道优化权重量化(Lin et al., 2023);后者通过等价缩放将激活量化难度迁移至权重,实现 W8A8 加速(Xiao et al., 2022)。
通过本节,读者应能根据硬件瓶颈(带宽 vs. 算力)和精度要求,初步判断应选用仅权重量化还是全低精度量化方案。
2. 均匀量化的数学
在深入讨论离群值处理之前,必须先厘清量化的基本数学框架。量化的本质是将连续的高精度浮点数映射到有限的离散整数集合,这一过程通常由两个步骤组成:量化(Quantization)与反量化(Dequantization)。 对于任意一个浮点张量 X,其量化后的整数张量 Q 通常定义为:
q = round(x / s) + z
其中,x 是原始浮点值,s 是缩放因子(scale factor),z 是零点(zero point)。反量化则是将整数还原为近似浮点值的过程:
x ≈ (q - z) * s
这里的关键在于 s 和 z 的确定。它们通常由张量的最小值 x_min 和目标位宽 b(如 8 或 4)决定。
对称与非对称量化
根据是否包含零点,量化分为两类:
- 对称量化(Symmetric):假设数据分布关于 0 对称,此时
z = 0。 - 适用场景:权重(Weights)。因为神经网络权重通常围绕 0 分布,且对称量化在硬件上更易于实现(无需额外的加法操作)。
- 公式:
s = max(|x_min|, |x_max|) / 2^b-1。 - 量化:
q = round(x / s)。 - 非对称量化(Asymmetric):允许数据分布偏移,此时
z ≠ 0。 - 适用场景:激活值(Activations)。ReLU 等激活函数产生的非负值分布明显不对称。
- 公式:
s = (x_max - x_min) / (2^b - 1)z = round(-x_min / s)
注意:在实际工程中,对称量化更常用于权重,而非对称量化更常用于激活。但在 LLM 推理中,由于权重占显存主导,且权重分布相对对称,权重通常采用对称量化,而激活值则需根据具体分布决定。
量化粒度:张量、通道与组
量化参数的计算范围决定了精度与开销的平衡,主要分为三种粒度:
| 粒度 | 描述 | 优点 | 缺点 | 典型应用 |
|---|---|---|---|---|
| 张量级(Tensor-wise) | 整个张量共享一组 (s, z) |
计算开销最小,硬件友好 | 精度最低,易受离群值影响 | 早期 INT8 推理 |
| 通道级(Channel-wise) | 每个输出通道(或输入通道)独立一组 (s, z) |
精度显著提升,能捕捉通道间分布差异 | 需存储更多缩放因子,计算略增 | GPTQ、AWQ 等现代方法 |
| 组级(Group-wise) | 将张量划分为若干组,每组独立一组 (s, z) |
精度最高,接近 FP16 | 存储开销大,硬件支持复杂 | QLoRA、4-bit 量化 |
如下图所示,70 亿参数模型的权重存储(仅权重)在 INT8 下约为 7 GB,而 FP16 下为 14 GB。若采用组级量化(如 128 个元素一组),虽然精度接近 FP16,但需额外存储大量缩放因子,实际显存占用会略高于纯 INT8。
# 伪代码:通道级对称量化
def quantize_channel_wise(W, b=8):
    # W: [out_channels, in_channels]
    # 对每个输出通道独立计算 scale
    scales = []
    for i in range(W.shape[0]):
        max_val = torch.max(torch.abs(W[i]))
        s = max_val / (2**(b-1) - 1)
        scales.append(s)
    scales = torch.stack(scales)  # [out_channels, 1]
    # 量化
    Q = torch.round(W / scales)
    # 反量化(用于推理或训练模拟)
    W_deq = Q * scales
return Q, scales常见误区:
- 误以为 INT8 总是比 FP16 快:在带宽受限场景下,INT8 确实能提升吞吐;但在计算受限场景(如小 batch 推理),反量化与量化操作的开销可能抵消带宽收益。
- 忽略缩放因子的存储:组级量化时,缩放因子本身需以 FP16 或 FP32 存储,若组过小(如 16 个元素一组),缩放因子占比可能高达 50% 以上,导致实际显存节省有限。
小结
均匀量化的核心是通过 (s, z) 将浮点数映射到整数。对称量化适用于权重,非对称量化适用于激活;粒度越细,精度越高,但硬件开销与存储成本也越大。理解这一基础,是后续分析 GPTQ、AWQ 等高级方法的前提。
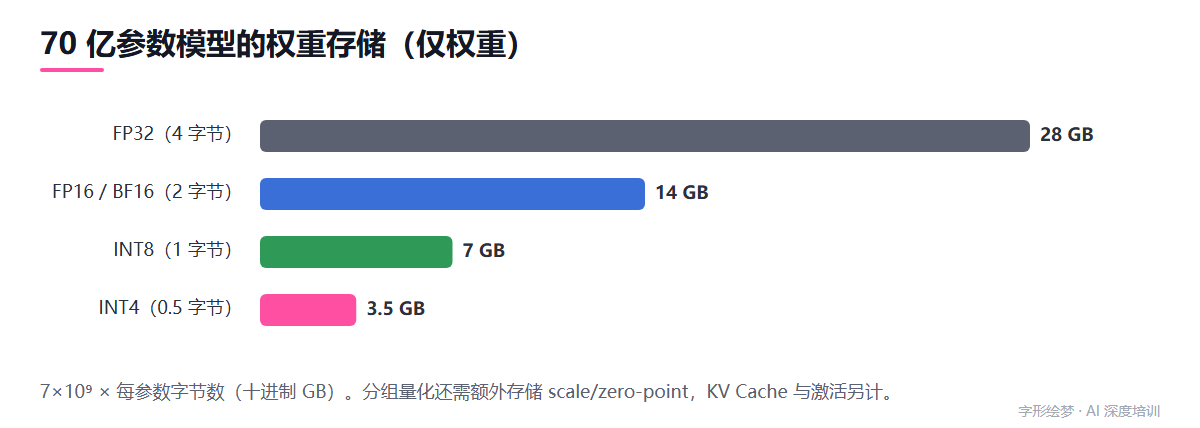
7×10⁹ × 每参数字节数(十进制 GB)。分组量化还需额外存储 scale/zero-point,KV Cache 与激活另计。
3. 离群值:LLM 量化的核心难点
在大语言模型(LLM)的量化实践中,权重分布通常较为平滑,易于量化;然而,激活值(Activations)中普遍存在离群值(Outliers),这是阻碍高精度 INT8 量化的核心障碍。所谓离群值,是指在激活张量的某些特定通道(Channel)或特征维度上,数值幅度显著高于其他维度,往往达到均值或标准差的数十倍甚至上百倍。 这种分布特性源于 Transformer 架构中的 LayerNorm 机制以及自注意力层中特定 token 的显著性。当对激活值进行均匀量化时,量化的缩放因子(Scale Factor)必须由最大绝对值决定,以覆盖所有数值范围。若存在大幅值离群值,缩放因子会被迫放大,导致大量正常幅度的激活值被压缩到极少的量化级别中,产生严重的量化噪声。这种噪声在矩阵乘法中会进一步放大,最终导致模型精度急剧下降,甚至不可用。 针对这一痛点,Dettmers et al. (2022) 提出了 LLM.int8() 方法,其核心思想是混合精度分解(Mixed Precision Decomposition)。该方法不再试图强行将所有激活值量化为 INT8,而是识别出那些包含离群值的特征维度,将这些维度保留为 FP16 精度进行计算,而将剩余的、分布平滑的大部分维度量化为 INT8 并进行矩阵乘法。 具体而言,LLM.int8() 将激活矩阵 X 分解为两部分:X = X_out + X_normal。其中,X_out 包含所有绝对值超过阈值 τ 的元素(即离群值),其余元素置零;X_normal 则包含剩余元素。由于 X_out 中非零元素极少(稀疏性高),其计算开销很小,可以直接使用 FP16 精度计算 X_out W。而 X_normal 的数值范围受限,可以安全地量化为 INT8,利用硬件加速的 INT8 矩阵乘法计算 X_normal W。最终结果通过加法融合:
Y = X W = (X_out + X_normal) W = X_out W + X_normal W
这种策略巧妙地避开了离群值对量化步长的破坏,使得在保持接近 FP16 精度的同时,获得了显著的显存节省和计算加速。然而,LLM.int8() 主要解决的是激活量化中的离群值问题,其权重仍保持高精度(或单独量化)。这引出了后续工作的思考:是否可以在不牺牲精度的前提下,让权重也参与低比特计算,从而实现真正的 W8A8(Weight 8-bit, Activation 8-bit)加速?这正是 GPTQ 和 SmoothQuant 等后续方法试图解决的问题。
工程提示:在实际部署中,识别离群值的阈值
τ是一个超参数。过高的阈值会导致 FP16 部分占比过大,失去量化加速意义;过低的阈值则可能漏掉部分离群值,引入精度损失。通常需要根据具体模型层和校准数据集进行微调。
4. GPTQ:逐列量化与误差补偿
在大模型量化中,直接对权重进行独立舍入往往会因累积误差导致精度显著下降。GPTQ(Frantar et al., 2022)提出了一种基于二阶信息的一次性(one-shot)后训练量化方法,其核心思想是:在量化某一列权重时,利用 Hessian 矩阵近似估计该操作对整体输出误差的影响,并通过调整尚未量化的其余列权重来补偿这一误差。
直觉与形式化定义
假设我们有一个线性层 Y = XW,其中 X ∈ ℝ^m × k 是输入激活,W ∈ ℝ^k × n 是权重矩阵。我们的目标是将 W 量化为低精度格式(如 INT4 或 INT8),同时最小化输出误差 \|XW - XW\|_F^2。 展开该目标函数,可以得到:
min_W ||X(W - W)||_F^2 = (W - W)ᵀ (Xᵀ X) (W - W)
这里 H = Xᵀ X 就是 Hessian 矩阵。由于 X 是固定的(来自校准数据集),H 也是固定的正定矩阵。GPTQ 的关键洞察在于:量化误差不是独立发生的,而是可以通过调整其他未量化的权重列来“吸收”或“补偿”。
逐列量化与误差补偿算法
GPTQ 采用贪心策略,逐列(column-wise)进行量化。具体步骤如下:
- 初始化:计算 Hessian 矩阵
H = Xᵀ X,并对其进行 Cholesky 分解或求逆,以便高效计算。 - 逐列处理:对于每一列
w_j: - 量化当前列:将
w_j量化为w_j。 - 计算误差:误差项为
e_j = w_j - w_j。 - 补偿未量化列:利用 Hessian 矩阵的信息,将误差
e_j按比例分配给尚未量化的列w_k(k > j)。更新公式为:
w_k ← w_k - fracH_jkH_jj e_j
其中 H_jk 是 Hessian 矩阵的第 j 行第 k 列元素,H_jj 是对角线元素。
伪代码
def gptq_quantize(W, X, bits):
    # W: [k, n] 权重矩阵
    # X: [m, k] 校准输入
    # bits: 目标比特数 (e.g., 4 or 8)
    H = X.T @ X  # [k, k] Hessian 矩阵
    H_inv = np.linalg.inv(H)  # 预计算逆矩阵,或存储 Cholesky 分解
    W_hat = np.zeros_like(W)
    for j in range(W.shape[0]):  # 逐列量化
        # 量化当前列
        W_hat[j, :] = quantize(W[j, :], bits)
        # 计算误差
        error = W[j, :] - W_hat[j, :]
        # 补偿后续未量化列
        for k in range(j + 1, W.shape[0]):
            # 更新未量化列,吸收当前列的量化误差
            W[k, :] -= (H_inv[j, k] / H_inv[j, j]) * error
    return W_hat
工程含义与常见误区
- 校准数据的重要性:GPTQ 的效果高度依赖于校准数据集
X的分布。如果校准数据与推理时输入分布差异较大,Hessian 矩阵的估计将不准确,导致补偿失效。 - 计算开销:虽然 GPTQ 是 one-shot 方法,但计算和存储 Hessian 矩阵及其逆矩阵的开销较大,尤其对于大模型。工程上通常使用分块(block-wise)策略来降低内存占用。
- 误区:GPTQ 仅针对权重量化,不处理激活量化。若需 W8A8 精度,需结合 SmoothQuant(Xiao et al., 2022)等方法处理激活中的离群值。
5. AWQ 与 SmoothQuant
AWQ 与 SmoothQuant:从“保护”到“迁移”
在 LLM 量化中,激活值(Activations)的离群值是 W8A8(权重 INT8 + 激活 INT8)的主要障碍。GPTQ 和 AWQ 主要关注权重量化,而 SmoothQuant 则致力于解决激活量化难题。这两类方法代表了两种不同的工程哲学:AWQ 通过“保护”重要权重通道来维持精度,SmoothQuant 通过“迁移”计算难度来平衡量化范围。
AWQ:基于激活分布的权重量化
AWQ(Activation-aware Weight Quantization)的核心洞察是:并非所有权重通道对输出同等重要。通过统计校准数据,AWQ 发现少数“显著”通道(Significant Channels)承载了大部分信息贡献,而多数通道贡献较小。若对所有权重通道统一量化,显著通道的量化误差会被放大,导致精度大幅下降。 AWQ 的策略是非均匀量化:对显著通道保留更高精度(如 FP16 或更细的 INT8 步长),对非显著通道使用更激进的量化。具体实现中,AWQ 不改变权重矩阵 W 的数值,而是通过引入一个缩放因子向量 s,将量化难度从“显著权重”转移到“激活值”上。 数学上,原始线性层为 Y = XW。AWQ 引入逐通道缩放 s,使得:
Y = X (W / s) * s
其中 W/s 是量化后的权重,s 是逐通道缩放因子。关键在于,s 的选择使得 W/s 的分布更易于量化(方差更小),而 X · s 的分布虽然变大,但激活值通常比权重更容易处理(因为激活值在推理中是动态的,且硬件对 FP16 激活乘 INT8 权重的支持较好,或者通过后续 SmoothQuant 进一步平衡)。 AWQ 的优化目标是最小化量化误差,同时保持显著通道的相对重要性。其伪代码如下:
def awq_quantize(W, X_calib):
    # W: [out_dim, in_dim], X_calib: [batch, in_dim]
    # 1. 计算激活统计量,确定显著通道
    act_scale = X_calib.abs().mean(dim=0)  # [in_dim]
    # 2. 计算缩放因子 s
    # s 通常与 act_scale 成正比,保护高激活通道对应的权重
    # 这里简化为:s = act_scale ** alpha, alpha 是超参数
    alpha = 0.5
    s = act_scale ** alpha
    # 3. 缩放权重
    W_scaled = W / s.unsqueeze(0)  # [out_dim, in_dim]
    # 4. 量化 W_scaled
    W_int8, scale = quantize_int8(W_scaled)
    # 5. 推理时:Y = (X * s) @ W_int8.T * scale
    # 注意:X * s 可能溢出 INT8,需确保 X * s 在 INT8 范围内
    # 或采用混合精度:X 保持 FP16,W 为 INT8
    return W_int8, scale, s
SmoothQuant:激活与权重的再平衡
SmoothQuant(Xiao et al., 2022)针对 W8A8 场景,提出了更优雅的解法:将激活的量化难度迁移到权重。 核心思想是:如果激活 X 中存在离群值,导致其动态范围过大难以量化,我们可以通过逐通道缩放 s,使得 X' = X / s 的分布更平滑,同时 W' = s · W 的分布也保持在可量化范围内。 数学推导:
Y = XW = (X · diag(s)^-1) · (diag(s) · W)
其中 diag(s) 是对角矩阵。关键在于选择 s,使得 X/s 和 s · W 的量化误差最小。SmoothQuant 通过优化 s 的值,使得两者的动态范围平衡,从而同时实现 INT8 量化。 SmoothQuant 的优势在于:
- 无需修改硬件:完全兼容标准 INT8 矩阵乘。
- 精度损失小:通过数学等价变换,避免了离群值对量化步长的破坏。
- 通用性强:适用于 LLM 中的 Linear、Attention 等模块。
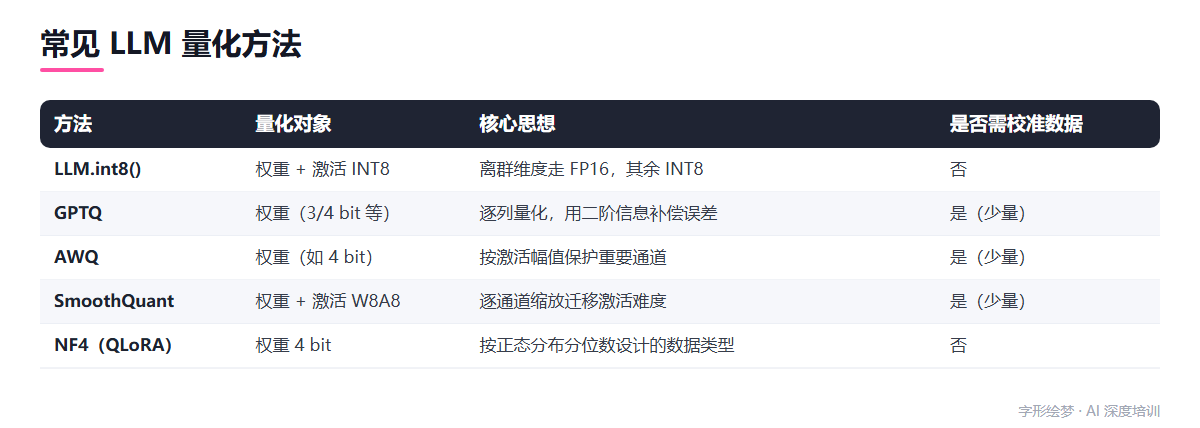
如下图所示,常见 LLM 量化方法在精度、速度和硬件兼容性上各有侧重。AWQ 侧重于权重量化的精度保护,SmoothQuant 侧重于激活-权重的联合优化,两者常结合使用以实现高性能 W8A8 推理。
工程含义与误区
- AWQ 的误区:认为 AWQ 是纯权重量化。实际上,AWQ 的推理阶段需要激活缩放,若硬件不支持 FP16 激活乘 INT8 权重,则需额外处理。
- SmoothQuant 的误区:认为 SmoothQuant 可以单独解决所有量化问题。实际上,它主要解决激活离群值问题,对于权重本身的分布异常(如某些层权重方差极大),仍需结合 GPTQ 或 AWQ 的权重量化策略。
- 选型建议:
- 若目标是 W8A8(权重+激活均 INT8),优先使用 SmoothQuant。
- 若目标是 W8A16(权重 INT8,激活 FP16),AWQ 是更优选择,因其对权重精度保护更精细。
- 若资源允许,可结合 GPTQ(权重量化)+ SmoothQuant(激活平衡)以获得最佳精度-速度权衡。
6. 小结与思考题
回顾本系列关于推理优化的核心脉络,量化的本质是在精度损失可控的前提下,通过降低数值位宽来换取显存占用、内存带宽及计算吞吐的提升。针对大模型特有的激活离群值(Outliers)难题,业界演化出了三类典型策略:
- 混合精度分解:LLM.int8() 识别出激活中少数幅值巨大的维度,将其保留为 FP16 计算,其余维度执行 INT8 矩阵乘,从而在无需校准数据的情况下解决精度崩塌问题(Dettmers et al., 2022)。
- 二阶误差补偿:GPTQ 利用 Hessian 矩阵的近似信息,在逐列量化权重时,通过更新剩余未量化列来补偿当前列量化带来的误差,实现高精度的权重量化(Frantar et al., 2022)。
- 难度迁移与保护:SmoothQuant 通过数学等价变换
X · W = (X · diag(s)^-1) · (diag(s) · W),将激活的量化难度平滑地迁移到权重上,实现 W8A8 量化(Xiao et al., 2022);而 AWQ 则关注激活分布,识别出对输出影响显著的“显著权重通道”,对这些通道保留高精度或进行特殊处理,避免量化敏感区域受损(Lin et al., 2023)。
选型对照建议:
- 若追求极致低显存且可接受少量精度损失,优先选择 AWQ 或 GPTQ 进行 4-bit 权重量化,配合 QLoRA 等微调技术可进一步降低门槛(Dettmers et al., 2023)。
- 若硬件支持 INT8 Tensor Core 且追求高吞吐推理,SmoothQuant 是 W8A8 场景下的稳健选择,尤其适合对延迟敏感的服务端部署。
- 若无法修改模型结构且缺乏校准数据,LLM.int8() 提供了最即插即用的 8-bit 加速方案。
思考题:
- GPTQ 的 Hessian 近似:GPTQ 使用 Cholesky 分解来近似 Hessian 矩阵,这要求 Hessian 是正定的。在实际大模型中,若某些层出现非正定情况,GPTQ 的量化过程会发生什么?如何通过正则化或回退策略保证稳定性?
- 提示:关注 Cholesky 分解失败时的数值行为,以及添加对角项(Jitter)的作用。
- SmoothQuant 的缩放因子
s:SmoothQuant 中缩放因子s的选择依赖于激活的统计量(如p-percentile)。如果输入数据分布发生漂移(Distribution Shift),固定的s会导致什么后果?如何设计在线自适应机制来动态调整s? - 提示:思考激活最大值
max(|X|)与max(|W|)的比值变化对量化范围的影响。 - AWQ 与 GPTQ 的互补性:AWQ 强调保护“显著权重”,GPTQ 强调“误差补偿”。如果将 AWQ 的显著通道检测机制引入 GPTQ 的量化顺序中(即优先量化非显著通道,最后量化显著通道),是否能进一步提升 4-bit 量化的精度?为什么?
- 提示:分析量化顺序对误差累积路径的影响,以及显著通道对最终输出误差的放大效应。
参考文献
- Dettmers et al., 2022. LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale. arXiv:2208.07339 arxiv.org/abs/2208.07339
- Frantar et al., 2022. GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers. arXiv:2210.17323 arxiv.org/abs/2210.17323
- Lin et al., 2023. AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration. arXiv:2306.00978 arxiv.org/abs/2306.00978
- Xiao et al., 2022. SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models. arXiv:2211.10438 arxiv.org/abs/2211.10438
- Dettmers et al., 2023. QLoRA: Efficient Finetuning of Quantized LLMs. arXiv:2305.14314 arxiv.org/abs/2305.14314
Paragoger衍生者AI训练营。发布者:稻草人,转载请注明出处:https://www.shxcj.com/archives/10383