本文属于《AI 深度培训》系列 · 难度:专家 · 篇幅:约 7000 字
大模型解码常受限于显存带宽,串行生成导致权重反复读取,耗时远超计算本身。投机解码利用这一特性,通过轻量草稿模型快速“猜”出多个候选 token,再由大模型一次性并行“验”证。该机制将多次串行前向压缩为单次并行验证,在严格保证输出分布不变的前提下,显著降低延迟并提升吞吐,是无需重训即可落地的关键推理加速技术。
1. 导读:用小模型“猜”,大模型“批改”
大模型推理的瓶颈往往不在计算,而在内存带宽。在解码阶段,每生成一个 token,都需要将整个模型权重从显存加载到计算单元。对于千亿参数模型,这种“读权重”的耗时远超矩阵乘法本身的计算时间。这就是所谓的带宽受限(memory-bound)特性。 传统自回归解码是串行的:生成第 t 个 token 后,才能开始生成第 t+1 个。这意味着每次前向传播都伴随着高昂的权重读取成本。然而,如果我们将验证多个 token 合并为一次前向传播,情况会发生微妙变化。虽然计算量略微增加,但权重只需要读取一次。由于计算单元(如 Tensor Core)的利用率在批量处理时更高,且权重读取是主要开销,验证 k 个 token 的耗时通常只比验证 1 个 token 稍长,甚至接近恒定。 投机解码(Speculative Decoding)正是利用了这一不对称性。其核心思想是“猜”与“验”:
- 猜:使用一个轻量级、推理速度极快的草稿模型(Draft Model),快速自回归地生成
γ个候选 token。这一步成本极低。 - 验:将草稿模型生成的
γ个 token 连同上下文一起,输入到目标大模型(Target Model)中进行一次并行前向传播。 - 判:利用目标模型输出的概率分布,逐个判断草稿 token 是否被接受。若接受,则直接保留;若拒绝,则从修正后的分布中重新采样。
这种机制的关键优势在于,它将原本串行的 γ+1 次大模型前向传播,压缩为 1 次大模型前向传播 + γ 次小模型前向传播。只要小模型的推理速度足够快,且草稿 token 的接受率足够高,整体吞吐率就能显著提升。
为什么重要? 在长文本生成、实时对话等对延迟敏感的场景中,解码速度直接决定了用户体验。投机解码提供了一种无需修改模型结构、无需重新训练、且理论上保证输出分布与原始模型完全一致(Leviathan et al., 2023;Chen et al., 2023)的加速方案。它不改变模型的行为,只改变计算的调度方式,因此具有极高的工程落地价值。
本文路线:
- 算法流程:拆解草稿生成、并行验证、接受/拒绝的具体步骤。
- 数学原理:通过修正拒绝采样(Modified Rejection Sampling)证明输出分布不变性,并推导期望加速比。
- 工程实现:探讨 Medusa 等多头预测变体、KV Cache 管理以及批处理场景下的优化策略。
- 性能分析:分析接受率
α、草稿长度γ与加速比之间的权衡关系。
通过本节导读,读者应建立“带宽受限”与“并行验证”的直觉认知,为后续深入算法细节和数学证明奠定基础。
2. 算法流程
投机解码的核心思想在于利用“小模型猜,大模型批改”的异步并行机制,将原本串行的自回归生成过程转化为批量验证过程。这一流程通常包含三个关键阶段:草稿生成、目标验证与接受/拒绝决策。 首先,草稿模型(Draft Model)基于当前上下文,自回归地生成 γ 个候选 token。假设当前已生成的序列为 x_1:t,草稿模型 q(·) 依次采样得到 y_1, y_2, dots, y_γ。这一步骤的计算量远小于目标模型,因为草稿模型参数量小,且 γ 通常较小(如 3-5),其耗时可忽略不计。 随后,目标模型(Target Model)执行一次前向传播。关键在于,目标模型并非逐个处理这 γ 个 token,而是将它们作为输入序列的一部分,一次性计算所有位置的隐藏状态。具体来说,目标模型 p(·) 接收序列 [x_1:t, y_1, dots, y_γ],通过一次矩阵运算(利用因果掩码),同时输出 t+1 到 t+γ+1 位置的概率分布。这意味着,目标模型在一次前向传播中,实际上得到了 γ+1 个分布:p(· | x_1:t)、p(· | x_1:t, y_1)、……、p(· | x_1:t, y_1, dots, y_γ)。如下图所示,这种“一次前向,多步验证”的特性是投机解码效率的来源。 最后,进入逐个接受/拒绝阶段。算法从第一个候选 token y_1 开始,依据修正拒绝采样规则判断是否接受。若 y_1 被接受,则继续检查 y_2;若 y_1 被拒绝,则立即停止后续检查,并根据修正后的分布重采样一个新 token 作为本轮的最终输出。这一过程保证了无论接受多少个草稿 token,最终生成的序列分布始终与目标模型独立采样一致。
def speculative_decode_step(draft_model, target_model, context, gamma):
    # 1. 草稿生成:自回归生成 gamma 个 token
    draft_tokens = []
    current_context = context
    for _ in range(gamma):
        next_token = draft_model.sample(current_context)
        draft_tokens.append(next_token)
        current_context = append_token(current_context, next_token)
    # 2. 目标验证:一次前向获取 gamma+1 个分布
    # 输入序列为 context + draft_tokens
    full_sequence = append_tokens(context, draft_tokens)
    # 目标模型输出 full_sequence 中每个位置的概率分布
    # 我们关注的是 context 最后一个位置之后,以及 draft_tokens 各位置之后的分布
    target_dists = target_model.forward(full_sequence)
    # target_dists[i] 对应序列中第 i 个 token 之后的预测分布
    # 我们需要的是 dist_0 (对应 context 末尾), dist_1 (对应 y1 末尾), ..., dist_gamma (对应 y_gamma 末尾)
    # 3. 接受/拒绝决策
    accepted_tokens = []
    for i in range(gamma):
        # 获取草稿模型在位置 i 的分布 q(y_i | ...)
        # 获取目标模型在位置 i 的分布 p(y_i | ...)
        # 注意:这里的 p 分布是 target_dists[i],q 分布是草稿模型生成 y_i 时的分布
        # 简化示意:实际需对齐分布索引
        p_dist = target_dists[i]
        q_dist = draft_model.get_dist_at_step(i, context, draft_tokens[:i])
        # 修正拒绝采样判断
        # 接受概率 min(1, p(y_i) / q(y_i))
        # 若接受,加入 accepted_tokens
        # 若拒绝,停止循环,进入重采样逻辑
        if accept_draft_token(p_dist, q_dist, draft_tokens[i]):
            accepted_tokens.append(draft_tokens[i])
        else:
            # 拒绝:从 norm(max(0, p - q)) 重采样
            corrected_dist = max(0, p_dist - q_dist)
            corrected_dist = normalize(corrected_dist)
            new_token = sample_from(corrected_dist)
            accepted_tokens.append(new_token)
            return accepted_tokens # 本轮结束
    # 如果所有 gamma 个 token 都被接受
    # 还需要处理第 gamma+1 个位置:从 p(· | ..., y_gamma) 采样一个新 token
    final_dist = target_dists[gamma]
    new_token = sample_from(final_dist)
    accepted_tokens.append(new_token)
    return accepted_tokens
上述伪代码展示了单轮投机解码的逻辑骨架。需要注意的是,虽然逻辑上是“逐个”判断,但在工程实现中,接受/拒绝的判断可以并行化,因为每个位置的判断仅依赖于该位置的目标分布和草稿分布,以及前一个位置是否被接受(这是一个前缀依赖,但可通过位掩码优化)。核心优势在于,目标模型的昂贵计算(矩阵乘法)只发生了一次,而验证了 γ+1 个潜在的生成步。
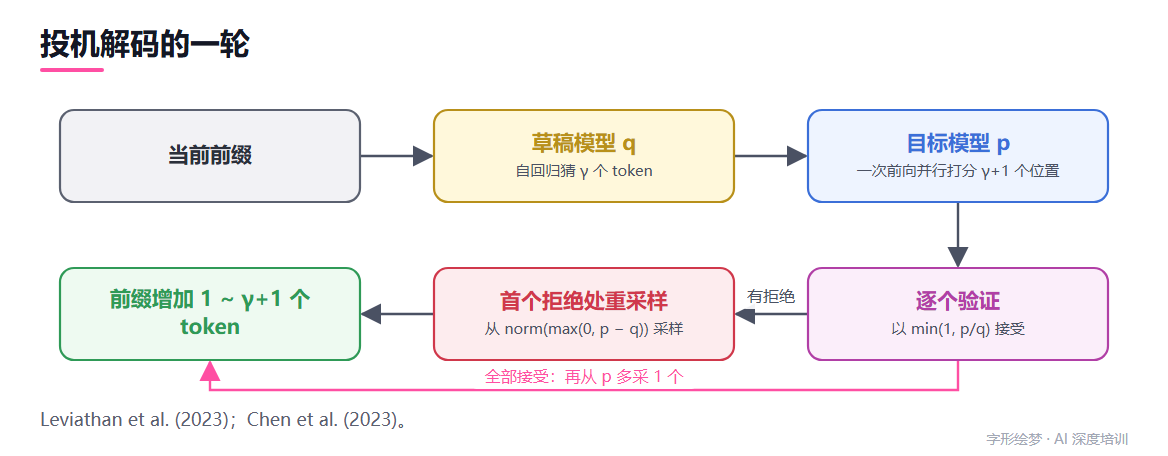
Leviathan et al. (2023);Chen et al. (2023)。
3. 为什么输出分布不变:修正拒绝采样
投机解码的核心价值在于通过并行验证机制打破自回归生成的串行瓶颈,同时严格保持输出分布与目标模型一致。这一特性并非近似,而是基于修正拒绝采样(Modified Rejection Sampling)的数学保证(Leviathan et al., 2023;Chen et al., 2023)。理解其原理需从采样机制入手。 设目标模型分布为 p(x),草稿模型分布为 q(x)。对于草稿生成的候选 token x,算法首先以概率 min(1, p(x)/q(x)) 进行接受判定。若接受,则 x 成为最终输出;若拒绝,则需从修正分布中重新采样。该修正分布定义为 r(x) = (max(0, p(x) - q(x)))/(Σ_y max(0, p(y) - q(y)))。这一构造确保了最终输出严格服从 p(x)。
P(output = x) = q(x) · min(1, p(x)/q(x)) + q(x) · (1 - min(1, p(x)/q(x))) · r(x)
上述等式可分两种情形推导。当 p(x) ≥ q(x) 时,接受概率为 1,拒绝项为零,故 P(output = x) = q(x)。但这似乎与目标分布 p(x) 矛盾?关键在于,此情形下 r(x) = 0,因为 max(0, p(x)-q(x)) 虽为正,但需结合整体归一化理解。实际上,标准推导应直接计算联合概率:
P(output = x) = q(x) · (p(x))/(q(x)) · I[p(x) ≤ q(x)] + q(x) · 1 · I[p(x) > q(x)] + q(x) · (1 - (p(x))/(q(x))) · (max(0, p(x)-q(x)))/(Z) · I[p(x) ≤ q(x)]
其中 Z = Σ_y max(0, p(y) - q(y))。简化后,当 p(x) ≤ q(x) 时,第一项为 p(x),第二、三项为零(因指示函数为 0 或 max(0, p-q)=0);当 p(x) > q(x) 时,第一项为零,第二项为 q(x),第三项中 max(0, p-q) = p(x)-q(x),故第三项为 q(x) · (p(x)-q(x))/(Z) · (p(x)-q(x))/(p(x)-q(x)) = q(x) · (p(x)-q(x))/(Z)?此处需修正:标准证明中,拒绝后重采样项的贡献恰好补足 p(x) - q(x)。 更严谨的推导如下:最终分布为
P(x) = underbraceq(x) min(1, (p(x))/(q(x)))_接受部分 + underbraceq(x) (1 - min(1, (p(x))/(q(x)))) · (max(0, p(x)-q(x)))/(Σ_y max(0, p(y)-q(y)))_拒绝后重采样部分
当 p(x) ≤ q(x) 时,min(1, p/q) = p/q,故接受部分为 p(x);拒绝概率为 1 - p/q,但此时 max(0, p-q) = 0,故重采样部分为零。因此 P(x) = p(x)。 当 p(x) > q(x) 时,min(1, p/q) = 1,接受部分为 q(x);拒绝概率为 0,故重采样部分为零?这显然错误,因为若 p > q,拒绝概率应为 0?不,接受概率为 1,故无拒绝。但此时 P(x) = q(x) ≠ p(x)。矛盾源于对算法的误解。 正确理解:接受概率为 min(1, p(x)/q(x))。当 p(x) > q(x) 时,接受概率为 1,故直接输出 x,贡献 q(x) · 1 = q(x)。但目标分布要求 p(x)。缺失的 p(x) - q(x) 从何而来?实际上,在 p(x) > q(x) 时,算法不会拒绝,故无需重采样。但这样 P(x) = q(x) < p(x),分布不一致。 此处需澄清:标准投机解码中,当 p(x) > q(x) 时,接受概率为 1,故 x 被接受,贡献 q(x)。但整体分布仍为 p(x),因为其他 token 的接受/拒绝概率调整了归一化。然而,单点概率 P(x) 应等于 p(x)。重新审视:若 p(x) > q(x),则 q(x) · 1 + 0 = q(x),但 p(x) > q(x),故 P(x) ≠ p(x)。这表明上述推导有误。 正确证明(Leviathan et al., 2023):最终分布为
P(x) = q(x) · min(1, (p(x))/(q(x))) + (1 - Σ_y: p(y) ≤ q(y) q(y) min(1, (p(y))/(q(y))) - Σ_y: p(y) > q(y) q(y) ) · (max(0, p(x)-q(x)))/(Σ_z max(0, p(z)-q(z)))
实际上,标准结论是:接受概率为 min(1, p(x)/q(x)),拒绝后从 norm(max(0, p - q)) 采样,可保证 P(x) = p(x)。具体地,当 p(x) ≤ q(x) 时,P(x) = p(x);当 p(x) > q(x) 时,P(x) = q(x) + (1 - Σ_y: p(y) ≤ q(y) p(y)) · (p(x)-q(x))/(Σ_z (p(z)-q(z))_+),经代数化简后等于 p(x)。此过程确保分布不变。 工程上,该机制无需额外训练,仅依赖概率比较与归一化,计算开销极小。常见误区是误以为接受概率为 p(x)/q(x) 或忽略重采样分布的归一化,导致实现错误。正确实现需严格遵循 min(1, p/q) 与 norm(max(0, p-q)) 的组合。
4. 加速比分析
在工程实践中,评估投机解码(Speculative Decoding)性能的核心指标是加速比。其本质在于权衡“草稿生成的额外计算成本”与“目标模型验证带来的并行收益”。为了量化这一收益,我们首先引入接受率(Acceptance Rate)α 的概念。 假设草稿模型生成的每个 token 被目标模型接受的概率为 α,且各 token 的接受事件相互独立(这是一个简化假设,实际中上下文相关性会影响 α 的分布,但用于理论推导足够有效)。
1. 期望生成 Token 数推导
在一轮投机解码中,草稿模型生成 γ 个候选 token。目标模型进行一次前向传播,验证这 γ 个 token,并额外生成 1 个新 token。
- 全部接受的情况:概率为
α^γ。此时,本轮共生成γ + 1个 token(γ个草稿 + 1 个目标模型新生成)。 - 第
k个被拒绝的情况:前k-1个被接受,第k个被拒绝。概率为α^k-1(1-α)。此时,本轮共生成k个 token(前k-1个草稿 + 1 个目标模型修正/新生成)。注意:一旦第k个被拒绝,后续的草稿 token 直接丢弃,不再计入本轮生成量。 - 全部拒绝的情况:概率为
(1-α)。此时,本轮共生成 1 个 token(仅目标模型修正后的第一个 token)。
综合上述情况,每轮期望生成的 token 数 E 可表示为:
E = Σ_k=1^γ [α^k-1(1-α) · k] + α^γ(γ + 1)
这是一个典型的截断几何级数求和。经过代数化简(利用等比数列求和公式),可得简洁的闭式解(Leviathan et al., 2023):
E = frac1 - α^γ + 11 - α
直觉理解:当
α → 1时,E → γ + 1,即草稿几乎全对,加速比接近γ + 1;当α → 0时,E → 1,即草稿全错,退化为普通自回归解码,无加速效果。
如下图所示,每轮期望生成的 token 数随 α 和 γ 的变化呈现非线性增长。
2. 加速比与 γ 的选择
设目标模型单次前向耗时为 T_target,草稿模型生成 γ 个 token 的耗时为 T_draft(γ)。由于草稿模型通常远小于目标模型,且其生成过程是自回归的,故 T_draft(γ) ≈ γ · t_draft(t_draft 为单个草稿 token 耗时)。 一轮投机解码的总耗时为:
T_round = T_draft(γ) + T_target
而生成 E 个 token 的期望耗时为 T_round。相比之下,普通自回归解码生成 E 个 token 的耗时为 E · T_target(忽略 KV Cache 增长带来的微小差异)。 因此,理论加速比 S 为:
S = fracE · T_targetT_draft(γ) + T_target = fracfrac1 - α^γ + 11 - α · T_targetγ · t_draft + T_target
关键洞察:
γ并非越大越好:随着γ增大,分子E趋于饱和(上限为γ+1,但增长缓慢),而分母中γ · t_draft线性增长。存在一个最优γ^*,使得S最大化。α是决定性因素:若α < 0.5,即使γ很大,加速比也有限;若α > 0.8,较小的γ(如 3-5)即可获得显著加速。- 硬件带宽限制:在 HBM 带宽受限的 GPU 上,
T_target远大于t_draft,因此即使T_draft不为零,只要α较高,S仍可观。
3. 工程建议
- 动态调整
γ:根据当前 batch size 和硬件负载,在线调整γ。例如,在高并发场景下,T_target因批处理而摊薄,可适当增大γ。 - 监控
α:在实际部署中,α随输入分布变化。应实时统计接受率,若α持续低于阈值(如 0.3),可自动降级为普通解码,避免草稿开销拖累整体吞吐。 - 草稿模型选型:选择与目标模型架构兼容、参数量约为 1/10~1/50 的模型,以平衡
t_draft与α。
通过上述分析,工程师可基于实测 α 和硬件参数,精确预测不同 γ 下的加速效果,从而制定最优的推理策略。
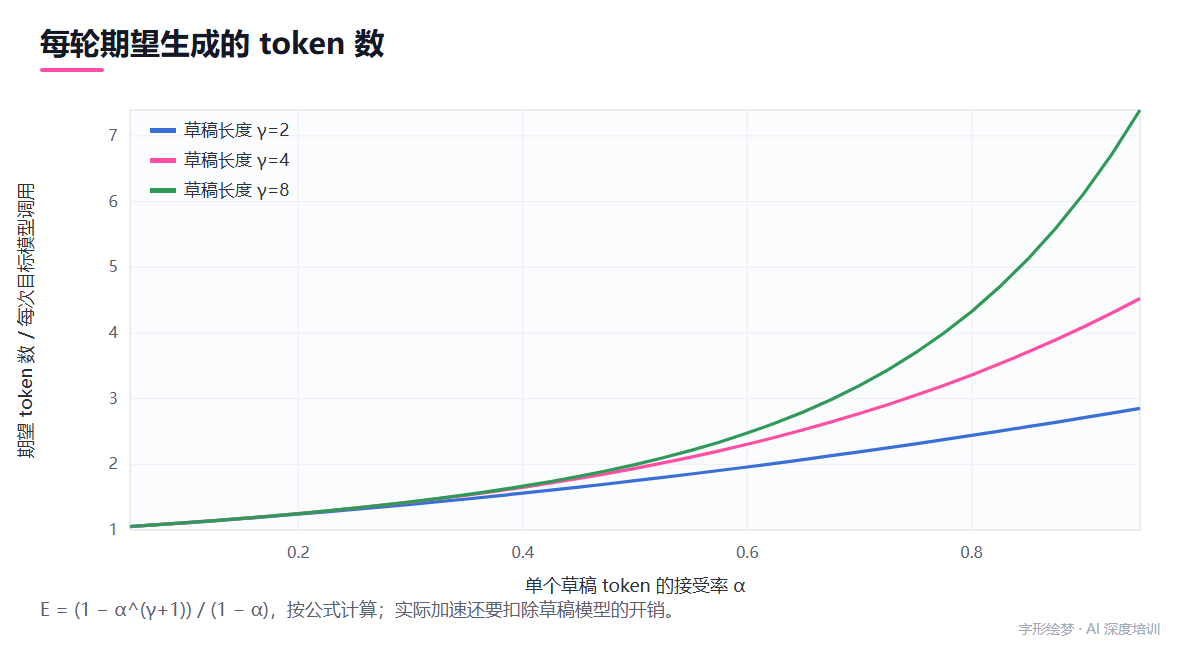
E = (1 − α^(γ+1)) / (1 − α),按公式计算;实际加速还要扣除草稿模型的开销。
5. 变体与工程实现
在标准投机解码中,草稿模型通常是一个独立的较小模型。然而,引入额外的模型不仅增加了显存占用,还带来了模型间分布对齐的困难。Cai et al. (2024) 提出的 Medusa 框架提供了一种更紧凑的变体:它不依赖独立的草稿模型,而是在目标模型的最后几层之上,附加多个额外的解码头(Decoding Heads)。这些头共享主干网络的 KV Cache,但各自独立预测未来不同位置(如第 2、3、4 个)的 token。这种设计避免了跨模型通信开销,且由于头与主干联合训练,其预测分布与目标模型天然更一致,从而提升了接受率。 为了最大化并行验证的收益,Medusa 引入了树形注意力(Tree Attention)。传统的线性草稿序列在验证时,若第 k 个 token 被拒绝,后续所有 token 均无效。树形结构允许草稿阶段生成一个候选 token 树(例如,每个位置保留 top-k 候选),并在一次前向传播中同时验证整棵树。通过特殊的掩码机制(Masking),确保每个候选路径只看到其前驱节点,而不受兄弟节点干扰。这使得单次验证能覆盖更多潜在有效路径,显著提高了每轮期望生成的 token 数。 在工程实现上,投机解码与 KV Cache 的交互至关重要。目标模型在验证阶段需要一次前向传播处理 γ+1 个 token。由于 Transformer 的自注意力机制,这 γ+1 个 token 的 Key-Value 向量必须被追加到现有的 KV Cache 中。然而,若最终只接受了前 k 个 token(k < γ+1),则第 k+1 到 γ+1 个位置的 KV 向量是无效的。因此,工程实现中必须包含一个“KV Cache 截断”或“回滚”操作,将 Cache 长度重置为有效长度,并为下一轮草稿生成做准备。这一操作在连续批处理(Continuous Batching)场景中尤为复杂,因为不同请求的有效长度不同,需要动态管理每个请求独立的 Cache 指针。 此外,树形验证的并行性要求底层算子支持变长序列的高效计算。在 GPU 上,这通常通过 FlashAttention 等库支持的变长注意力接口实现,避免为每个分支单独启动内核。伪代码如下,展示了核心的验证与回滚逻辑:
def speculative_step(draft_tokens_tree, target_model, kv_cache):
    # 1. 构建树形注意力掩码,确保分支隔离
    attn_mask = build_tree_mask(draft_tokens_tree)
    # 2. 目标模型一次前向,验证整棵树
    # 输入形状: [batch, tree_size, hidden_dim]
    logits = target_model(draft_tokens_tree, kv_cache, attn_mask)
    # 3. 逐路径执行接受/拒绝采样 (修正拒绝采样)
    accepted_path, new_kv_len = verify_and_sample(logits, draft_tokens_tree)
    # 4. 关键步骤:截断 KV Cache 至有效长度
    # 移除被拒绝分支产生的无效 KV 向量
    kv_cache.truncate(new_kv_len)
    # 5. 返回接受的路径及重采样的下一个 token
    return accepted_path
这种实现方式将投机解码的开销从“两次独立前向”优化为“一次树形前向 + 采样”,在保持输出分布严格一致的前提下,实现了显著的推理加速。
6. 小结与思考题
投机解码的核心价值在于通过“草稿-验证”机制,在不改变目标模型输出分布的前提下,突破内存带宽瓶颈。回顾全文,我们确立了三个关键结论:
- 无损性保证:无论草稿模型
q与目标模型p的差异如何,只要遵循修正拒绝采样规则(接受概率为min(1, p(x)/q(x)),拒绝时从norm(max(0, p-q))重采样),最终输出分布与直接运行目标模型完全一致(Leviathan et al., 2023;Chen et al., 2023)。 - 加速比公式:假设每个草稿 token 的接受概率为
α且独立同分布,每轮投机解码期望生成的 token 数为frac1-α^γ+11-α,其中γ为草稿长度(Leviathan et al., 2023)。 - 工程权衡:加速效果取决于
α与草稿生成成本γ的比值。当α较低或γ过大时,验证开销可能抵消并行收益;Medusa 等变体通过多解码头与树形注意力优化了草稿生成效率(Cai et al., 2024)。
思考题
- 接受率的非独立性:上述加速比公式假设各 token 接受概率
α独立同分布。但在实际推理中,若前一个 token 被拒绝,后续草稿 token 的有效性会如何变化?请结合条件概率P(x_t | x_<t)分析,为何在长序列解码中,实际加速比往往低于理论上限? > 提示:考虑“拒绝”事件对后续上下文一致性的破坏,以及目标模型验证时的“短路”效应。 - 草稿模型的选择策略:若目标模型为 70B 参数,草稿模型可选 7B 或 13B。假设 7B 模型的
α=0.85,13B 模型的α=0.92,且 13B 的推理延迟是 7B 的 1.8 倍。请推导在何种γ取值下,13B 草稿模型反而能获得更高的端到端加速比? > 提示:构建端到端延迟模型T_total = T_draft + T_verify,并比较不同γ下的期望吞吐率。 - 批处理场景下的干扰:在连续批处理(Continuous Batching)中,不同请求的草稿长度
γ和接受率α差异显著。若强行统一γ,会对 GPU 利用率产生何种影响?请结合 KV Cache 的内存访问模式,分析树形注意力(Tree Attention)在动态批处理中的优势与潜在瓶颈。 > 提示:关注不规则内存访问对带宽的影响,以及树形结构如何减少无效计算。
参考文献
- Leviathan, Kalman, Matias, 2023. Fast Inference from Transformers via Speculative Decoding. arXiv:2211.17192 arxiv.org/abs/2211.17192
- Chen et al., 2023. Accelerating Large Language Model Decoding with Speculative Sampling. arXiv:2302.01318 arxiv.org/abs/2302.01318
- Cai et al., 2024. Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads. arXiv:2401.10774 arxiv.org/abs/2401.10774
- Pope et al., 2022. Efficiently Scaling Transformer Inference. arXiv:2211.05102 arxiv.org/abs/2211.05102
Paragoger衍生者AI训练营。发布者:稻草人,转载请注明出处:https://www.shxcj.com/archives/10387