本文属于《AI 深度培训》系列 · 难度:专家 · 篇幅:约 7000 字
向量检索是 RAG 系统的核心,但高维数据下的精确搜索成本过高。本文深入解析 IVF、PQ 与 HNSW 三大近似最近邻算法,从维度灾难切入,详解聚类、量化压缩及图结构原理。通过剖析召回率与 QPS 的权衡机制,结合参数调优与工程选型策略,助你构建高性能、低延迟的大模型检索基础设施。
1. 导读:为什么需要近似搜索
在大模型应用栈中,向量检索是连接非结构化文本与结构化知识的关键桥梁。无论是 RAG 系统中的文档召回,还是基于嵌入的语义去重,核心任务都是高维空间中的最近邻搜索(Nearest Neighbor Search, NNS)。然而,随着嵌入维度提升(如从 768 维升至 4096 维)及数据规模膨胀至亿级,暴力精确搜索(Brute-Force Exact Search)在计算复杂度和内存占用上均变得不可行。
维度灾难与计算瓶颈
高维空间中的“维度灾难”(Curse of Dimensionality)是近似搜索存在的根本原因。在低维空间中,距离度量具有区分度;但在高维空间中,任意两点间的距离差异趋于消失,导致基于距离的索引结构效率急剧下降。更直接的工程痛点在于计算量:精确搜索需要计算查询向量与数据库中所有向量的距离。若数据库包含 N 个向量,维度为 D,单次查询的时间复杂度为 O(N · D)。当 N=10^8 且 D=1024 时,单次查询涉及约 10^11 次浮点运算,远超 CPU 或 GPU 在毫秒级延迟预算内的处理能力。 因此,工业界普遍采用近似最近邻搜索(Approximate Nearest Neighbor Search, ANN)。其核心权衡在于:牺牲少量的召回率(Recall),换取数量级的查询吞吐量(QPS)提升和内存压缩。
核心指标:召回率@k 与 QPS
评估 ANN 算法性能的两个核心指标是:
- 召回率@k(Recall@k):定义为返回的
k个最近邻中,真正属于精确搜索前k个最近邻的比例。Recall@k = (|ANN\_Result_k cap Exact\_Result_k|)/(k)召回率反映了搜索结果的准确性。在 RAG 场景中,低召回率意味着关键上下文缺失,直接导致大模型幻觉或回答质量下降。 - 查询每秒(QPS, Queries Per Second):系统在单位时间内能处理的查询请求数。 QPS 决定了服务的并发能力和延迟(Latency)。高 QPS 通常意味着更低的平均延迟,但往往以牺牲召回率或增加内存开销为代价。
工程选型的目标是在满足业务对召回率的最低要求(如 Recall@10 > 0.95)前提下,最大化 QPS 并最小化内存占用。
本文路线
本节后续内容将深入解析三种主流的 ANN 算法及其工程实现:
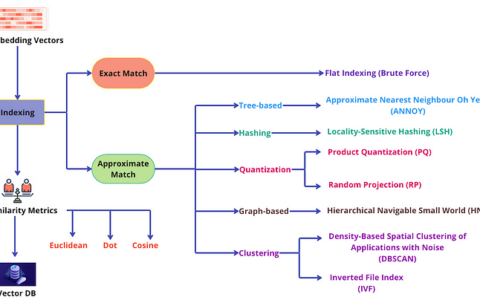
- IVF(Inverted File Index):基于聚类的倒排索引,适合批量处理与内存受限场景。
- PQ(Product Quantization):向量压缩技术,显著降低内存占用,常与 IVF 结合使用。
- HNSW(Hierarchical Navigable Small World):基于图结构的索引,以高召回率和低延迟著称,是当前实时检索的首选。
理解这些算法的原理、参数调优(如 nprobe、efSearch、M)及工程陷阱(如过滤、更新),是构建高性能大模型检索系统的基础。
2. 距离度量与归一化
在向量检索系统中,距离度量不仅是数学定义,更是决定索引结构行为与工程性能的核心约束。对于大模型场景(如 RAG 检索或语义嵌入),理解内积、余弦相似度与欧氏距离(L2)之间的几何等价性,能直接指导数据预处理策略,避免在索引构建阶段引入不必要的精度损失或计算冗余。
三种度量的几何本质
在 d 维欧氏空间中,设查询向量为 q,数据库中的候选向量为 x。三种常用度量定义如下:
- 内积(Inner Product, IP):
IP(q, x) = q · x = Σ_i=1^d q_i x_i
内积衡量两个向量在方向上的对齐程度及模长的乘积。在最大内积搜索(MIPS)中,我们通常寻找 x 使得 q · x 最大。
- 余弦相似度(Cosine Similarity):
Cos(q, x) = (q · x)/(||q|| · ||x||)
余弦相似度仅关注方向,消除了向量模长(norm)的影响。其值域为 [-1, 1],1 表示方向完全一致。
- 欧氏距离(L2 Distance):
L2(q, x) = ||q - x||_2 = sqrtΣ_i=1^d (q_i - x_i)^2
欧氏距离衡量两点在空间中的直线距离。
归一化下的等价性推导
工程中最关键的洞察在于:当所有向量(包括查询向量)都被归一化为单位向量时,这三种度量在排序意义上是等价的。 假设我们对 q 和 x 进行 L2 归一化,得到 q = (q)/(||q||) 和 x = (x)/(||x||)。此时 ||q|| = ||x|| = 1。 首先,归一化后的内积即为余弦相似度:
q · x = (q)/(||q||) · (x)/(||x||) = Cos(q, x)
因此,最大化内积等价于最大化余弦相似度。 其次,考察归一化向量的 L2 距离平方:
||q - x||_2^2 = (q - x) · (q - x)
展开该式:
= q · q - 2(q · x) + x · x
由于 ||q||^2 = 1 且 ||x||^2 = 1,代入得:
= 1 - 2(q · x) + 1 = 2 - 2(q · x)
由此可见,L2 距离的平方与内积呈线性负相关。
- 当内积
q · x最大时,L2 距离最小。 - 当内积
q · x最小时,L2 距离最大。
因此,最小化 L2 距离等价于最大化内积,进而等价于最大化余弦相似度。
工程含义与常见误区
- 归一化是前提:上述等价性依赖于向量模长为 1。如果嵌入模型输出的向量模长差异巨大(例如某些语义强度高的词向量模长较大),直接进行内积搜索会将“模长”误判为“相似度”。此时,若业务逻辑仅关心语义方向(如文本语义检索),必须显式进行 L2 归一化。
- 索引算法的适配:
- HNSW 等基于图的索引通常默认支持 L2 或内积。若使用内积度量,部分实现要求输入向量已归一化,否则图构建时的贪心选择可能偏离最优路径。
- IVF 的聚类中心通常基于 L2 距离计算 k-means。若数据未归一化,聚类中心会偏向模长较大的区域,导致检索偏差。
- 计算效率:在归一化前提下,计算内积(
d次乘法加法)比计算 L2 距离(d次减法、乘法、加法,最后开方)更高效。因此,在归一化场景下,优先选择内积作为底层度量可节省约 20%-30% 的浮点运算开销。 - 误区警示:不要假设所有嵌入模型都输出归一化向量。例如,某些对比学习模型(如 SimCSE)可能在训练后未强制归一化,而另一些(如 Sentence-BERT)可能默认归一化。在构建向量数据库前,务必检查嵌入分布,并在应用层或数据库层统一执行归一化操作。
通过理解这一几何等价性,工程师可以灵活选择向量数据库支持的度量类型,而不必担心底层算法(如 PQ 的查表优化或 HNSW 的图遍历)对特定度量的硬性限制,从而在召回率与 QPS 之间取得最佳平衡。
3. IVF:先聚类再搜
在海量向量检索中,暴力搜索(Brute Force)的时间复杂度与数据规模 N 成正比,无法在毫秒级延迟约束下满足高 QPS 需求。倒排文件索引(Inverted File Index, IVF)是解决这一问题的经典范式,其核心思想是“空间换时间”:通过聚类将高维空间划分为若干局部区域,查询时仅访问与查询向量最相关的少数几个区域,从而将搜索范围从 O(N) 降至 O(N/k · n\_probe)。
3.1 k-means 粗聚类
IVF 的第一阶段是离线训练。给定数据集 D = \x_1, dots, x_N\ ∈ ℝ^N × d,我们使用 k-means 算法将其划分为 k 个簇(Cluster/Voronoi Cell)。每个簇由一个质心(Centroid)c_j 代表,j ∈ \1, dots, k\。 k-means 的目标是最小化簇内平方和误差(Within-Cluster Sum of Squares, WCSS):
J = Σ_j=1^k Σ_x_i ∈ C_j \| x_i - c_j \|^2
其中 C_j 是第 j 个簇的样本集合。算法通过交替执行以下步骤迭代收敛:
- 分配步骤:将每个点
x_i分配给距离最近的质心c_j,即j = argmin_l \| x_i - c_l \|^2。 - 更新步骤:重新计算每个簇的质心为其成员点的均值,
c_j = (1)/(|C_j|) Σ_x_i ∈ C_j x_i。
训练完成后,构建倒排列表(Inverted List):对于每个簇 j,存储属于该簇的所有向量索引及其向量值。这就是“倒排”的含义——从“向量 -> 簇”的正向映射,转变为“簇 -> 向量列表”的反向索引。
工程提示:k-means 对初始质心敏感,且在高维空间中容易陷入局部最优。实践中常采用 k-means++ 初始化策略,并通过多次随机重启(restarts)选取 WCSS 最小的结果作为最终聚类。
3.2 nprobe 控制召回
查询阶段,给定查询向量 q,IVF 执行两步操作:
- 粗量化(Coarse Quantization):计算
q到所有k个质心的距离,找出距离最近的n\_probe个簇。这一步的计算量为O(k · d),由于k通常远小于N(例如k=1000, N=10^7),这一步非常高效。 - 精搜索(Fine Search):在这
n\_probe个簇对应的倒排列表中,对所有向量执行精确的距离计算(如 L2 或内积),并维护一个大小为k的最大堆以获取 Top-k 结果。
n\_probe 是 IVF 中最关键的超参数,它直接权衡了召回率(Recall)与查询延迟(Latency/QPS):
n\_probe较小(如 1 或 2):搜索范围小,QPS 高,但可能遗漏真实最近邻,召回率低。n\_probe较大(如k/10或k):搜索范围大,召回率高,但计算量线性增加,QPS 下降。
召回率@k 定义为:
Recall@k = (|ANN Top-k cap GT Top-k|)/(k)
其中 GT Top-k 是通过暴力搜索得到的真实 Top-k 结果。
3.3 工程含义与常见误区
- 聚类质量至关重要:如果 k-means 聚类不均匀(如某些簇极大、某些极小),即使
n\_probe设置合理,也可能导致部分簇被频繁访问而成为瓶颈,或某些区域完全未被覆盖。此时应考虑调整k值或使用更复杂的聚类算法。 n\_probe并非越大越好:存在一个“拐点”,超过该点后,召回率提升微弱,但 QPS 显著下降。需根据业务对召回率的容忍度(如 95% vs 99%)进行离线调参。- 与 PQ 的结合:纯 IVF 在内存占用上仍较大(需存储原始向量)。实践中常将 IVF 与乘积量化(PQ)结合,形成 IVF-PQ,进一步压缩向量存储,提升缓存命中率(Jégou et al., 2011)。
常见误区:认为
k越大越好。实际上,k过大会导致每个簇内向量过少,聚类边界过细,使得n\_probe需要设置得更大才能达到相同召回率,反而增加了粗量化阶段的计算开销。k的选择需平衡聚类精度与查询效率,经验法则为k ≈ √(N)。
4. 乘积量化 PQ
乘积量化 PQ:向量切成 m 段、每段 256 个中心;非对称距离计算与查表;压缩比
在高维空间中,直接存储和计算全精度浮点向量(如 FP32)不仅占用巨大的内存带宽,还导致 CPU/GPU 缓存命中率低下。乘积量化(Product Quantization, PQ)的核心思想是“分而治之”:将一个高维向量切分为 m 个低维子向量,并对每个子向量独立进行量化(Jégou et al., 2011)。
1. 量化原理与存储结构
假设原始向量 x ∈ ℝ^d,我们将其切分为 m 段,每段维度为 d/m。对于每一段,我们预先训练一个包含 K 个中心的码本(Codebook),通常取 K=256(即 8 bit)。 如下图所示,单个 768 维向量的存储过程如下:
原始向量 x (768 dim, FP32)
├── 子向量 x_1 (12 dim) -> 最近中心 c_{1, 42} -> 编码 42 (1 byte)
├── 子向量 x_2 (12 dim) -> 最近中心 c_{2, 105} -> 编码 105 (1 byte)
├── ...
└── 子向量 x_64 (12 dim) -> 最近中心 c_{64, 7} -> 编码 7 (1 byte)
存储结果: [42, 105, ..., 7] (64 bytes)
通过这种映射,原本需要 768 × 4 = 3072 字节的向量被压缩为 64 字节,压缩比达到 48:1。这使得在有限内存中可以容纳数千万甚至上亿条向量,从而支撑大规模检索。
2. 非对称距离计算(ADC)与查表
PQ 最关键的工程优化在于非对称距离计算(Asymmetric Distance Computation, ADC)。在检索时,查询向量 q 通常保持全精度(FP32),而数据库中的向量 x 已被量化为编码。 直接计算 q 与 x 的欧氏距离需要解码 x,开销巨大。ADC 利用距离的可加性:
||q - x||^2 = ||q - (x_1 + x_2 + ... + x_m)||^2
由于 x_i 被量化为中心 c_i, k_i,我们可以预先计算查询向量每一段 q_i 与所有 K 个中心的距离,构建一个查找表(LUT):
LUT[i][k] = ||q_i - c_i, k||^2
其中 i ∈ [1, m],k ∈ [1, K]。 当需要计算 q 与某个量化向量 x(编码为 k_1, k_2, ..., k_m)的距离时,只需查表并求和:
Dist(q, x) = Σ_i=1^m LUT[i][k_i]
这将距离计算从 O(d) 的浮点运算降低为 O(m) 的查表与加法操作。由于 m 通常远小于 d,且查表操作对 CPU 缓存极其友好,QPS 可获得数量级的提升。
3. 工程含义与误区
- 精度损失:PQ 是有损压缩。召回率取决于码本训练的质量(通常使用 k-means)以及子空间划分的合理性。
- ADC vs SC:另一种方法是 Symmetric Computation(SC),即量化查询向量,直接查两个编码之间的距离表。SC 计算更快,但精度通常低于 ADC,因为查询向量也被量化了。工程上常优先使用 ADC。
- 维度选择:
m不宜过大或过小。m过小导致每个子空间维度太高,量化误差大;m过大导致 LUT 过大,缓存不友好。通常d/m在 8-16 维之间效果较好。
PQ 并非孤立存在,常与 IVF 结合使用(IVF-PQ),先通过 IVF 定位候选集,再用 PQ 快速计算距离,是工业界处理十亿级向量检索的标准方案之一(Johnson et al., 2017)。
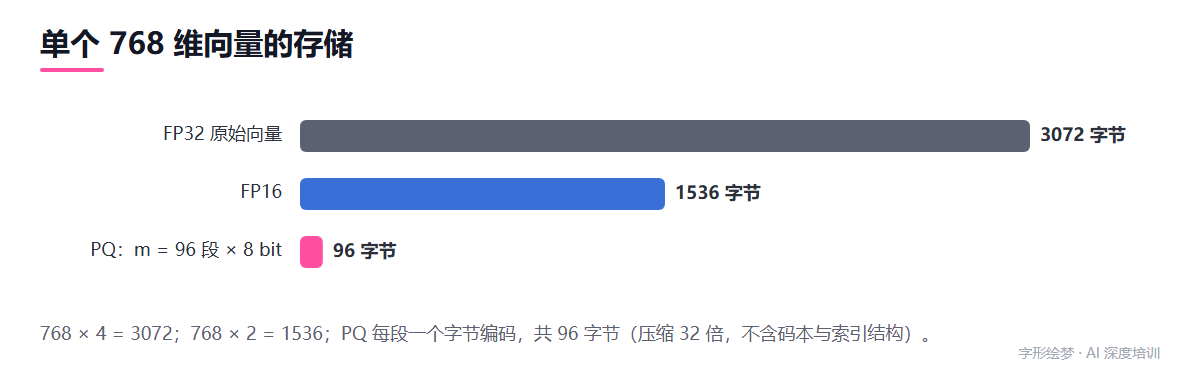
768 × 4 = 3072;768 × 2 = 1536;PQ 每段一个字节编码,共 96 字节(压缩 32 倍,不含码本与索引结构)。
5. HNSW:分层可导航小世界图
HNSW(Hierarchical Navigable Small World)的核心思想是利用“分层小世界图”结构,将高维空间的最近邻搜索转化为图上的贪心路径搜索。与 IVF 的“先聚类后暴力”不同,HNSW 通过构建多层级的邻接图,使得搜索过程具有对数复杂度,且在召回率和延迟之间提供了极佳的平衡(Malkov & Yashunin, 2016)。
层级随机分配与图构建
HNSW 的数据结构是一个多层图。最底层(Layer 0)包含所有数据点,且每个点都维护了丰富的邻居连接;随着层数升高,节点数量呈指数级减少,连接也变得更加稀疏。这种“上层稀疏、下层稠密”的结构模拟了宏观导航与微观探索的结合。 在插入新节点时,首先随机确定其最高层级 l,通常遵循几何分布:
P(l) = (1 - m_l) · m_l^l
其中 m_l 是层级衰减因子(通常取 1/ln M)。这意味着大多数节点只存在于底层,少数节点存在于高层。随后,算法从最高层入口点开始,逐层向下进行贪心搜索,直到找到当前层的最优邻居,并将新节点插入该层的邻接表中。
贪心下降与 ef 候选队列
搜索过程如下图所示。算法从顶层的入口点开始,执行“贪心下降”:在当前层,不断移动到距离查询点更近的邻居,直到局部最优。然后进入下一层,以上一层的最优解作为新的入口点,重复该过程,直至 Layer 0。 在 Layer 0,搜索不再仅仅寻找单个最近邻,而是维护一个大小为 efSearch 的候选队列(Candidate List)和一个大小为 efSearch 的结果队列(Result List)。算法从候选队列中取出距离查询点最近的节点,将其邻居加入候选队列,同时更新结果队列。这一过程持续进行,直到候选队列中的最近节点距离大于结果队列中最远节点的距离。efSearch 越大,搜索范围越广,召回率越高,但延迟也越大。
# 伪代码:HNSW 搜索核心逻辑简化版
def search_hnsw(query, entry_point, ef_search):
    # 1. 从顶层贪心下降至 Layer 0
    current = entry_point
    for layer in range(max_layer, -1, -1):
        while True:
            neighbors = get_neighbors(current, layer)
            next_node = min(neighbors, key=lambda x: dist(x, query))
            if dist(next_node, query) >= dist(current, query):
                break
            current = next_node
    # 2. 在 Layer 0 执行 ef 扩展搜索
    candidates = [current]
    results = []
    while candidates:
        node = pop_nearest(candidates)
        if len(results) < ef_search and dist(node, query) < dist(results[-1], query):
            results.append(node)
            results.sort(key=lambda x: dist(x, query))
        # 将 node 的邻居加入候选队列
        for neighbor in get_neighbors(node, 0):
            if neighbor not in candidates and neighbor not in results:
                candidates.append(neighbor)
    return results[:ef_search]
关键参数解析
HNSW 的性能由三个核心参数控制:
- M(最大邻居数):每个节点在每层中维护的最大邻居数量。M 越大,图越稠密,召回率越高,但内存占用和构建时间显著增加。通常取值范围为 16-64。
- efConstruction(构建时候选队列大小):在插入新节点时,用于确定其邻居的候选队列大小。它直接影响图的连通性和质量。较大的
efConstruction会产生更高质量的图,但构建速度变慢。通常建议efConstruction≥M,且至少为 100。 - efSearch(搜索时候选队列大小):查询时的动态参数。它直接权衡召回率与延迟。
efSearch必须大于k(返回结果数),且通常设置为k的 2-10 倍,具体取决于对召回率的要求。
误区提示:许多工程师误以为
M是固定的,而efSearch是唯一的调优旋钮。实际上,efConstruction对图的最终质量有深远影响。如果efConstruction设置过小,即使efSearch很大,召回率也可能受限,因为图本身可能存在“断连”或“长路径”问题。建议在数据分布变化不大时,优先调整efSearch;若召回率始终无法提升,则需重新构建图并增大efConstruction。
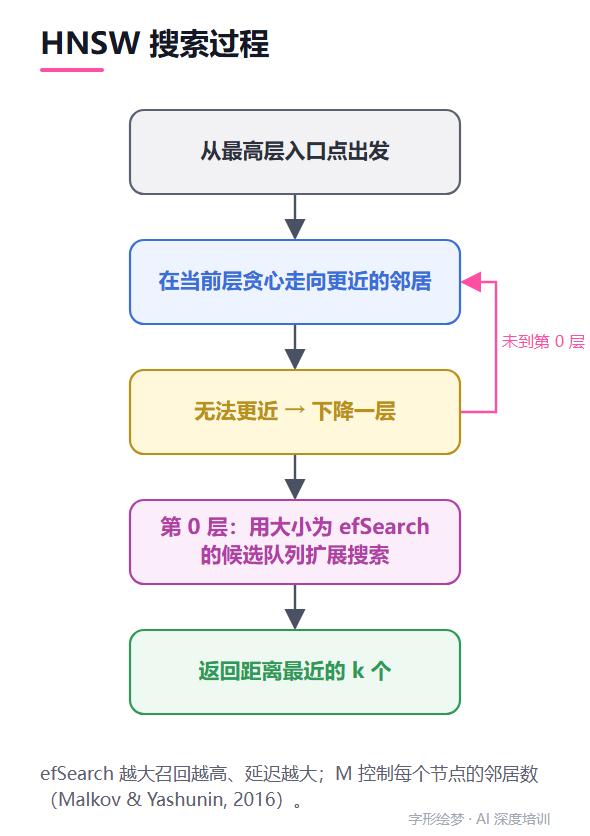
efSearch 越大召回越高、延迟越大;M 控制每个节点的邻居数(Malkov & Yashunin, 2016)。
6. 工程:过滤、更新与选型
在大规模向量检索系统中,索引算法的选择并非孤立的技术决策,而是与数据分布、查询模式及运维约束紧密耦合的系统工程问题。对于专家级工程师而言,理解 IVF、PQ 与 HNSW 的底层机制只是基础,真正的挑战在于如何在高并发、动态数据及复杂过滤条件下保持性能与召回率的平衡。
过滤策略:预过滤与后过滤的权衡
在 RAG 或推荐系统中,查询往往伴随元数据过滤(如 category == 'tech' 或 timestamp > T)。ANN 索引本身并不原生支持结构化过滤,因此需要引入过滤策略。 后过滤(Post-filtering) 是最直观的实现:先执行 ANN 搜索获取 Top-K 候选集,再在应用层根据元数据过滤。
- 优点:实现简单,无需修改索引结构,查询延迟稳定。
- 缺点:当过滤条件选择性极低(即满足条件的数据占比很小)时,Top-K 中可能大量数据被过滤掉,导致最终结果不足 K 个。此时需要扩大搜索范围(增大
nprobe或efSearch),显著增加计算开销,甚至导致召回率下降。
预过滤(Pre-filtering) 则是在搜索前将过滤条件转化为索引内的约束。
- IVF 实现:在聚类中心层面进行过滤。若某个聚类中心对应的簇内大部分数据不满足条件,则跳过该簇。但这要求聚类中心与元数据强相关,否则效果有限。
- HNSW 实现:在图遍历过程中,仅访问满足过滤条件的节点。这可能导致图路径断裂,因为原本作为“桥梁”的节点可能被过滤掉,迫使搜索算法进行更广泛的回溯或扩展,极端情况下退化为全图搜索。
工程建议:若过滤条件选择性高于 10%,后过滤通常更高效;若低于 1%,预过滤或专用过滤索引(如基于位图或倒排索引的混合检索)是必要选择。
动态更新:删除与重建
向量数据库通常不支持原地更新(In-place Update),因为向量嵌入一旦生成,其语义位置即固定。 删除操作:
- 逻辑删除:标记向量 ID 为无效。在搜索时跳过这些 ID。优点是 O(1) 时间复杂度,但长期积累会导致索引膨胀,搜索时需遍历更多无效节点,降低 QPS。
- 物理删除:从索引结构中移除节点。对于 HNSW,移除节点会破坏图的连通性,需要重新连接邻居,计算成本高且易引入偏差;对于 IVF,需从对应簇的量化码本中移除,可能影响码本质量。
重建策略: 当逻辑删除比例超过阈值(如 20%-30%)或数据分布发生显著漂移时,应触发后台重建。
- IVF/PQ:重新运行 k-means 聚类并更新码本。这是最彻底的重建,能恢复最优召回率,但耗时较长,需支持双缓冲切换。
- HNSW:通常通过增量插入新数据并定期执行“图优化”(Graph Optimization)来修复连通性,而非完全重建。
选型指南
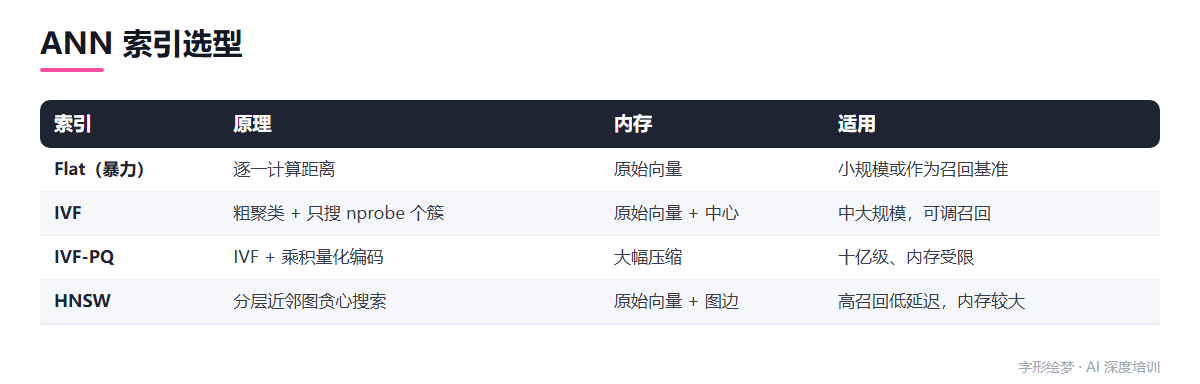
如下图所示,不同索引算法在维度、数据规模、更新频率及硬件资源下的表现差异显著。
| 维度/场景 | IVF + PQ | HNSW | 纯暴力搜索 (Brute Force) |
|---|---|---|---|
| 数据规模 | 亿级 (10⁸+) | 百万至千万级 (10⁶-10⁷) | 万级以下 (10⁴) |
| 内存占用 | 极低 (压缩 32-64 倍) | 高 (需存储完整向量 + 图结构) | 低 (仅向量) |
| 查询延迟 | 中等 (受 nprobe 影响) | 低 (通常 < 10ms) | 高 (线性扫描) |
| 构建时间 | 长 (k-means 迭代) | 长 (图构建复杂) | 无 |
| 动态更新 | 支持 (需定期重聚类) | 支持 (增量插入) | 支持 |
| 适用硬件 | CPU/GPU (Jégou et al., 2011) | CPU/GPU (Malkov & Yashunin, 2016) | GPU (Johnson et al., 2017) |
选型决策树:
- 数据量 < 10 万:直接使用暴力搜索,配合 GPU 加速(Johnson et al., 2017),避免索引维护成本。
- 数据量 10 万 – 1000 万,高 QPS,低延迟:首选 HNSW。其图结构在 CPU 上表现优异,且无需量化损失。
- 数据量 > 1 亿,内存受限:首选 IVF + PQ。通过量化压缩大幅降低内存占用,适合大规模离线或近线检索。
- 高维向量(>1024 维):HNSW 性能随维度增加下降较快,IVF + PQ 更具优势,因为 PQ 将高维分解为低维子空间,计算复杂度可控。
常见误区:认为 HNSW 总是优于 IVF。实际上,在超大规模、内存敏感场景下,IVF + PQ 的压缩比和 GPU 并行能力使其成为更优解。反之,在小规模、高实时性场景下,HNSW 的无量化损失和稳定延迟更受青睐。
7. 小结与思考题
向量数据库的核心在于平衡精度(Recall)与效率(QPS),而这一平衡主要通过三种算法架构实现:IVF、PQ 和 HNSW。 关键结论回顾:
- 距离度量基础:在向量归一化后,余弦相似度、内积与 L2 距离在排序上具有一致性。工程上通常通过归一化将余弦搜索转化为内积搜索,以利用硬件加速。
- IVF(倒排文件索引):本质是“先聚类,后搜索”。通过 k-means 将空间划分为 Voronoi 单元,搜索时仅遍历
nprobe个最近的聚类中心对应的桶。其核心权衡在于:nprobe越大,召回率越高,但 QPS 线性下降。 - PQ(乘积量化):一种压缩技术而非独立索引。它将高维向量切分为
m个子向量,每个子向量独立量化为 8-bit 码字(对应 256 个中心)(Jégou et al., 2011)。通过预计算非对称距离表(ADC),将距离计算转化为查表操作,极大降低内存带宽压力。 - HNSW(分层可导航小世界图):一种基于图的索引。它构建多层图结构,上层稀疏用于快速定位大致区域,下层稠密用于精确搜索。搜索过程是从顶层入口点开始,逐层贪心下降,利用
ef参数控制候选队列大小以平衡速度与召回(Malkov & Yashunin, 2016)。 - 工程选型:
- 静态数据、高召回:首选 HNSW。
- 内存受限、海量数据:IVF + PQ 组合。
- 动态更新:HNSW 支持增量插入但删除较复杂;IVF 需定期重建聚类中心。
思考题:
- PQ 的精度损失与 ADC 机制
- 问题:乘积量化通过独立量化子向量引入了误差累积。请解释为什么“非对称距离计算”(Asymmetric Distance Computation, ADC)比“对称距离计算”(SDC)在检索精度上通常更优?在 ADC 中,查询向量为何保持原始精度,而库向量被量化?
- 提示:思考查询向量与库向量的角色差异,以及量化误差对最终排序结果的影响路径。
- HNSW 的参数敏感性
- 问题:在 HNSW 中,
efConstruction和efSearch是两个关键参数。如果将efConstruction从 100 提升到 200,对索引构建时间、内存占用以及最终检索时的efSearch需求会产生什么影响?为什么有时即使efSearch设置得很高,召回率仍无法达到 100%? - 提示:分析图结构的连通性与“局部最优陷阱”,以及构建时的图质量对搜索路径探索空间的影响。
- 混合过滤场景下的索引失效
- 问题:假设你使用 HNSW 索引,并需要对向量进行属性过滤(如
category = "tech")。如果过滤条件非常严格(仅保留 1% 的数据),为什么“后过滤”(Post-filtering)策略可能导致召回率急剧下降?“预过滤”(Pre-filtering)策略在 HNSW 上实现时面临的主要挑战是什么? - 提示:考虑图搜索的连续性假设与过滤导致的图结构断裂,以及预过滤如何改变图的拓扑结构。
参考文献
- Jégou, Douze, Schmid, 2011. Product Quantization for Nearest Neighbor Search. IEEE TPAMI
- Johnson, Douze, Jégou, 2017. Billion-scale Similarity Search with GPUs. arXiv:1702.08734 arxiv.org/abs/1702.08734
- Malkov & Yashunin, 2016. Efficient and Robust Approximate Nearest Neighbor Search Using Hierarchical Navigable Small World Graphs. arXiv:1603.09320 arxiv.org/abs/1603.09320
- Karpukhin et al., 2020. Dense Passage Retrieval for Open-Domain Question Answering. arXiv:2004.04906 arxiv.org/abs/2004.04906
Paragoger衍生者AI训练营。发布者:稻草人,转载请注明出处:https://www.shxcj.com/archives/10427